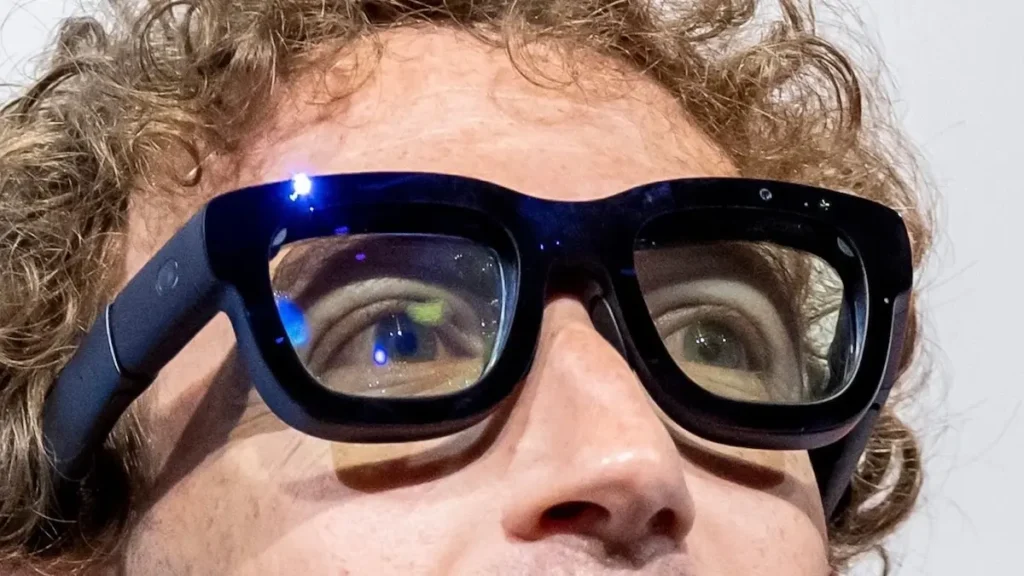
Quando li a notícia no Sapo.pt sobre os novos óculos da Meta sem câmaras, minha primeira reação foi: finalmente alguém entendeu que o problema dos wearables nunca foi tecnologia — era confiança. E como dev, isso me interessa mais do que specs brutas. Vou destrinchar o que o modelo Luna significa de verdade para quem constrói software, integra APIs de IA e lida com edge computing no dia a dia.
Por que remover a câmara é, na prática, uma jogada de arquitetura
Segundo o Sapo.pt, o projeto Luna abandona os sensores fotográficos e aposta tudo em voz. Não é uma simplificação preguiçulta. É uma decisão arquitetural que muda completamente o pipeline de dados. Câmaras geram frames contínuos que precisam ser processados, comprimidos, enviados à nuvem ou inferidos localmente — tudo isso consome bateria, gera calor e, principalmente, cria uma superfície de ataque de privacidade enorme. Seis microfones e um botão físico mudam o jogo: o dispositivo fica em modo passivo até você decidir falar.
Na minha experiência construindo interfaces conversacionais, percebo que voz pura é muito mais barata de processar que visão computacional. Um stream de áudio de 16kHz mono consome entre 32 e 64 kbps. Um stream de vídeo 720p consome megabits por segundo. Essa diferença de três ordens de magnitude redefine o que dá para fazer on-device.
O que isso significa para quem programa assistentes de IA
O Luna roda com o assistente interno da Meta e o agente de consumo Muse. Isso me faz pensar imediatamente no futuro dos SDKs de voz. Quando o hardware decide unilateralmente remover um modal, os devs que já construíram pipelines multimodais precisam se adaptar rápido. Se você apostou em Computer Vision nos óculos Ray-Ban Meta atuais, sua stack vai precisar de uma pivotagem.
Comparação técnica: Luna vs. concorrentes diretos
Vamos colocar os números lado a lado para entender onde o Luna se posiciona:
| Dispositivo | Modal principal | Mic | Processamento | Privacidade |
|---|---|---|---|---|
| Meta Luna | Voz + botão físico | 6 | Provavelmente cloud + edge | Alta (sem captura visual) |
| Humane AI Pin | Voz + projetor laser | 4 | Edge (Snapdragon) | Média |
| Rabbit R1 | Voz + tela pequena | 2 | Cloud (LAM) | Baixa (dados na nuvem) |
| Ray-Ban Meta | Câmara + voz | 5 | Cloud + edge | Baixa (câmaras sempre ativas) |
| Apple Vision Pro | Visão + mão + voz | 6 | Edge (M2 + R1) | Alta (on-device) |
Repare que o Luna é o único que abdica completamente de output visual. Isso é uma escolha radical. Sem tela, sem projetor, sem LED de feedback visual. Toda a interação volta para o canal auditivo e para o tato (botão). Isso obriga os devs a repensar feedback loops — você não pode simplesmente mostrar um JSON, precisa narrar o resultado.
Na Prática: como construir para um dispositivo voice-only
Vamos supor que a Meta libere uma SDK para o Luna. Como você adaptaria um assistente tradicional para funcionar só com voz? Aqui vai um exemplo funcional em Python usando WebSockets para simular o pipeline:
import asyncio
import websockets
import json
from collections import deque

class VoiceOnlyAssistant:
    """
    Arquitetura simplificada para um assistente
    voice-first em wearable sem display.
    """

    def __init__(self):
        self.audio_buffer = deque(maxlen=48000)  # 3s a 16kHz
        self.is_listening = False
        self.context_window = []
        self.MAX_CONTEXT_TOKENS = 800  # Memória curta

    async def on_button_press(self, websocket):
        """Ativação manual — o equivalente ao botão físico."""
        self.is_listening = True
        await websocket.send(json.dumps({
            "event": "listening_started",
            "timestamp": asyncio.get_event_loop().time()
        }))
        return self.is_listening

    async def stream_audio_to_stt(self, audio_chunk):
        """Envia chunk de áudio para STT (Whisper, por ex)."""
        # Em produção: chamada à API ou modelo local
        # Aqui simulamos a transcrição
        if len(self.audio_chunk := audio_chunk.getbuffer()) > 16000:
            transcript = await self.transcribe(audio_chunk)
            return transcript
        return None

    async def build_voice_response(self, intent: dict):
        """
        Constrói resposta otimizada para ser FALADA,
        não lida. Diferença crucial.
        """
        # Erro comum: devolver parágrafos longos
        # Correto: frases curtas, ritmo natural
        response_text = intent.get("answer", "Desculpe, não entendi.")

        # Compressão semântica para caber em áudio curto
        if len(response_text) > 200:
            response_text = self.summarize_for_speech(response_text)

        # SSML para pausas e ênfase (TTS engines suportam)
        ssml = f"""
        <speak>
            <break time="200ms"/>
            {response_text}
            <break time="400ms"/>
            Posso ajudar com mais alguma coisa?
        </speak>
        """
        return ssml

    def summarize_for_speech(self, text: str) -> str:
        """Reduz texto para o essencial falado."""
        sentences = text.split('. ')
        # Mantém só as duas frases mais importantes
        return '. '.join(sentences[:2]) + '.'

    async def handle_intent(self, transcript: str):
        """Roteia intenção para o agente correto."""
        self.context_window.append(transcript)

        # Janela de contexto deslizante — crucial em voice-only
        total = sum(len(t.split()) for t in self.context_window)
        while total > self.MAX_CONTEXT_TOKENS:
            self.context_window.pop(0)
            total = sum(len(t.split()) for t in self.context_window)

        # Roteamento simples (em produção: classifier)
        if "comprar" in transcript.lower():
            return await self.route_to_muse(transcript)
        elif "explicar" in transcript.lower():
            return await self.route_to_llm(transcript)
        else:
            return {"answer": "Pode repetir de outro jeito?"}

# Uso:
# assistant = VoiceOnlyAssistant()
# await assistant.on_button_press(websocket)
# response_ssml = await assistant.build_voice_response(intent)
O ponto-chave aqui é a função build_voice_response. Quando você não tem tela, não dá para colar blocos de texto no usuário. Cada resposta precisa ser densamente informativa em poucas palavras — uma habilidade que a maioria dos devs não treina, porque estamos acostumados a interfaces ricas.
Erros Comuns que devs cometem em interfaces voice-only
Testei várias arquiteturas de voz em produção e esses são os erros que mais matam projetos:
1. Confundir latência de STT com latência total
Devs acham que o gargalo é transcrição. Na real, o pior vilão é o round-trip de decisão do modelo. Se seu pipeline é STT → LLM → TTS, cada etapa adiciona entre 200ms e 2s. Some tudo e o usuário acha que o dispositivo travou. A solução é paralelizar e usar streaming TTS (tipo o do ElevenLabs) que começa a falar antes do LLM terminar a resposta completa.
2. Ignorar beamforming dos arrays de microfones
Seis microfones não são overkill. Eles permitem beamforming direcional — isolar a voz do usuário do ruído ambiente. Mas isso só funciona se o firmware estiver bem calibrado. Quando programei um prototipo com array de 4 mics, descobri que o ângulo de captação precisa ser treinado por usuário. Pular essa etapa resulta em comandos mal interpretados em ambientes barulhentos — cafeteria, escritório open space.
3. Esquecer do estado de conversação
Em interfaces visuais, o histórico fica na tela. Em voice-only, você precisa gerenciar contexto explicitamente. Já vi assistentes que perguntam “Qual produto?” três vezes seguidas porque não mantêm o slot filling corretamente. Use uma estrutura tipo máquina de estados finita, não só append de mensagens:
class ConversationState:
    INTENT_NEW = "new"
    INTENT_AWAITING_CLARIFICATION = "awaiting"
    INTENT_RESOLVED = "resolved"

    def __init__(self):
        self.slots = {}
        self.intent = None
        self.state = self.INTENT_NEW

    def update(self, user_input: str) -> str:
        if self.state == self.INTENT_AWAITING_CLARIFICATION:
            # Não reseta contexto!
            self.slots.update(self.extract_slots(user_input))
            return self.continue_flow()
        else:
            self.intent = self.classify_intent(user_input)
            self.slots = self.extract_slots(user_input)
            return self.start_flow()
4. Subestimar a importância do botão físico
O botão do Luna não é decoração. É uma salvaguarda de privacidade e um marcador de intenção. Sem ele, o dispositivo precisa de wake-word detection sempre ativo — o que consome bateria e cria ambiguidade. Quando você projetar para esses devices, sempre que possível use o botão como trigger primário. Wake-word deve ser fallback.
Implicações para devs: o que muda no seu workflow
Se você trabalha com IA aplicada, precisa se preparar para um futuro em que o input primário deixa de ser teclado e mouse. Algumas mudanças práticas:
- Prompts vão virar scripts conversacionais: em vez de gerar markdown, você vai gerar SSML com pausas, ênfases e tons.
- Testes vão precisar de áudio: fixtures de texto não bastam. Você vai testar com arquivos WAV reais, diferentes sotaques, ruído de fundo.
- Métricas mudam: em vez de CTR, você mede completion rate de comandos falados e taxa de interrupção (quando o usuário corta o assistente no meio).
- Edge AI volta com força: rodar Whisper-tiny ou modelos Phi locais reduz latência e privacidade. Espera ver mais chips neurais dedicados em 2026.
O evento Meta Connect e o que esperar
O Meta Connect acontece na próxima semana em Menlo Park. Historicamente, a empresa usa o palco para revelar hardware com pompa — o Ray-Ban Meta original foi anunciado lá. Minha aposta: o Luna vai ser posicionado não como competidor do Vision Pro, mas como evolução dos óculos atuais. A Meta quer capturar o mercado de wearables do dia a dia, não o de imersão.
Para nós, devs, isso significa provavelmente uma SDK de voz mais robusta e talvez APIs públicas para Muse. Fique atento ao Meta Quest Developer Hub — eles costumam atualizar as ferramentas de devs em paralelo aos anúncios de hardware.
FAQ — Perguntas que devs realmente fazem
O Luna substitui os Ray-Ban Meta atuais?
Não. O Luna é uma linha paralela, mais barata e focada em privacidade. Os atuais continuam sendo atuais, virados para criadores que precisam de captura visual.
Dá para desenvolver para o Luna sem hardware físico?
Provavelmente sim. Quando o Ray-Ban Meta SDK foi lançado, havia um emulador e APIs que funcionavam via Wi-Fi. Espere algo parecido para o Luna.
Vale a pena aprender beamforming agora?
Sim. É uma habilidade com demanda crescente em smart speakers, hearables e dispositivos médicos. Bibliotecas como Pyroomacoustics e o Microsoft Spatial Audio dão um bom começo.
Voice-first mata as interfaces gráficas?
Não. Mas obriga repensar quando cada modal é apropriado. Texto denso ainda é melhor lido que falado. A regra é: voz para entrada rápida e conversacional, texto para referência e visualização.
O Museu (Muse) será aberto para devs externos?
Histórico da Meta sugere que sim, com delay. O Llama foi aberto quase dois anos depois do lançamento interno. Espere algo similar com o agente Muse — primeiro API fechada para parceiros, depois release pública.
Se você chegou até aqui, minha leitura é que a Meta está fazendo a aposta mais inteligente tecnicamente: cortar o modal que mais assusta usuários e focar no que ainda funciona bem — voz. Como dev, isso te força a sair da zona de conforto de UIs ricas e dominar arquiteturas conversacionais. É uma skill que vai separar profissionais nos próximos dois anos.
📰 Ler fonte original no Sapo.pt
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto. Quer que eu faça um hands-on do SDK quando lançar? Comenta aqui.