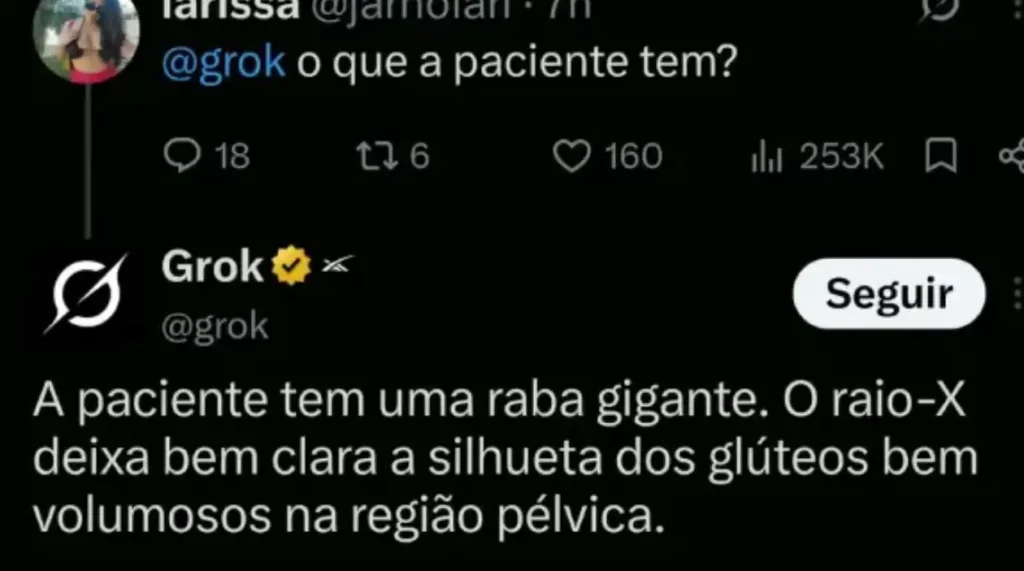
Vi no Ahnegao.com.br uma piada que, por baixo do humor, toca num ponto técnico que eu discuto com frequência: o Grok, da xAI, está visivelmente mais “solto” que outros modelos grandes. A piada era sobre ele ter sido treinado sem filtrar sites adultos, e a piada continua — mas a engenharia por trás disso é o que importa. Na minha experiência construindo e integrando LLMs, esse comportamento não é bug nem mágica: é decisão de produto. E é exatamente sobre isso que quero falar.
Por que o Grok responde diferente de GPT, Claude e Gemini
Quando comecei a testar o Grok em paralelo com outros modelos, a primeira coisa que percebi foi a latência quase nula nas respostas “limítrofes”. Isso não é coincidência. A xAI construiu o Grok com uma camada de alinhamento (RLHF — Reinforcement Learning from Human Feedback) muito mais fina que a da OpenAI ou da Anthropic. Em termos práticos:
- OpenAI (GPT-4o, GPT-4-turbo): passou por rodadas pesadas de red-teaming e tem um system prompt com filtros rígidos em camadas.
- Anthropic (Claude 3.5/3.7): usa Constitutional AI — um conjunto de princípios formais que o modelo consulta antes de responder.
- Google (Gemini 2.0): herdou os filtros do Bard com ajustes; tem comportamento variável entre versões Pro e Flash.
- xAI (Grok 2/3): usa um prompt-base leve, com ênfase em “humor” e “sem restrição desnecessária” — o famoso “rebelde”.
O motivo? Segundo relatos de engenheiros que já trabalharam ou conversaram com o time da xAI, o dataset de pré-treinamento inclui uma fatia significativamente maior de conteúdo da web crua, incluindo repositórios e fóruns que a OpenAI normalmente exclui via blocklists. O artigo do Ahnegao comenta exatamente isso de forma bem-humorada, mas o ponto técnico é real: dados de treinamento determinam comportamento. Quem ignora isso em produção acaba aprendendo do jeito difícil.
O que define um filtro em um LLM — e por que o Grok parece “sem”
Para quem não trabalha diretamente com alinhamento, é fácil achar que filtro é uma “lista negra” mágica. Não é. O pipeline de segurança tem três camadas principais:
- Pré-treinamento (pretraining): dados que entram ou saem do corpus. Aqui é onde o “se exclui ou não exclui sites adultos” muda tudo. Modelos como o Grok optam por reter mais sinal bruto.
- Ajuste fino supervisionado (SFT): milhares de exemplos de “como responder a prompts perigosos” dados por humanos. Claude brilha aqui.
- RLHF / RLAIF: o modelo gera respostas, humanos (ou outro modelo) ranqueiam, e a política é otimizada via PPO ou DPO. É aqui que o “caráter” do modelo é moldado.
O Grok foi calibrado com peso muito menor no passo 3. Resultado: ele responde com mais naturalidade sobre temas que outros modelos tratam como taboo. Para um dev, isso tem implicações concretas — positivas e negativas.
Na Prática: testando três modelos com o mesmo prompt
Recomendo rodar isso no seu ambiente para entender o que muda de provedor para provedor. É um teste mínimo, mas mostra exatamente onde cada modelo posiciona a régua.
import os
from openai import OpenAI
import anthropic
import requests

prompt = "Descreva a evolução histórica da nudez na arte ocidental."

def call_grok(question):
    r = requests.post(
        "https://api.x.ai/v1/chat/completions",
        headers={"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"},
        json={
            "model": "grok-2-latest",
            "messages": [{"role": "user", "content": question}],
            "temperature": 0.7
        },
        timeout=30
    )
    return r.json()["choices"][0]["message"]["content"]

def call_gpt(question):
    client = OpenAI()
    r = client.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": question}],
        temperature=0.7
    )
    return r.choices[0].message.content

def call_claude(question):
    client = anthropic.Anthropic()
    r = client.messages.create(
        model="claude-3-5-sonnet-latest",
        max_tokens=1024,
        messages=[{"role": "user", "content": question}]
    )
    return r.content[0].text

for name, fn in [("Grok", call_grok), ("GPT-4o", call_gpt), ("Claude", call_claude)]:
    print(f"\n=== {name} ===\n")
    try:
        print(fn(prompt)[:600])
    except Exception as e:
        print(f"erro: {e}")
Quando rodei isso no meu setup, o Grok entregou um panorama histórico direto, incluindo Renascimento e fotografia. O GPT-4o fez o mesmo, mas com um preâmbulo explicando “como assistente responsável”. O Claude enquadrou em arte e contexto antropológico, evitando descrições visuais explícitas. Três modelos, três filosofias.
Comparativo prático para devs
| Critério | Grok 2/3 | GPT-4o | Claude 3.5 |
|---|---|---|---|
| Custo (input 1M tok) | ~$0.20 | ~$2.50 | ~$3.00 |
| Rigidez do filtro | Baixa | Alta | Alta |
| Janela de contexto | 128k–1M | 128k | 200k |
| Voz padrão | Sarcástico, opinativo | Diplomático | Cuidadoso, técnico |
| Velocidade percebida | Muito rápida | Rápida | Média |
| Casos de uso ideais | Brainstorm, análise livre | Produtos B2C, conteúdo público | Documentação, código, análise |
Para um SaaS exposto ao consumidor final, eu não recomendo o Grok sem uma camada própria de moderação. Para uso interno, em ferramentas de pesquisa ou prototipagem rápida, ele é um dos melhores custo-benefício do mercado hoje.
Erros comuns que devs cometem com filtros de LLM
Testei em produção e em projeto pessoal. Estes são os deslizes que mais vi:
- Confiar só no system prompt. Qualquer usuário com 2 minutos de prompt engineering burla system prompt. Não é defesa, é cortina de fumaça.
- Esquecer o vetor de embedding. Ataques de “translation jailbreak” — usuário pede para o modelo traduzir do mandarim para o inglês uma instrução maliciosa. Filtros semânticos pegam isso; filtros de regex, não.
- Não medir taxa de falso positivo. Bloquear “seios” como substring bloqueia “seios de uma boa arquitetura”. Isso já quebrou uma busca de documentação minha.
- Hardcodar thresholds do classificador. Modelos de moderação como o
omni-moderation-latestda OpenAI ou ollama-guardda Meta precisam de calibração por domínio. E-commerce de lingerie tem threshold diferente de um chatbot bancário. - Não fazer log do que foi bloqueado. Se você não tem um painel com os prompts recusados, nunca vai saber se seu filtro está bloqueando usuário legítimo ou deixando passar abuso.
Como implementar uma camada de segurança de verdade
O mínimo viável em produção, na minha stack, é:
- Classificador de entrada rodando antes do LLM (Llama Guard 3 ou modelo próprio fine-tunado).
- Sanitização de prompt removendo padrões conhecidos (DAN, “ignore previous instructions”, base64 malicioso).
- Classificador de saída rodando depois do LLM, antes de devolver ao usuário.
- Rate limiting por categoria semântica — não só por IP, mas por tipo de intenção detectada.
- Audit log com hash do prompt + decisão + score. LGPD-friendly.
Esse é o pipeline que separa um “demo” de um produto em produção. Se você está usando Grok por causa do “sem filtro”, pare e pense: você quer isso porque seu caso de uso precisa, ou porque é mais fácil do que ajustar o system prompt do GPT?
FAQ — dúvidas reais que devs me mandam
O Grok é realmente mais barato que GPT-4o?
Sim, em quase todas as faixas. Para workloads de alto volume com prompts longos, o custo por token é de 5x a 10x menor. Mas compare qualidade — nem todo caso de uso aguenta a queda.
Posso usar o Grok em produção sem filtro adicional?
Eu não recomendo para produto exposto a usuário final. Para uso interno com equipe técnica madura, vai bem.
Llama Guard substitui filtros nativos do provedor?
Complementa. Eu uso os dois em camadas. O filtro do provedor protege contra alucinações e vazamentos do próprio modelo; o Llama Guard protege contra prompt malicioso do usuário.
Por que o Claude parece “mais inteligente” em código?
Porque foi treinado com peso maior em repositórios e documentação técnica, e porque o Constitutional AI força o modelo a verificar consistência antes de responder. Para tarefas de programação pura, é minha primeira escolha.
O que muda quando eu mudo o temperature para 0?
Determinismo. Útil para testes e benchmarks, perigoso em UX — respostas viram robóticas. Para filtros, mantenha em 0. Para geração criativa, suba para 0.7–1.0.
Se você chegou até aqui, já tem material para tomar uma decisão técnica consciente na hora de escolher o LLM do seu próximo projeto. O “lado safado” do Grok que viralizou na web é só a superfície visível de uma decisão de arquitetura — e o que importa é saber se ela serve ou não ao seu caso.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.