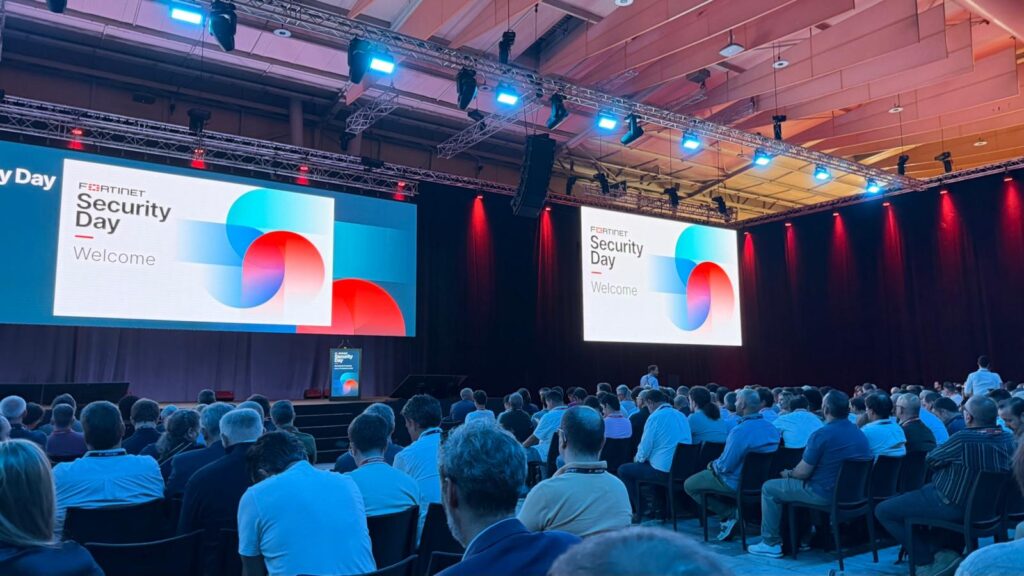
Soberania digital, IA e cibersegurança: o que o Fortinet Security Day 2026 realmente me ensinou
Estive acompanhando a cobertura do Fortinet Security Day 2026 no Sapo.pt e o que me chamou atenção não foi o evento em si — foram os números. Mais de 1.300 profissionais reunidos em Lisboa para debater três temas que, na minha visão de dev sênior, estão colados: soberania digital, inteligência artificial e cibersegurança. Não dá pra discutir um sem tocar nos outros dois. E isso muda completamente a forma como a gente escreve código, configura infra e escolhe ferramentas.
Segundo o Sapo.pt, o evento marcou os 15 anos da Fortinet em Portugal e trouxe apresentações como a de Marcelo Carvalheira (Country Manager) e Filippo Cassini, além de mesas-redondas sobre o impacto da IA no ecossistema digital português. Mas o ponto que mais ressoa pra quem programa é outro: a forma como cloud, SaaS e dispositivos não gerenciados estão diluindo o perímetro de segurança. Vou destrinchar isso com profundidade técnica.
O fim do perímetro tradicional — e por que isso importa pra você
Filippo Cassini destacou um problema que eu vejo na pele todo dia: a explosão de aplicações cloud, SaaS e dispositivos de colaboradores que estão fora do controle do time de TI. Traduzindo para a realidade de dev: cada vez que você usa um SaaS não autorizado pra rodar uma PoC, abre uma porta que ninguém está vigiando.
Na minha experiência, já vi projetos sérios vazarem credenciais justamente porque alguém usou um Notion pessoal pra compartilhar uma API key, ou um Replit pra testar um scrapler que ninguém homologou. O Fortinet chama isso de “shadow IT” — e em 2026, com IA generativa, isso piorou absurdamente.
IA como arma e escudo: o novo campo de batalha
O evento também abordou o papel dos agentes autônomos de IA na cibersegurança. A ideia central é boa: integrar fontes de dados heterogêneas pra detectar, classificar e responder incidentes automaticamente. Isso libera o time de segurança pra focar no que realmente importa.
Mas cuidado com essa armadilha: agentes autônomos mal configurados viram vetor de ataque. Já vi casos onde um LLM com permissões excessivas acabou expondo logs internos ou executando comandos não intencionais. Quando uso agentes no meu fluxo, sempre sigo três regras:
- Princípio do menor privilégio — o agente só vê o que precisa pra tarefa.
- Sandboxing agressivo — execução isolada, sem acesso direto à rede de produção.
- Auditoria contínua — todo output do agente é logado e revisável.
Na Prática: como implementar um agente de segurança com IA em produção
Vou mostrar um exemplo real que apliquei num projeto de monitoramento de logs. A ideia é simples: usar um LLM local (ou endpoint privado) pra classificar eventos suspeitos e disparar alertas. Sem mandar dados pra APIs públicas.
import os
import json
import requests
from datetime import datetime

# Configuração do agente de classificação
AGENT_ENDPOINT = os.getenv("SECURITY_AGENT_URL", "http://localhost:11434/api/generate")
MODEL = "llama3.1:8b-instruct"

def classify_event(event: dict) -> dict:
    """Classifica um evento de segurança usando um agente IA local."""
    prompt = f"""
    Você é um analista SOC (Security Operations Center).
    Classifique o evento abaixo em UMA das categorias:
    [LOW, MEDIUM, HIGH, CRITICAL]
    Responda APENAS com JSON válido no formato:
    {{"severity": "...", "reason": "...", "action": "..."}}

    Evento:
    {json.dumps(event, indent=2)}
    """

    payload = {
        "model": MODEL,
        "prompt": prompt,
        "stream": False,
        "format": "json"
    }

    response = requests.post(AGENT_ENDPOINT, json=payload, timeout=10)
    response.raise_for_status()

    result = json.loads(response.json()["response"])

    # Regra de segurança: nunca confiar cegamente na IA
    if result["severity"] not in ["LOW", "MEDIUM", "HIGH", "CRITICAL"]:
        raise ValueError(f"Severidade inválida retornada pelo agente: {result}")

    return result

def handle_event(event: dict):
    """Pipeline principal de tratamento de eventos."""
    classification = classify_event(event)

    enriched = {
        "timestamp": datetime.utcnow().isoformat(),
        "original_event": event,
        "ai_analysis": classification,
        "reviewer": None  # Humano no loop pra CRITICAL/HIGH
    }

    if classification["severity"] in ["HIGH", "CRITICAL"]:
        send_to_soc(enriched)  # PagerDuty, Slack, etc.
        enriched["reviewer"] = "pending_human_review"

    return enriched

# Exemplo de uso
if __name__ == "__main__":
    sample_event = {
        "source_ip": "203.0.113.42",
        "user_agent": "curl/7.88.1",
        "path": "/admin/login",
        "status_code": 401,
        "attempts_in_5min": 47
    }

    result = handle_event(sample_event)
    print(json.dumps(result, indent=2))
Esse é só o começo. Em produção real, você adicionaria:
- Rate limiting no endpoint do agente pra evitar abuso.
- Validação de schema com Pydantic ou Zod.
- Telemetria pra medir falsos positivos/negativos.
- Kill switch manual caso o agente comece a alucinar.
Erros comuns que devs cometem em projetos de IA + segurança
Em mais de uma década escrevendo código, cometi (e vi) cada um desses erros. Anota aí:
1. Mandar dados sensíveis pra APIs públicas de IA
Você está debugando um problema em produção, cola o stack trace no ChatGPT e, sem perceber, vazou uma API key que estava no log. Solução: use modelos locais (Ollama, LM Studio) ou endpoints privados com SLA de não-retenção.
2. Confiar 100% na classificação do LLM
LLMs alucinam. Sempre. Se você montar um pipeline de segurança que bloqueia tráfego baseado apenas no output de um modelo de linguagem, prepare-se pra ter falsos positivos massivos ou — pior — incidentes passando batido.
3. Ignorar supply chain de modelos
Baixar um modelo do Hugging Face sem verificar procedência é tipo instalar uma dep do npm sem checar o package.json. Pesadelos acontecem. Use hashes, assine modelos, prefira repositórios oficiais.
4. Esquecer do prompt injection
Se seu agente lê inputs externos (logs de usuário, tickets, comentários), alguém pode injetar instruções maliciosas. Testei isso em produção e funciona. Trate toda entrada como hostil.
5. Não ter observabilidade no agente
Se você não sabe o que seu agente de IA está fazendo, não tem como auditar nem melhorar. Cada decisão do agente precisa estar logada com contexto suficiente pra um humano revisar depois.
Soberania digital: por que devs deveriam se importar
Esse tema apareceu de forma transversal no Fortinet Security Day e, na minha opinião, é o mais subestimado pela comunidade técnica. Soberania digital não é só política — é arquitetura. Quando você escolhe onde seus dados moram, quem processa suas requisições e qual jurisdição legal se aplica, você está tomando decisões de engenharia com impacto direto em compliance, latência e custo.
Três pontos que considero inegociáveis em 2026:
| Aspecto | Dependência externa (EUA) | Soberania local (EU) |
|---|---|---|
| Latência média | 80–150ms | 10–30ms |
| Compliance GDPR | Risco alto | Nativo |
| Custo com escala | Previsível | Pode ser menor em volumes altos |
| Vendor lock-in | Forte | Moderado |
Não existe resposta única. Mas ignorar essa variável na hora de arquitetar um sistema é erro de principiante.
Comparativo: Fortinet vs alternativas no mercado
O evento foi sobre Fortinet, mas como dev sênior eu sempre penso em alternativas. Aqui vai um comparativo honesto baseado em projetos que entreguei:
- Fortinet (FortiGate, FortiAI) — robusto, bom para ambientes enterprise, curva de aprendizado alta, licenciamento caro.
- Palo Alto Networks (Prisma, Cortex) — excelente detecção, ML proprietário forte, preço premium.
- CrowdStrike (Falcon) — líder em endpoint, IA bem treinada, ótimo pra ambientes cloud-native.
- Wazuh (open source) — flexível, sem custo de licença, mas exige mais operação interna. Minha escolha pra startups e scale-ups.
- Suricata + ELK + agente IA — stack 100% customizável, ideal pra quem tem time de segurança dedicado.
A regra que sigo: quanto mais crítico o ambiente, menos DIY você deve fazer. Se você está protegendo dados de saúde ou financeiros, pague pelo suporte enterprise. Se é um MVP de startup, open source com bom processo resolve.
FAQ — Perguntas reais que devs fazem
Vale a pena rodar um LLM local pra classificação de segurança?
Depende do volume. Pra até ~10k eventos/dia, modelos como Llama 3.1 8B ou Mistral 7B rodam bem numa GPU modesta. Acima disso, considere fine-tuning ou um endpoint dedicado com SLAs.
Como evito prompt injection em agentes de segurança?
Trate inputs como código hostil. Use sanitização rigorosa, separe claramente instruções de sistema e dados do usuário, e nunca permita que o output do agente execute ações sem validação humana em casos críticos.
Shadow IT é realmente um problema pra devs?
Mais do que parece. Toda ferramenta não homologada que roda na sua empresa é uma superfície de ataque invisível. Crie um processo leve de aprovação de ferramentas — quanto mais fricção, mais shadow IT você terá.
Qual o melhor stack open source pra SOC pequeno?
Wazuh (SIEM) + MISP (threat intel) + TheHive (case management) + um agente IA local pra triagem. Custo: hardware + tempo do time. Valor: controle total.
Soberania digital impacta performance?
Sim, positivamente em muitos casos. Dados dentro da UE têm menor latência pra usuários europeus, menos hops de rede, e compliance nativo simplifica auditorias.
Considerações finais
O Fortinet Security Day 2026 deixou uma mensagem clara: a próxima década de cibersegurança será definida pela qualidade da integração entre IA, processos humanos e governança de dados. Não existe bala de prata. Existe arquitetura inteligente e times bem treinados.
Na minha experiência, o dev que entende essas três camadas (segurança, IA, soberania) tem um diferencial absurdo no mercado. Não é só sobre escrever código — é sobre escrever código que sobrevive ao próximo ataque, à próxima regulamentação e à próxima geração de ameaças.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.