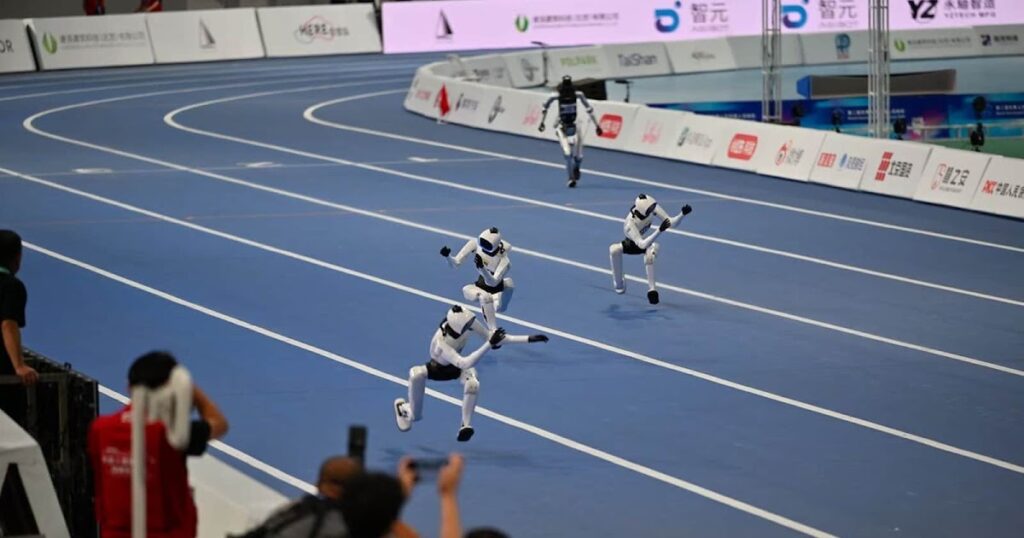
Um robô humanoide de 400m descobriu, sozinho, que o jeito humano de correr é ineficiente para uma máquina. O engenheiro que projetou o bicho tentou simular o balanço natural dos braços — e o resultado foi juntas de ombro superaquecendo antes da metade da pista. A solução veio do próprio robô: ele “inventou” um estilo de corrida completamente novo depois de iterar vezes em simulação. Isso me chamou atenção por dois motivos. Primeiro, é um caso real de aprendizado por reforço aplicado a locomoção. Segundo, mostra como copiar a biologia sem questionar é uma armadilha clássica em engenharia — e em software também.
O que aconteceu com o robô corredor
Segundo o Abertoatedemadrugada.com, a equipe inicialmente calibrou o controlador do robô para reproduzir o ciclo de marcha humana, incluindo o contramovimento dos braços. A lógica parecia óbvia: humanos fazem assim, então deve ser o padrão-ouro. Só que humanos têm redundância muscular, dissipação de calor via suor e décadas de evolução refinando a biomecânica. O robô tem motores elétricos com tolerância térmica apertada e juntas que operam no limite.
Quando o balanço dos braços era forçado a acompanhar o ciclo da corrida, os servos dos ombros entravam em regime térmico acima do nominal em menos de 200 metros. O controlador disparava o safety stop e o robô congelava no meio da pista — sem completar os 400m. A equipe então deixou o pipeline de aprendizado por reforço rodar solto, sem restrição postural, e o robô convergiu para um padrão de corrida com movimento mínimo de membro superior. Ombros quase estáticos, compensação de momento angular feita pelo core e pela inclinação do tronco. Tempo final: melhor que o humano médio.
Por que isso importa para quem desenvolve software e IA
Na minha experiência, esse caso é uma aula compacta sobre três coisas que vejo constantemente em projetos de machine learning aplicado:
- Bias de domínio mal calibrado. Quando você injeta conhecimento humano (“faça como o humano faz”) num sistema de aprendizado, está adicionando um prior. Às vezes esse prior é útil; às vezes ele limita o espaço de busca e impede o modelo de encontrar soluções melhores. Em locomoção robótica, a intuição humana sobre corrida não é necessariamente ótima para atuadores elétricos.
- Otimização multi-objetivo raramente é o que parece. O objetivo declarado era “correr 400m”. O objetivo real era “correr 400m sem superaquecer as juntas”. Quem define a função de recompensa errada vai treinar um robô que corre rápido por 180 metros e explode.
- Sim-to-real gap aparece onde você menos espera. O estilo novo foi descoberto em simulação. Funciona no hardware real porque o modelo térmico dos motores estava bem calibrado no simulador. Quando o dev não investe tempo em modelar bem o ambiente, o que sai da simulação é ficção.
Eu já vi equipe inteira queimando semanas porque copiaram a arquitetura famosa do paper sem perguntar se o problema de negócio era o mesmo. O robô de 400m é a versão física desse erro.
A arquitetura por trás: reinforcement learning em locomoção
O pipeline que gera esse tipo de resultado normalmente segue um padrão bem consolidado em laboratórios como ETH Zürich, NVIDIA e Google DeepMind. Você tem:
- Um ambiente simulado (MuJoCo, Isaac Gym, Genesis) com o modelo URDF do robô.
- Uma política neural — geralmente uma MLP ou um transformer leve — que recebe estado (orientação, velocidades articulares, contato dos pés) e produz ações (torques ou posições alvo).
- Um algoritmo de otimização de política, tipicamente PPO, SAC ou um dos flavors de Dreamer.
- Uma função de recompensa que mistura velocidade linear, estabilidade postural, penalidade por uso excessivo de torque e — crucial aqui — penalidade térmica por junta.
O detalhe que fez a diferença neste caso foi justamente adicionar a temperatura da junta como sinal de penalidade. Sem isso, o otimizador não tinha motivo para reduzir a amplitude do balanço dos braços. A solução não veio de uma mudança arquitetural da rede, nem de um algoritmo mais sofisticado — veio de modelar melhor o problema físico que você quer resolver.
Na Prática: um esqueleto de reward shaping em Python
Para vocês terem uma ideia concreta do que estou falando, aqui vai um esboço simplificado de como seria uma função de recompensa para esse problema. Não é código de produção — é didático. Usei o padrão do Isaac Gym porque é o que a maioria dos labs de locomoção usa hoje.
import torch
import numpy as np

class RunningReward:
 def __init__(self, dt=0.02, temp_limit=85.0):
 self.dt = dt
 self.temp_limit = temp_limit # celsius
 self.prev_action = None

 def __call__(self, state, action, joint_temps):
 forward_velocity = state["base_lin_vel"][:, 0]
 lateral_drift = torch.abs(state["base_lin_vel"][:, 1])
 roll_pitch = torch.norm(state["base_ang_vel"][:, :2], dim=-1)

 # Termo principal: queremos velocidade para frente
 vel_reward = torch.exp(-2.0 * (forward_velocity - 4.0) ** 2)

 # Penalidade por oscilacao lateral e inclinacao
 stability_penalty = 0.5 * lateral_drift + 0.3 * roll_pitch

 # Penalidade por eficiencia energetica (suavidade de acao)
 if self.prev_action is not None:
 smoothness = torch.mean((action - self.prev_action) ** 2, dim=-1)
 else:
 smoothness = torch.zeros_like(forward_velocity)
 self.prev_action = action.clone()

 # AQUI esta o pulo do gato: penalidade termica por junta
 # Normaliza entre 0 e 1, sendo 1 = acima do limite
 thermal_stress = torch.relu(joint_temps - self.temp_limit * 0.7)
 thermal_stress = thermal_stress / (self.temp_limit * 0.3 + 1e-6)
 thermal_penalty = 2.0 * torch.mean(thermal_stress, dim=-1)

 total = vel_reward - stability_penalty - 0.1 * smoothness - thermal_penalty
 return total

 def reset(self):
 self.prev_action = None
Reparem na linha do thermal_penalty. É exatamente esse termo que empurra a política para descobrir estilos de corrida que economizam as juntas mais frágeis. Sem ele, o otimizador não tem informação para distinguir entre “correr rápido gastando tudo” e “correr rápido sem fritar os motores”. E o detalhe sutil: eu usei torch.relu(joint_temps - self.temp_limit * 0.7) em vez do limite nominal completo. Você não quer esperar o motor chegar no vermelho para começar a penalizar — quer que o gradiente já fique desconfortável quando a temperatura começa a subir. Isso é uma técnica de soft constraint que funciona muito melhor em RL do que tentar impor limites rígidos via clipping.
Erros comuns que eu vejo em times que tentam locomoção (e analogamente, em qualquer projeto de RL)
1. Recompensa rala demais. Recompensa só no final do episódio (“chegou ao objetivo ou não”) gera políticas que aprendem devagar e geralmente não generalizam. Densidade de sinal importa. Em corrida, recompensar velocidade continuamente é melhor que recompensar apenas a distância final.
2. Não modelar o que dói. Esse é o erro que o robô do exemplo expôs de forma didática. Se você tem um atuador que superaquece, isso precisa aparecer na função de perda de algum jeito — nem que seja como uma penalidade suave. Mesma coisa vale para budgets de memória, latência de inferência ou custo de API em produção.
3. Domínio demais no estado, restrição de menos na postura. Eu entendo a tentação de “soltar” o robô completamente. Mas sem nenhuma constraint, a política pode convergir para soluções que são fisicamente realizáveis em simulação mas instáveis no hardware real. O segredo é encontrar o meio-termo entre liberdade total e prisão postural.
4. Ignorar o custo do ciclo de iteração. Treinar uma política de corrida em Isaac Gym pode consumir 200 GPU-horas. Antes de mudar reward, mudar arquitetura ou mudar algoritmo, verifique se a física do simulador está calibrada. Tempo gasto em modelagem economiza ordens de magnitude em experimentação.
5. Copiar paper sem ler os detalhes do reward. Muita gente implementa o paper do DayDreamer ou do AMP e esquece que o reward shaping foi cuidadosamente ajustado para aqueles hiperparâmetros. Mude o robô e o reward precisa ser revisitado.
Implicações além da robótica
O que me fascina nesse caso é que ele generaliza para qualquer sistema onde você tem agentes artificiais interagindo com o mundo. Recomendações em e-commerce, navegação de carros autônomos, políticas de cache em CDN, agentes de trading — todos compartilham a mesma estrutura: função de recompensa mal especificada gera comportamento patológico. Quando o sistema “inventa” um jeito novo de fazer a tarefa, geralmente é sinal de que o seu objetivo declarado e o seu objetivo real estavam desalinhados.
Se você trabalha com MLOps, vale auditar periodicamente as métricas que estão virando sinal para os seus modelos. Às vezes a melhor otimização vem não de um algoritmo mais sofisticado, mas de perceber que você estava treinando o robô a balançar os braços.
FAQ
O robô realmente “inventou” a corrida sozinho ou foi o engenheiro que ajustou?
O engenheiro ajustou o espaço de busca e a função de recompensa, mas a solução específica (ombros estáticos, compensação por core) emergiu do processo de otimização. Em RL isso é padrão: o humano define as regras do jogo, o agente descobre as estratégias. Atribuir criatividade 100% ao robô é exagero; atribuir 100% ao engenheiro também é.
Esse tipo de resultado é reproduzível com hardware caseiro?
Parcialmente. Você consegue treinar políticas de locomoção em simulação com uma GPU de consumidor (RTX 4070 para cima roda Isaac Gym tranquilo). Já deploy no robô físico exige hardware bem mais robusto e muita paciência para o sim-to-real transfer. O Unitree Go2 e o G1 são os candidatos mais populares para devs que querem brincar com isso.
Por que não treinar com braço swing limitado em vez de deixar o robô descobrir?
Você pode. Hard constraints funcionam. Mas restringir demais limita o espaço de busca e pode eliminar soluções intermediárias criativas. O sweet spot é reward shaping com penalidade progressiva — exatamente o que o thermal_penalty do exemplo faz.
PPO é o algoritmo certo para locomoção?
PPO ainda é o padrão por estabilidade e facilidade de tuning. SAC é competitivo em algumas tarefas. Para casos com espaço de observação grande (vídeo + estado proprioceptivo), variantes de Dreamer estão ganhando tração. Não existe bala de prata.
Quanto tempo de treinamento até o robô descobrir um estilo novo?
Depende da complexidade do ambiente e do reward. Para locomoção bípede em terreno plano com Isaac Gym, entre 30 minutos e 4 horas em uma A100. O estilo “novo” costuma emergir na metade do treinamento, mas a estabilização para uma política robusta leva mais tempo.
Esse caso do robô de 400m é um lembrete ótimo de que engenharia de IA não é só sobre modelos grandes e dados massivos. Às vezes é sobre formular melhor o problema. No fim das contas, o robô não aprendeu a correr melhor — ele aprendeu a não se destruir enquanto corria. Isso, por si só, já é uma vitória enorme de modelagem.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.