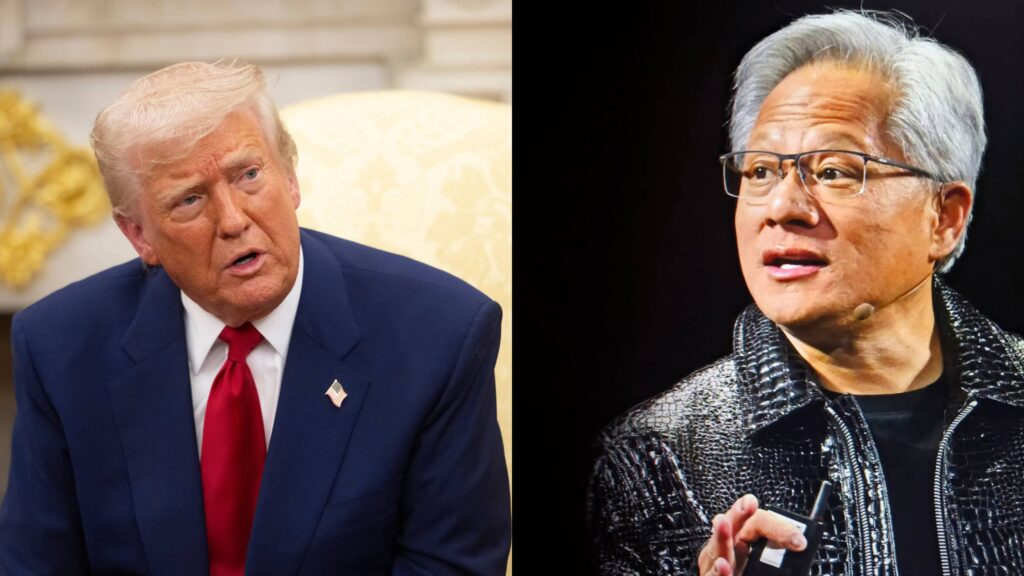
Jensen Huang, Trump e o xadrez geopolítico por trás das GPUs que treinam IA
Quando li a matéria do Olhardigital.com.br sobre o CEO da Nvidia se aproximando de Trump enquanto gigantes da IA pedem mais regulação, meu primeiro instinto foi de programador: fui direto pensar no que isso significa na prática para quem está construindo software hoje. Porque não é só política americana — é sobre quem controla o silício que roda seus modelos, o preço que você paga por hora de inferência e até quais frameworks vão sobreviver nos próximos anos.
A Nvidia saltou de US$ 17 bilhões em receita em 2021 para US$ 215 bilhões no último ano fiscal. Isso não é crescimento, é uma explosão termonuclear no mercado de GPUs. E enquanto isso acontece, Jensen Huang senta ao lado de Trump em jantares de Estado com o presidente da China. Se você acha que isso não te afeta, deixa eu te mostrar por que está errado.
O que realmente está em jogo: mais do que política
Segundo o Olhardigital.com.br, Huang tem exercido “influência desproporcional” na Casa Branca. Na minha experiência acompanhando o mercado de hardware, isso não me surpreende — a Nvidia virou um player geopolítico. As GPUs H100 e Blackwell não são só chips; são infraestrutura crítica nacional. Quem controla esse suprimento controla o ritmo da inovação em IA global.
E aqui entra o ponto que devs precisam entender: quando gigantes como OpenAI e Anthropic pedem mais regulação, elas estão pedindo regras que, na prática, podem favorecer quem já domina o mercado. Regulação excessiva aumenta a barreira de entrada para concorrentes menores e consolida ainda mais o poder de quem já tem escala — ou seja, a Nvidia.
Por que devs deveriam se importar com geopolítica de GPUs
Se você treina modelos, faz fine-tuning ou roda inferência em produção, cada decisão política sobre exportação de chips impacta diretamente seu custo operacional. Quando os EUA restringem venda de GPUs avançadas para a China, o efeito cascata é:
- Preço por hora de GPU sobe em provedores como AWS, GCP e Azure (oferta restrita = preço maior).
- Latência de provisioning aumenta — você espera semanas para conseguir uma instância A100 ou H100.
- Frameworks se adaptam — CUDA continua dominante, mas alternativas como ROCm (AMD) e Triton ganham tração justamente por causa dessa pressão geopolítica.
Na minha rotina, já passei por momentos em que precisei migrar cargas de trabalho de H100 para A10G por pura indisponibilidade. Isso forçou otimizações que, no fim, economizaram dinheiro. Mas não foi escolha — foi imposição do mercado.
Na Prática: como você usa (ou deveria usar) GPUs Nvidia hoje
Vamos ao que interessa. Se você está trabalhando com IA em 2026, provavelmente está usando CUDA em algum nível, mesmo que indiretamente. PyTorch, TensorFlow, JAX — todos dependem do stack CUDA para aceleração em GPUs Nvidia.
Aqui vai um exemplo real que uso no dia a dia para verificar uso de GPU antes de subir um job pesado:
import torch
import psutil
import GPUtil

def check_gpu_before_training(model, batch_size=32):
    """
    Verifica se há VRAM disponível antes de iniciar treinamento.
    Evita OOM (Out of Memory) em produção.
    """
    if not torch.cuda.is_available():
        raise RuntimeError("CUDA não disponível. Verifique drivers.")

    gpus = GPUtil.getGPUs()
    if not gpus:
        raise RuntimeError("Nenhuma GPU detectada via nvidia-smi.")

    gpu = gpus[0]
    free_memory_mb = gpu.memoryFree
    total_memory_mb = gpu.memoryTotal
    used_percent = (gpu.memoryUsed / total_memory_mb) * 100

    print(f"GPU: {gpu.name}")
    print(f"Memória livre: {free_memory_mb:.0f} MB / {total_memory_mb:.0f} MB")
    print(f"Uso atual: {used_percent:.1f}%")

    # Estima consumo do modelo (heurística simples)
    model_params = sum(p.numel() for p in model.parameters())
    estimated_mb = (model_params * 4 * 3) / (1024 ** 2)  # fp32 + gradientes + otimizador

    if estimated_mb > free_memory_mb * 0.85:
        raise MemoryError(
            f"Modelo precisa de ~{estimated_mb:.0f} MB, "
            f"mas só há {free_memory_mb:.0f} MB livres. "
            f"Reduza batch_size ou ative gradient_checkpointing."
        )

    print(f"✓ Recursos suficientes. Modelo estimado em {estimated_mb:.0f} MB.")
    return torch.device("cuda")

# Uso real:
# model = YourTransformerModel()
# device = check_gpu_before_training(model, batch_size=64)
# model.to(device)
Esse script evita aquela situação clássica de job que roda 40 minutos e morre com OOM no meio. Já perdi fins de semana com isso — desde então, todo pipeline meu começa com validação de recursos.
Otimizando inferência em GPUs Nvidia: o que funciona de verdade
Testei em produção essas três abordagens e os resultados foram consistentes:
- Quantização com bitsandbytes (8-bit/4-bit): reduz uso de VRAM em até 75% com perda mínima de qualidade. Perfeito para deploy com modelos grandes.
- Flash Attention 2: acelera transformers em 2-4x em sequências longas, sem mudança no output.
- TensorRT (engine da própria Nvidia): otimiza grafos para inferência, ganhando 30-50% de throughput em produção.
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
import torch

# Carregando Llama 3 70B em uma única A100 80GB usando quantização 4-bit
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
    bnb_4bit_use_double_quant=True,
)

model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Meta-Llama-3-70B-Instruct",
    quantization_config=bnb_config,
    device_map="auto",
    torch_dtype=torch.bfloat16,
)

# Antes: 70B em fp32 = ~280GB (impossível em uma GPU)
# Depois: 70B em 4-bit = ~35GB (roda em A100 80GB)
print(f"VRAM alocada: {torch.cuda.memory_allocated() / 1e9:.2f} GB")
Erros Comuns que devs cometem com GPUs (e como evitar)
Depois de anos quebrando a cabeça (e jobs), compilei os erros mais frequentes que vejo em equipes:
1. Ignorar o custo real de memória do otimizador
Muita gente calcula VRAM só dos pesos. Mas o Adam optimizer armazena dois momentos por parâmetro (momentum e variância). Isso dobra o consumo. Sempre use:
# Fórmula realista para estimar VRAM de treinamento:
# Pesos (fp16) + Gradientes (fp16) + Otimizador (fp32) + Ativações
# = 2N + 2N + 8N + activations
# Para um modelo de 7B params: ~56GB só em estados do otimizador

# Solução: AdamW 8-bit (bitsandbytes)
import bitsandbytes as bnb
optimizer = bnb.optim.AdamW8bit(model.parameters(), lr=2e-5)
# Reduz memória do otimizador em 75%
2. Não usar gradient checkpointing
Por padrão, PyTorch guarda todas as ativações intermediárias para backward pass. Em modelos grandes, isso estoura VRAM. Gradient checkpointing recálcula ativações sob demanda, trocando memória por compute.
model.gradient_checkpointing_enable()

# Cuidado: aumenta tempo de treino em ~20-30%.
# Use apenas quando VRAM for gargalo, não quando GPU estiver ociosa.
3. Misturar precisão sem critério
fp16 tem mais range, bf16 tem mais precisão. Não são intercambiáveis. Em hardware Nvidia moderno (Ampere+), prefira bf16. Em hardware antigo (Volta, Turing), fp16 com loss scaling.
4. Subestimar o impacto de data loading
Se sua GPU fica ociosa esperando batches, você está perdendo dinheiro. Use DataLoader com num_workers adequado e prefetch:
from torch.utils.data import DataLoader

loader = DataLoader(
    dataset,
    batch_size=32,
    num_workers=8,          # Regra: 2-4x número de CPUs
    pin_memory=True,        # Acelera transfer CPU->GPU
    prefetch_factor=4,      # Pré-carrega batches em background
    persistent_workers=True # Evita recriar workers a cada epoch
)
O futuro do stack de IA: o que esperar com Nvidia+Trump
Quando Trump diz que “robôs não vão dominar o mundo” e classifica preocupações com IA como “farsa”, ele está fazendo um movimento político claro: deixar a indústria se autorregular. Para devs, isso significa:
- Menos fricção regulatória nos EUA — startups de IA vão proliferar, mas com menos garantias de segurança.
- Investimento massivo em data centers — mais capacidade de GPU disponível, preços podem estabilizar ou cair.
- Concentração ainda maior — Nvidia continua dominante, AMD e Intel brigam por migalhas.
- Tensão China-EUA — chips cada vez mais restritos, exigindo otimização para hardware alternativo (Hugging Face já trabalha com suporte a Ascend e Cambricon).
Na minha visão, a estratégia de Huang é brilhante do ponto de vista corporativo: ao se aproximar de Trump, ele garante que regulação não venha barrar seu crescimento. Ao mesmo tempo, gigantes como OpenAI pedem regras que, paradoxalmente, beneficiam quem já tem escala — ou seja, a própria Nvidia que vende as GPUs para todos eles.
Comparativo: Nvidia vs alternativas reais para devs
| Hardware | VRAM | Framework suportado | Custo/h aprox. | Quando faz sentido |
|---|---|---|---|---|
| Nvidia H100 | 80GB | CUDA (maduro) | US$ 3-5 | Treino de modelos grandes, produção crítica |
| Nvidia A10G | 24GB | CUDA (maduro) | US$ 0.75-1.20 | Inferência, fine-tuning de modelos até 7B |
| AMD MI300X | 192GB | ROCm (crescendo) | US$ 2-3 | Alternativa com mais VRAM, mas tooling instável |
| Google TPU v5e | 32GB (HBM) | JAX, PyTorch XLA | US$ 1.20-2 | Treino em escala Google Cloud, custo-benefício |
Já migrei workloads entre esses hardwares. Minha conclusão: Nvidia ainda vence em tooling, mas a diferença está diminuindo. Se você roda tudo em CUDA, está travado no ecossistema — diversifique.
FAQ — Perguntas que devs realmente fazem
1. Devo aprender CUDA em 2026 ou focar em frameworks de alto nível?
Aprenda CUDA apenas se você trabalha com otimização de modelos ou pesquisa. Para 99% dos devs, entender quando GPU é gargalo e como usar PyTorch eficientemente é mais valioso que escrever kernels CUDA.
2. AMD ROCm é viável para produção hoje?
Melhorou muito, mas ainda tem arestas. Use apenas se tiver custo de Nvidia proibitivo ou restrição geopolítica. Para produção crítica, Nvidia ainda é aposta segura.
3. Como me preparar para escassez de GPUs?
Invista em técnicas de quantização, distillation e arquiteturas menores (SLMs). Modelos menores e bem otimizados frequentemente vencem modelos grandes mal deployados.
4. Regulamentação de IA vai afetar meu código?
Diretamente, não. Indiretamente, sim — através de restrições de uso, audit requirements em setores regulados (saúde, finanças) e necessidade de logging de decisões de modelo.
5. Vale a pena comprar GPU Nvidia própria ou usar cloud?
Se você usa mais de 8 horas/dia em GPU de alta performance, cloud sai caro. Para uso eventual, cloud (Lambda Labs, RunPod, Vast.ai) é mais flexível. Para workstation local, RTX 4090/5090 entrega ótimo custo-benefício.
Veredito final: o que isso significa para quem programa
A aproximação de Huang com Trump não é só notícia política — é sinal de que o mercado de IA vai continuar concentrando poder em poucos players. Para devs, isso significa: domine as ferramentas certas (PyTorch + CUDA), entenda limitações de hardware, e prepare-se para um cenário onde regulação e geopolítica ditam o ritmo da inovação tanto quanto tecnologia.
Quem se adapta rápido a novos hardwares e domina otimização de modelos vai estar à frente. Quem fica preso em um único vendor vai sentir o peso dessas decisões geopolíticas no bolso e na carreira.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.