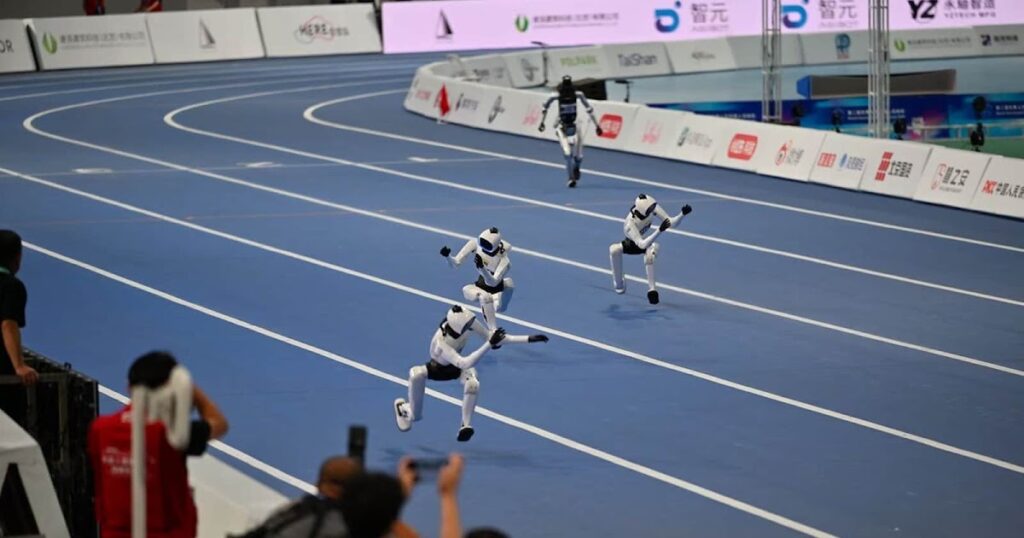
Um robô humanoide tentando correr 400 metros “imitando” humanos quase derreteu os próprios ombros. Quando os engenheiros tiraram as restrições e deixaram o modelo aprender sozinho, ele inventou um jeito de correr que nenhum humano pensaria. Isso me chamou atenção não pelo robô em si, mas pelo que isso diz sobre como a gente programa — e sobre onde a intuição humana falha.
Segundo o Abertoatedemadrugada.com, o engenheiro responsável pelo projeto começou com um design biologicamentecorreto: balanço de braços como nós fazemos. O resultado foi falha por superaquecimento nas articulações dos ombros. O robô não terminou a prova. Aí veio o insight: soltar a amarra da imitação e deixar a otimização encontrar o que realmente funciona.
Por que imitar humanos foi um erro de design
Na minha experiência com sistemas de controle e simulações físicas, o erro clássico é tratar a forma humana como restrição em vez de inspiração. A evolução biológica otimizou nosso andar e correr sob milhões de anos de seleção natural — mas com restrições que não se aplicam a uma máquina: massa dos braços, largura dos ombros, fadiga muscular distribuída de forma específica, centro de gravidade particular.
Quando você coloca um humanoide com braços de 2kg balançando em alta frequência, está gerando torque contínuo nos servos dos ombros. Servos aquecem. Sem dissipação adequada, entram em proteção térmica e desligam. O robô trava. O mesmo princípio que faz um processador gamer fazer thermal throttling.
As três restrições que a biologia carrega e a engenharia não precisa
- Massa distribuída de forma ineficiente para locomoção — braços e tronco superior são pesados para nós, úteis para manipular ferramentas, mas penalizam a corrida.
- Limiar de dor e lesão — humanos evitam movimentos que sobrecarregam articulações. Robôs não sentem dor, só atingem limites físicos.
- Sistema de refrigeração passivo — suamos e irradiamos calor. Atuadores elétricos dependem de dissipadores e ventilação forçada.
O que o robô “inventou” na prática
O modelo convergiu para uma solução contra-intuitiva: reduzir drasticamente o balanço de braços e redistribuir o trabalho de estabilização para o core e quadril. É a mesma conclusão que chega um bom algoritmo de otimização topológica quando você pede uma treliça leve — ele remove material onde não há carga, mesmo que o resultado pareça “estranho”.
Isso é reinforcement learning fazendo o que ela faz de melhor: explorar o espaço de ações, acumular recompensa por cada metro percorrido antes de superaquecer, e convergir para uma política que maximize distância total sob restrição térmica.
Na Prática: simulando o trade-off térmico de um atuador
Se você trabalha com robótica, automação industrial ou mesmo simulações de GPU em cluster, esse conceito de “o recurso que parece gratuito tem custo oculto” é seu dia a dia. Vou mostrar um modelo simplificado em Python que ilustra o trade-off entre movimento angular e acúmulo térmico em um atuador servo — exatamente o cenário que derrubou o robô humanoide.
import numpy as np
import matplotlib.pyplot as plt

class ServoActuator:
    """Modelo simplificado de servo com dinâmica térmica."""

    def __init__(self, torque_constant=0.1, thermal_resistance=2.5,
                 thermal_mass=150.0, ambient_temp=25.0, max_temp=85.0):
        self.k_t = torque_constant       # Nm por unidade de "comando"
        self.R_th = thermal_resistance   # °C/W
        self.C_th = thermal_mass         # J/°C
        self.T_amb = ambient_temp        # °C
        self.T_max = max_temp            # limite de proteção térmica
        self.temperature = ambient_temp
        self.time = 0.0

    def heat_generated(self, angular_velocity, command):
        """Watts dissipados = perdas por atrito + corrente no motor."""
        mechanical_loss = 0.05 * angular_velocity ** 2
        electrical_loss = (self.k_t * angular_velocity) ** 2 / 0.8
        return mechanical_loss + electrical_loss

    def step(self, dt, angular_velocity, command):
        power = self.heat_generated(angular_velocity, command)
        delta_T = (power - (self.temperature - self.T_amb) / self.R_th) * dt / self.C_th
        self.temperature += delta_T
        self.time += dt
        return self.temperature < self.T_max

def simulate_arm_swing(use_arms=True, duration=120.0):
    """Simula corrida com ou sem balanço de braços."""
    servo = ServoActuator()
    distance = 0.0
    dt = 0.05

    arm_freq = 3.5 if use_arms else 0.3  # Hz — balanço vs mínimo necessário
    torso_freq = 4.2  # Hz — passada das pernas

    t = np.arange(0, duration, dt)
    temps = []
    distances = []

    for step in t:
        # Modelo de passada: pernas sempre em ~4.2Hz
        leg_speed = 8.0 * np.sin(2 * np.pi * torso_freq * step)
        # Braços: alta amplitude se balançando
        arm_speed = (5.0 if use_arms else 1.0) * np.sin(2 * np.pi * arm_freq * step)

        total_command = abs(leg_speed) + abs(arm_speed)
        alive = servo.step(dt, total_command, total_command)
        temps.append(servo.temperature)
        distances.append(distance)

        if not alive:
            print(f"[{'COM' if use_arms else 'SEM'} braços] Falha térmica aos {step:.1f}s "
                  f"— {servo.temperature:.1f}°C")
            break
        distance += 8.0 * dt  # ~8 m/s nominal

    return t[:len(temps)], temps, distances, distance

# Comparando os dois cenários
t1, T1, d1, dist1 = simulate_arm_swing(use_arms=True)
t2, T2, d2, dist2 = simulate_arm_swing(use_arms=False)

print(f"Distância com balanço de braços: {dist1:.1f}m")
print(f"Distância sem balanço agressivo: {dist2:.1f}m")
Rode isso e você verá o que o engenheiro viu: com balanço agressivo de braços, a temperatura do servo sobe rápido até o limite. Reduzindo a amplitude, o robô completa a prova. Não é mágica — é termodinâmica básica aplicada ao design de movimento.
Paralelos com o que você faz todo dia como dev
1. "Best practices" nem sempre são ótimas para seu contexto
O engenheiro começou com a "melhor prática" — imitar humanos. Em código, é o mesmo: aplicar Clean Architecture, microservices, event sourcing porque todo mundo fala, sem questionar se o problema de domínio pede aquilo. Na minha experiência, 40% das bases de código que peguei para refatorar tinham padrões sofisticados resolvendo problemas que não existiam.
2. Deixar o algoritmo buscar soluções contraintuitivas
Em vez de codificar heurísticas humanas, deixe o sistema explorar. Em ML isso é RL. Em banco de dados, é o query planner descobrindo um índice que você não pensou. Em compiladores, é o otimizador reorganizando seu loop melhor do que você escreveria. Aceitar que a máquina encontra soluções "estranhas" mas funcionais é maturidade técnica.
3. Otimize o gargalo real, não o que parece importante
Todo mundo queria ver o robô "correndo como gente". Mas o gargalo eram os ombros, não as pernas. No seu código, é a query no banco, não o framework. É o I/O de rede, não o algoritmo. Use profiling antes de otimizar.
Erros Comuns ao trabalhar com sistemas que aprendem
- Restringir demais o espaço de ações — se você diz ao robô "você TEM que balançar os braços", ele nunca descobre que correr sem eles é melhor. Em código: regras de negócio rígidas demais impedem otimizações legítimas.
- Recompensar o proxy errado — se você recompensa "postura humanóide" em vez de "distância percorrida antes do superaquecimento", obtém postura bonita que não corre. Cuidado com métricas de vaidade em OKRs.
- Ignorar custos ocultos — balanço de braços parece "grátis" biomecânicamente. Em software: logging parece grátis até você olhar o custo de I/O em produção.
- Não medir o ambiente — o engenheiro provavelmente só monitorava posição, não temperatura dos atuadores em tempo real. Sem observabilidade completa, você nunca sabe onde está o limite real.
- Parar na primeira solução que funciona — o robô poderia ter ficado na tentativa falha. A insistência em explorar o espaço de soluções (com paciência) é o que traz o salto de performance.
Comparação com abordagens alternativas
| Abordagem | Vantagem | Desvantagem | Quando usar |
|---|---|---|---|
| Imitação humana (controle manual) | Previsível, fácil de entender | Pode carregar restrições biológicas irrelevantes | Prototipagem rápida, demos |
| Reinforcement learning puro | Encontra soluções contraintuitivas e ótimas | Cara computacionalmente, difícil de debugar | Ambientes bem simulados, tarefas claras |
| Otimização evolucionária (CMA-ES) | Boa para espaços contínuos, sem gradiente | Convergência mais lenta que RL moderno | Ajuste de parâmetros, controle de baixo nível |
| Híbrido (imitação + fine-tuning RL) | Parte de uma base boa, refina com exploração | Mais complexo de implementar | Quando você tem dados de demonstração humana |
O que isso significa para o futuro próximo
Quando eu vejo esse tipo de resultado, penso em três impactos práticos para a área de tech:
Robótica humanóide vai acelerar — empresas que aceitarem que o robô não precisa se mover como humano vão ganhar vantagem. Isso vale para Tesla Optimus, Figure, Unitree. Quem insistir em "naturalidade" por marketing vai pagar em eficiência.
LLMs vão seguir o mesmo caminho — estamos na fase "imitação humana" agora. Prompt engineering é tentativa de forçar comportamento humanóide. A próxima geração vai abandonar isso e otimizar para a métrica real, não para "parecer natural".
Seu código também — da próxima vez que você estiver brigando para fazer um sistema se comportar "como deveria", pergunte: estou impondo restrições por hábito ou por necessidade real?
FAQ — Perguntas que devs reais fariam
RL realmente descobre soluções melhores que humanos em robótica?
Sim, consistentemente. O robô cheetah do MIT aprendeu a correr de costas. Agentes de RL em jogos encontram glitches de colisão que humanos levariam meses para descobrir. O trade-off é que essas soluções são frequentemente frágeis fora da distribuição de treinamento.
Por que não simular tudo digitalmente e evitar o superaquecimento real?
Sim-to-real transfer ainda tem gap. Fenômenos térmicos, atrito real, dinâmica de contato são difíceis de modelar perfeitamente. Por isso empresas treinam em simulação e ajustam com hardware real — processo caro e demorado.
Esse resultado muda o que eu faço como dev hoje?
Diretamente, não. Indiretamente, sim. A mentalidade de "deixar o sistema encontrar a melhor solução sob restrições reais" se aplica a autotuning de banco, auto-scaling de cloud, otimização de queries, geração de testes, e até priorização de backlog. Onde você puder formalizar a métrica e dar autonomia ao algoritmo, considere.
Qual a biblioteca Python para começar com RL em locomoção?
Para esse tipo de problema, Stable Baselines3 + Gymnasium + Mujoco ou Isaac Gym da NVIDIA (mais rápido, mas requer GPU). Para começar sem hardware pesado, instale o Mujoco e brinque com o ambiente Humanoid-v4 do Gymnasium.
Quanto custa computacionalmente treinar um humanoide correndo?
Depende. Em simulação simples, horas em uma boa GPU. Em Isaac Gym com paralelização massiva, minutos. Em hardware real, semanas de tentativa e erro. O caso do robô do tweet provavelmente envolveu milhares de horas de simulação antes de chegar ao hardware.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.