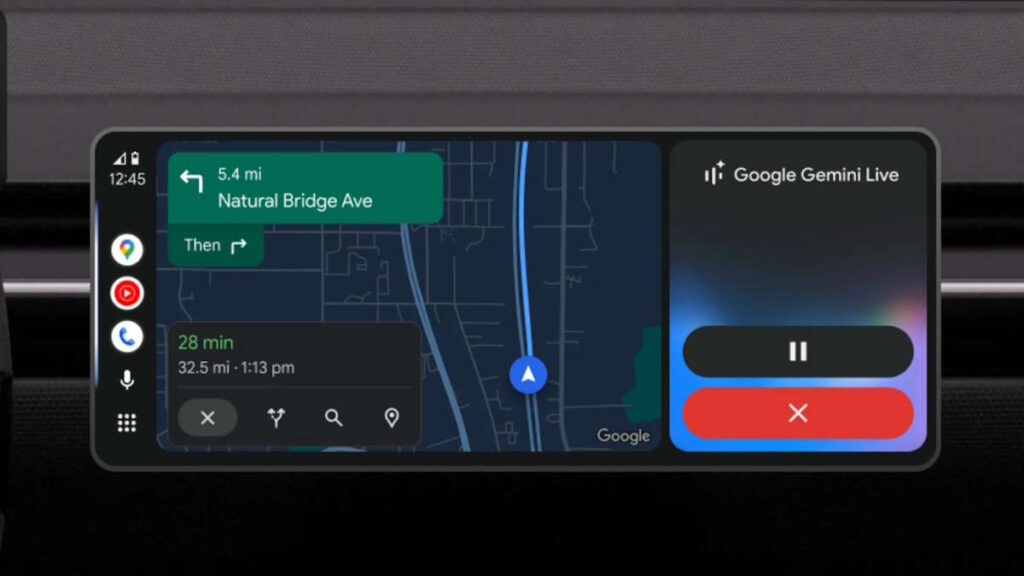
Gemini no Android Auto é um retrocesso. E o problema não é a IA — é a física.
Quando li a reportagem do Sapo.pt sobre os utilizadores a queixarem-se que o Gemini transformou o Android Auto num perigo na estrada, a minha reação como engenheiro foi: “óbvio”. Qualquer programador que mexe com modelos de linguagem em produção sabe que um assistente baseado em LLM é, por definição, mais lento e mais pesado do que um classificador de intenções baseado em regras. Ao volante, milissegundos contam.
Não é uma questão de ser contra IA — eu uso Gemini, GPT, Claude e modelos locais diariamente no meu fluxo de trabalho. Mas existe uma categoria de interfaces onde tempo de resposta acima de 800ms quebra completamente a experiência. Interfaces veiculares são uma delas.
O problema real não é a IA — é a latência
O Google Assistant antigo no Android Auto funcionava, essencialmente, com um pipeline clássico de NLU: captura de áudio → STT (Speech-to-Text) local ou rápido → intent matching → ação. O coração do sistema era um classificador treinado para um conjunto fechado de intenções: “navegar para casa”, “ligar para X”, “tocar Y”, “pausar”. Esse classificador cabia inteiro na memória do telemóvel, era determinístico, e respondia em ~100–300ms. O modelo nem precisava entender linguagem natural completa — bastava mapear palavras-chave para slots pré-definidos.
Arquitetura típica de um assistente por intenções (o modelo “antigo”)
Na prática, o fluxo era parecido com isto:
# Pipeline clássico (estilo Google Assistant antes do Gemini)
def handle_command(audio: bytes) -> Action:
    # STT rápido, muitas vezes on-device
    text = stt.transcribe(audio)

    # Intent matching com classificador leve
    intent = classifier.predict(
        text,
        intents=["navigation", "call", "music", "weather", "message"]
    )

    # Slot filling determinístico
    slots = extract_slots(text, intent)

    return dispatch(intent, slots)
Resposta em <200ms, sem rede, com contrato claro entre comando e ação. Substituir 1:1 por um LLM foi, do ponto de vista de engenharia de produto, um erro crasso.
Gemini no carro: onde a conta fecha e onde estoura
A Google sustenta — como o Sapo.pt cita — que a linguagem natural do Gemini oferece uma interação mais humana, fluida e intuitiva. Em tese, concordo. Em tese, dizer “hey, navega para o aeroporto e põe uma playlist de rock dos anos 90” é mais natural do que decorar comandos rígidos.
Na prática, três problemas aparecem:
1. Latência acima do limiar de segurança
A literatura da NHTSA, estudos do MIT e do Volvo Cars Safety Centre aponta 1,5–2 segundos como o tempo máximo aceitável para um comando de voz manter o foco do condutor na estrada. Acima disso, o cérebro começa a desviar atenção do trânsito para a interface. Gemini, mesmo em condições ideias (rede estável, modelo enxuto, cache quente), está no limite. Quando a rede oscila, e em estradas portuguesas ou brasileiras oscila muito, passa desse limiar com folga.
2. Custo de reformulação quando o modelo erra
Quando o Gemini não entende à primeira, o condutor reformula. Reformular = mais 2–5 segundos de fala + atenção desviada. O Assistente antigo raramente falhava; quando falhava, era óbvio (“não entendi”). O Gemini falha de forma ambígua: às vezes responde, mas à coisa errada, e o utilizador só descobre olhando para o ecrã — que é o que deveria estar a evitar.
3. Dissolução do “contrato de comando”
Comandos estruturados criam um contrato claro: eu sei que dizer “ligar para mãe” funciona. Com LLM, esse contrato dissolve-se. O utilizador passa a adivinhar o que o modelo entende — o que é cognitivamente caro. É o mesmo problema que devs enfrentam quando expõem uma API mal documentada: o cliente nunca sabe se a chamada vai funcionar até tentar.
Não é por acaso que o post no Reddit citado pela fonte — “Convinced Gemini has or will increase car accidents and road rage”, do utilizador L00k_Again — ganhou tração. O problema é sistémico, não reclamação isolada.
Na prática: como eu construiria um assistente veicular com IA em 2026
Nos últimos anos trabalhei em projetos de voz — desde bots para WhatsApp Business até assistentes para painéis industriais. A regra de ouro que aprendi foi: quanto mais crítica a interface, menos LLM, mais máquina de estados finita.
Se eu tivesse de desenhar hoje um assistente veicular com IA, faria assim:
- Camada rápida (sempre on-device): classificador de intenções leve, offline, cobrindo 90% dos comandos críticos. Resposta em <300ms.
- Camada IA (opt-in, com timeout): Gemini/GPT só para perguntas conversacionais (“qual é a capital do Brasil?”, “conta uma piada”). Resposta pode demorar 1–3s, sem bloquear comandos críticos.
- Wake-word + VAD agressivo: detetar fim de fala rapidamente (≤200ms de silêncio) e cortar processamento para libertar CPU.
- Fallback visual imediato: mostrar o que o sistema entendeu em <300ms, para o utilizador confirmar ou cancelar.
- Hard timeout no LLM: se a camada IA não responder em 2s, descartar e cair no classificador rápido.
// Arquitetura híbrida: classificador rápido + LLM opt-in
class HybridVoiceAssistant {
  async process(audioBuffer) {
    // Camada 1: classificador rápido, on-device, sem rede
    const fastIntent = await fastClassifier.predict(audioBuffer);

    // Comandos críticos (navigation, call, music) → execução direta
    if (fastIntent.confidence > 0.85 && fastIntent.isCritical) {
      return execute(fastIntent); // <300ms
    }

    // Camada 2: LLM só se houver rede e for pergunta conversacional
    if (navigator.onLine && fastIntent.isConversational) {
      const llmResponse = await gemini.process(audioBuffer, {
        timeout: 2000,         // hard timeout obrigatório
        fallback: fastIntent,  // se Gemini falhar, usa classificador
        model: "gemini-nano"   // menor latência possível
      });
      return llmResponse;
    }

    // Fallback final: sempre responde, mesmo offline
    return execute(fastIntent);
  }
}
Este padrão é o que a Google deveria ter implementado em vez de substituir 1:1 o assistente antigo. Não fizeram porque, provavelmente, o objetivo do produto era marketing ("agora temos IA no carro"), não segurança. Engenharia de produto, mais uma vez, perdeu para engenharia de keynote.
Erros comuns que devs cometem ao colocar LLM em interfaces críticas
Vejo estes deslizes constantemente em code reviews de projetos de voz:
- Enviar áudio bruto para o LLM sem pré-processamento. Ruído de estrada, AC, música → transcrições erradas. Sempre passa por VAD (Voice Activity Detection) e beamforming antes de chegar ao modelo.
- Não definir timeout agressivo. Um LLM pode demorar 10 segundos sem rede. Em carro, isso é negligência. Hard timeout de 2s, sempre.
- Confiar na confiança do modelo sem fallback. "O Gemini disse que entendeu" não é prova. Precisas de uma camada de baixo risco para confirmar.
- Ignorar o orçamento de atenção do utilizador. Se a interface exige 3 interações para uma tarefa simples, está partida. É a Lei de Fitts aplicada a voz: cada interação extra custa tempo cognitivo.
- Substituir interface, em vez de aumentá-la. O Gemini deveria estar junto com o assistente antigo. Substituir apaga 10 anos de muscle memory dos utilizadores e quebra a confiança.
- Não testar com ruído real. Testar no escritório com microfone de mesa dá 95% de acerto. Testar com janela aberta a 100km/h dá 60%. É um mundo diferente.
Alternativas que funcionam (e o que a indústria já faz melhor)
Não estou a inventar o caminho — a indústria já o percorreu:
- Cerence (ex-Nuance) ainda domina os assistentes OEM (BMW, Mercedes, Ford). Usa modelos híbridos de NLU + LLM opcional e mantém latência <500ms.
- Apple CarPlay continua a permitir Siri clássico em muitas funções. A Apple foi mais conservadora por uma razão: testes de usabilidade veicular custam milhões e geram dados reais.
- Android Automotive (não Auto) — o sistema embedded dos carros Polestar, Volvo, Renault — tem acesso direto ao hardware do carro, sem o telemóvel no meio. Esse é o futuro a sério.
- Sensory e SoundHound continuam a treinar modelos especificamente para voz veicular, não LLMs genéricos.
A Google poderia ter seguido a Cerence: LLM como camada de enriquecimento, com classificador rápido como backbone. Em vez disso, fez um MVP de marketing que agora está a pagar o preço nos fóruns de utilizadores.
FAQ — Perguntas que devs costumam fazer sobre voz + LLM
1. Mas o Gemini não corre on-device em modelos pequenos como o Gemini Nano?
Corre, e o Gemini Nano está no Pixel. Mas o problema não é só latência — é a qualidade da intenção extraída. Modelos pequenos entendem mal comandos com ruído ambiente. Mesmo no telemóvel, a precisão cai bastante em condições reais de carro (janela aberta, AC, música, estrada molhada).
2. Não dá para resolver com streaming de áudio e resposta parcial?
Dá, e é uma boa otimização. Mas não resolve o problema central: comando crítico (navegar, ligar) tem de ser executado em <500ms. Streaming ajuda em respostas longas (contar uma história, ler uma morada completa), não em comandos críticos onde cada token importa.
3. Vale a pena usar Whisper + LLM local (Llama, Mistral) para um projeto de assistente veicular?
Para um projeto pessoal ou protótipo, sim. Para produção em massa, o custo de manter o modelo, treinar para o domínio veicular, e validar safety é enorme. Por isso a indústria paga caro em soluções como Cerence e SoundHound — elas já têm os dados e a validação.
4. Por que a Google não fez isto melhor? Eles têm os melhores engenheiros do mundo.
Hipótese minha, baseada no que vejo em big tech: pressão de marketing e competitividade com OpenAI/Claude. Lançar "Gemini no carro" soa bem em keynote. Lançar "assistente híbrido com classificador on-device" não. Engenharia de produto, mais vezes do que deveria, perde para engenharia de PowerPoint.
5. Como programador, devo evitar LLM em interfaces de voz?
Não deves evitar — deves usar com critério. LLM para enriquecer (contexto, follow-ups, conversação aberta). FSM/classificador para executar (comandos críticos). O erro é tratar o LLM como substituto, não como complemento.
Veredicto
O Gemini no Android Auto não é mau porque é IA. É mau porque substituiu um sistema otimizado para latência por um sistema otimizado para flexibilidade. Quando a interface é crítica — carro, avião, bloco operatório, central nuclear —, flexibilidade tem de ser opt-in, não default.
Se és programador e estás a desenhar uma interface por voz — carro, industrial, médica, qualquer uma com restrição de tempo —, lembra-te disto: o melhor LLM é aquele que o utilizador não percebe que está lá. Latência > inteligência, sempre que houver um humano em risco.
Gostou? Me segue no GitHub e deixa um comentário se tiveres dúvida ou quiseres aprofundar algum ponto.