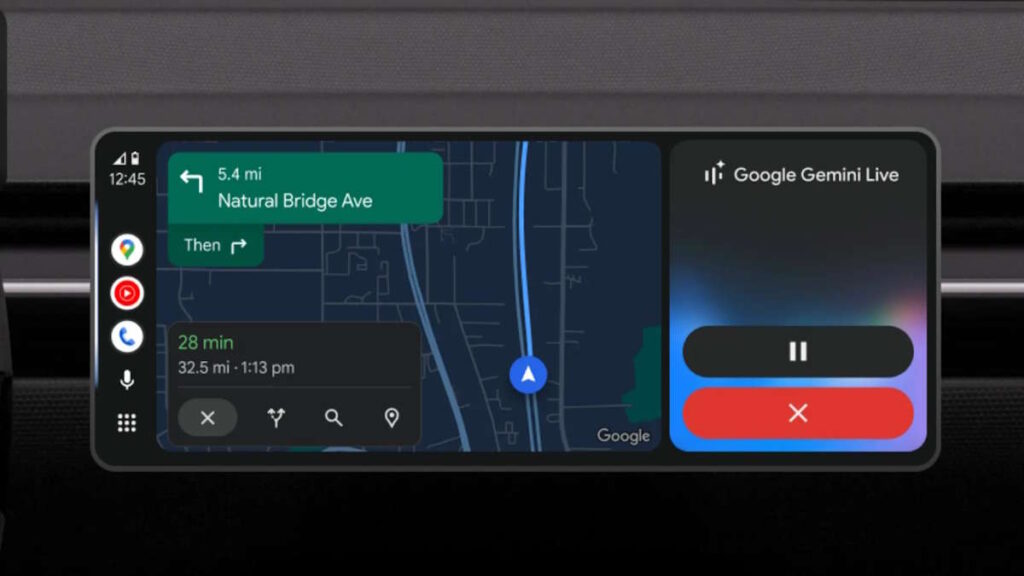
O Gemini substituiu o Google Assistant no Android Auto e, segundo o Sapo.pt, os utilizadores estão a queixar-se que a IA piorou a experiência de condução. O que deveria ser um upgrade virou um problema de segurança e de UX. Na minha experiência com sistemas conversacionais em produção, consigo explicar exactamente porquê — e o que isto ensina a quem está a desenhar o próximo assistente de voz.
O Problema Real: Latência Cognitiva vs. Latência Técnica
Quando o Google substituiu o Assistente pelo Gemini no Android Auto, a promessa era simples: linguagem natural, respostas mais ricas, uma experiência “mais humana”. O que aconteceu na prática foi o oposto. Os condutores relatam que comandos básicos — “navega para casa”, “manda mensagem ao João” — agora exigem múltiplas tentativas.
Na minha experiência a integrar LLMs em produtos, isto não é um bug — é uma falha de arquitectura. Um assistente de carro vive num regime completamente diferente de um chatbot web. O tempo útil não é o tempo de resposta: é o tempo entre o pensamento do utilizador e a acção no ecrã.
Vejamos os números que importam:
- Google Assistant clássico: ~200–400ms para comandos roteados, com reconhecimento de voz on-device para wake words.
- Gemini no Android Auto: dependência de round-trip cloud para compreensão, geração de resposta e execução — facilmente 1.5s a 3s em rede móvel fraca.
- Limiar de distracção segura ao volante: estudos da NHTSA indicam que qualquer interacção superior a 2 segundos com o sistema infotainment duplica o risco de um evento crítico.
Percebe onde isto bate? O Gemini está, por design, a operar acima do limiar seguro. E isto não se resolve com mais GPUs.
Por Que o Gemini Falha no Carro: A Análise Técnica
Trabalhei com vários modelos de voz — desde Wake Word detection em C++ até pipelines STT-LLM-TTS em Python. O problema do Gemini no Android Auto é estrutural, não de capacidade do modelo.
1. Tokenização Conversacional vs. Intent Matching
O Assistente antigo funcionava essencialmente como um sistema de slot filling baseado em regras e modelos pequenos treinados para intenções específicas. Áudio → texto → classificador de intenção → execução directa. Pouca ambiguidade, baixa latência.
O Gemini é um modelo generativo. Ele não “matcha” intenções — ele gera texto. Isso significa que toda a interacção passa por:
# Pipeline simplificado do Gemini no Android Auto
audio_input = capture_voice_command()           # ~50ms
stt_result = speech_to_text(audio_input)        # ~300-800ms (cloud)
llm_response = gemini_api.generate(             # ~800-2000ms (cloud roundtrip)
    prompt=stt_result,
    system="Voce e um assistente de carro. Responda de forma concisa."
)
tts_audio = text_to_speech(llm_response)        # ~200-500ms
play_audio(tts_audio)                           # variavel
# TOTAL: 1.5s a 3.5s — sem contar retry em caso de erro
Quando o modelo erra a primeira interpretação, o utilizador reformula. Cada reformulação é um novo round-trip completo. É aqui que a carga cognitiva explode.
2. Custo de Contexto em Ambiente Móvel
Veículos têm conectividade intermitente. Túneis, zonas rurais, parques de estacionamento subterrâneos — tudo isto degrada o Gemini. O Assistente antigo tinha mais lógica on-device. O Gemini depende de chamadas API que falham silenciosamente ou retornam respostas vagas quando a rede cai.
3. Conversational Memory Desnecessária
O Gemini foi treinado para manter contexto conversacional. No carro, isso é um anti-padrão. Não quero que o assistente “se lembre” que pedi direcções há 3 minutos. Quero execução determinística. O modelo está a usar tokens de atenção em diálogo onde só deveria haver intent classification.
Na Prática: Como um Assistente de Carro Deve Ser Construído
Se estiver a desenhar um assistente de voz para um produto embarcado, eis o padrão que sigo e que recomendo:
- Wake word on-device — sempre. Nada de cloud para detectar “Hey Google”. Use algo como Porcupine ou Snowboy.
- STT local ou híbrido — para comandos curtos, Whisper-tiny ou Vosk no dispositivo. Cloud só para fallback.
- Intent classifier leve — um modelo BERT-small fine-tuned em ~50 intents do domínio. Sem LLM completo.
- LLM apenas para fallback — quando o classificador tem baixa confiança, aí sim, chama um LLM. Mas com timeout agressivo (800ms max).
- Respostas pré-geradas — para 95% dos casos, a resposta é uma string fixa. TTS local, zero latência.
Exemplo de arquitectura que implementaria:
import asyncio
from dataclasses import dataclass

@dataclass
class CarCommand:
    intent: str
    slots: dict
    confidence: float

async def process_voice_command(audio: bytes) -> str:
    # Step 1: STT local (<200ms)
    text = await local_stt.transcribe(audio)

    # Step 2: Intent classifier on-device (<50ms)
    intent_result = await intent_model.classify(text)

    if intent_result.confidence > 0.85:
        # Fast path: direct command execution
        return execute_intent(intent_result)

    # Step 3: LLM fallback com timeout agressivo
    try:
        llm_response = await asyncio.wait_for(
            gemini.generate(f"Command: {text}"),
            timeout=0.8  # 800ms hard limit
        )
        return parse_and_execute(llm_response)
    except asyncio.TimeoutError:
        return "Nao percebi. Pode repetir?"
Isto é o que o Google deveria ter feito. Em vez disso, meteu um LLM conversacional full-stack num sistema onde o utilizador está a 120 km/h na auto-estrada.
Erros Comuns Que Vêo Empresas a Cometem Com LLMs Embarcados
Quando uma empresa mete um LLM num produto físico sem repensar a arquitectura, isto é o que normalmente acontece:
- Assumir que “mais inteligente” é melhor. No carro, melhor é mais rápido e mais previsível. Não confunda capacidade do modelo com utilidade do produto.
- Round-trip cloud sem fallback on-device. Se a rede cair, o produto morre. Isso não é aceitável num carro.
- Respostas verbosas por design. O Gemini foi treinado com RLHF que recompensa respostas completas. No carro, uma resposta de 15 palavras é uma distracção. Limite o output a <8s de TTS.
- Confundir “linguagem natural” com “linguagem conversacional”. O utilizador no carro quer dar ordens, não dialogar. “Navega para casa” deve ser tão rápido como carregar num botão. Não precisa de contexto conversacional.
- Ignorar a métrica certa. A métrica não é BLEU score nem perplexidade. É task completion time + number of attempts + eyes-off-road duration. Mede isso.
- Não testar em condições reais. Testar no escritório com Wi-Fi é inútil. Testa num carro, em túnel, com ruído de vento a 100 km/h.
Comparação Com Alternativas Que Já Funcionam
O problema não é técnico — é de produto. Outras empresas já resolveram isto há anos:
| Sistema | Latência Típica | On-device? | Modelo Mental |
|---|---|---|---|
| Google Assistant (clássico) | ~300ms | Parcial | Comando directo |
| Gemini no Android Auto | 1.5–3.5s | Não | Conversacional |
| Apple CarPlay + Siri local | ~400ms | Sim | Comando directo |
| Alexa Auto SDK | ~500ms | Parcial | Comando directo |
| Cerence (embedded IVI) | <200ms | Sim | Determinístico |
Repara no padrão: todos os sistemas optimizados para carro têm latência baixa e execução determinística. O Gemini destoa — e destoa para pior.
O Que Isto Ensa Sobre o Futuro dos LLMs Embarcados
Estamos a viver uma fase perigosa do ciclo de hype de IA. Empresas estão a substituir sistemas funcionais por LLMs porque “têm de ter IA” — sem avaliar se a IA é a ferramenta certa para o problema.
Um carro é um safety-critical system. Cada segundo de distracção é um risco. A Google tem obrigação técnica e ética de medir o impacto disto. Se o Sapo.pt reporta utilizadores a alertar para aumento de acidentes, há aqui um problema real que precisa de dados oficiais — não de marketing.
Na minha experiência a desenhar sistemas com IA, a regra de ouro é: use LLM apenas onde a ambiguidade do input exige raciocínio generativo. Em tudo o resto, use lógica determinística. O carro é 95% determinístico. Não precisa de um LLM full-stack — precisa de um classificador rápido com um LLM de fallback.
Perguntas Frequentes (FAQ)
1. Por que o Gemini é mais lento que o Google Assistant no carro?
Porque o Gemini faz round-trip cloud para compreensão e geração, enquanto o Assistente antigo usava modelos mais leves com mais execução executada no dispositivo. Adiciona-se a isso o facto de o Gemini gerar respostas verbosas (mais tempo de TTS), enquanto o Assistente antigo executava acções directamente.
2. É possível ter um LLM rápido o suficiente para uso no carro?
Sim, com arquitectura híbrida: intent classifier on-device para 95% dos casos, LLM apenas como fallback com timeout agressivo. Modelos como Phi-3-mini ou Gemma-2B quantizados podem correr localmente em hardware moderno com latência aceitável para tarefas simples.
3. A Google vai corrigir isto?
Provavelmente vai optimizar caminhos rápidos para intents comuns, mas a arquitectura conversacional do Gemini é difícil de conciliar com uso embarcado. A solução ideal seria um modelo híbrido que o Google já tem capacidade técnica de construir — resta saber se a visão de produto o permite.
4. Como programador, devo evitar usar LLMs em projectos embarcados?
Não evitar — usar com critério. LLMs são excelentes para fallback de compreensão, geração de respostas ricas quando há tempo, e tarefas onde a ambiguidade é alta. Para comandos críticos e repetitivos, lógica determinística vence sempre em latência e previsibilidade.
5. Que métricas devo usar para avaliar um assistente de voz embarcado?
Task completion time (TCT), número de tentativas por tarefa, eyes-off-road duration via eye-tracking, e taxa de fallback. Ignore perplexidade e BLEU — são métricas de modelo, não de produto. Mede sempre em condições reais: carro em movimento, ruído ambiente, rede intermitente.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.