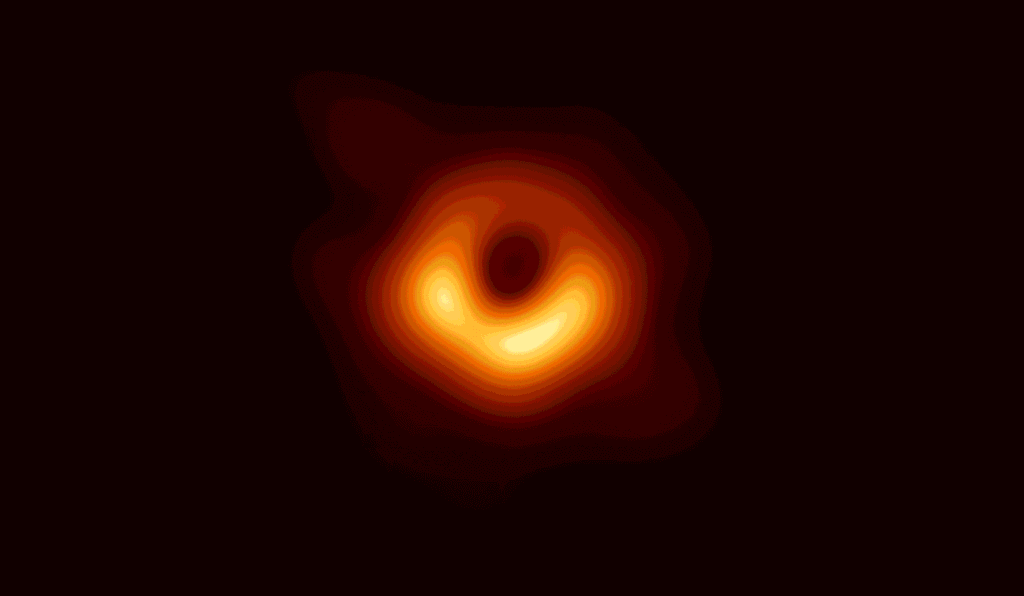
Quando o Event Horizon Telescope (EHT) entregou a primeira foto de um buraco negro em 2019, muita gente se perguntou por que diabos os dados não vieram pela internet. A resposta é simples e brutal: eram cinco petabytes de dados que precisavam chegar a um supercomputador em tempo útil. Segundo o Olhardigital.com.br, os arquivos foram fisicamente despachados em HDs dentro de malas de avião. E isso, para mim como dev, diz muito sobre os limites reais da infraestrutura que a gente usa todos os dias.
Por que a internet não foi suficiente — e o que isso ensina para devs
Cinco petabytes é o equivalente a algo entre 4.000 e 5.000 HDs domésticos de 1 TB lotados. Mesmo em uma rede corporativa de 10 Gbps — que já é absurda para a maioria das empresas —, transferir isso levaria mais de 50 dias contínuos. E olha que estou sendo generoso, porque a latência, a perda de pacotes e a própria topologia da internet pública fariam esse número explodir para meses.
O time do EHT não tinha meses. Eles tinham uma janela climática alinhada entre Havaí, Arizona, México, Chile, Espanha e Antártida. Quando o tempo fechou em abril de 2017, foi “agora ou nunca”. Depois, os discos rígidos foram embarcados fisicamente para o consórcio Max Planck, na Alemanha, onde os dados seriam correlacionados. Foi literalmente o método mais rápido disponível.
Para quem trabalha com pipelines de dados, big data ou machine learning, isso é um soco no estômago. A gente constrói toda a nossa cultura em cima da premissa de que “tudo vai pela rede”. Mas quando o volume ultrapassa certo limiar, a física vence o protocolo TCP.
Como o VLBI funciona — e por que isso parece mágica
O VLBI (Very Long Baseline Interferometry) é a técnica que permitiu esse feito. Cada uma das oito antenas apontou para M87* ao mesmo tempo, registrando o mesmo sinal de rádio com uma precisão temporal absurda — da ordem de nanossegundos. Para isso, cada estação tinha um relógio atômico de maser de hidrogênio marcando o instante exato da chegada da onda eletromagnética.
O detalhe genial é que não estamos enviando “imagens” pela rede. Estamos enviando registros de amplitude e fase do sinal, com timestamps de altíssima precisão. Quando os supercomputadores correlacionam tudo, eles sintetizam um radiotelescópio virtual do tamanho da Terra.
Na prática, é a mesma lógica de um sistema distribuído onde cada nó registra eventos com timestamps sincronizados. A diferença é que, em vez de servidores NTP, eles usam relógios atômicos de milhões de dólares.
O volume por trás da façanha
Cada antena gerou em torno de 1 a 2 Gbps de fluxo contínuo durante a observação. Multiplicando pelas oito estações, durante uma janela de poucos dias, você chega facilmente aos cinco petabytes. Depois disso, ainda vem o processo de correlação cruzada — que gera mais alguns petabytes de dados intermediários.
Para um dev, isso é o equivalente a processar logs de produção de uma empresa de porte médio durante meses, mas com a diferença de que você não pode simplesmente “rodar de novo”. Os dados do EHT são únicos: o buraco negro vai estar lá, mas a configuração atmosférica daquele exato momento não se repete.
Na Prática: simulando sincronização temporal entre nós
Como devs, podemos não ter relógios atômicos, mas lidamos constantemente com sistemas distribuídos onde a ordem temporal dos eventos importa. Quando você distribui um job de processamento em múltiplos workers, por exemplo, precisa garantir que os timestamps sejam consistentes. Vou mostrar um exemplo simples em Python que simula parte dessa lógica de sincronização:
import time
import hashlib
from datetime import datetime, timezone

class AtomicLikeClock:
    """Simula um relógio de alta precisão para sincronização distribuída."""

    def __init__(self, station_id, drift_ns=0):
        self.station_id = station_id
        self.drift_ns = drift_ns  # drift artificial em nanossegundos
        self.epoch = time.time_ns()

    def now(self):
        # Aplica o drift simulando um relógio atômico imperfeito
        return self.epoch + self.drift_ns

    def record_signal(self, signal_data):
        timestamp = self.now()
        payload = f"{self.station_id}|{timestamp}|{signal_data}"
        checksum = hashlib.sha256(payload.encode()).hexdigest()[:16]
        return {
            "station": self.station_id,
            "timestamp_ns": timestamp,
            "data": signal_data,
            "checksum": checksum,
            "iso": datetime.fromtimestamp(
                timestamp / 1e9, tz=timezone.utc
            ).isoformat()
        }

# Três "antenas" registrando o mesmo evento cósmico
stations = [
    AtomicLikeClock("HAW", drift_ns=0),
    AtomicLikeClock("CHL", drift_ns=150),       # 150 ns de drift
    AtomicLikeClock("ESP", drift_ns=-75),       # -75 ns de drift
]

observations = []
for s in stations:
    obs = s.record_signal("M87_radio_burst")
    observations.append(obs)
    print(f"[{s.station_id}] {obs['iso']} -> {obs['checksum']}")

# Ordenando pela "ordem real" do evento
observations.sort(key=lambda x: x["timestamp_ns"])
print("\nOrdem correlacionada após sincronização:")
for obs in observations:
    print(f"  {obs['station']} @ {obs['timestamp_ns']} ns")
Esse código não faz correlação real de sinais, mas mostra a espinha dorsal do problema: cada nó registra um evento, com um timestamp próprio, e depois um sistema central precisa juntar tudo respeitando a ordem temporal. É a mesma família de problemas que você resolve em Kafka, em event sourcing ou em bancos de dados distribuídos como Cassandra.
Comparação: quando o transporte físico ainda vence
Esse caso do EHT não é único. A Amazon, por exemplo, já usou o serviço “AWS Snowmobile” para migrar petabytes de dados de clientes para a nuvem — literalmente um caminhão cheio de HDs chegando no data center. O Google tem o “Transfer Appliance”, um rack de hardware que você pluga no seu datacenter, enche de dados e devolve para o Google.
Para devs, a lição é clara: quando você está projetando uma arquitetura, sempre faça a conta de “quanto tempo leva para mover esse volume”. Existe uma fórmula simples:
def tempo_transferencia(tamanho_gb, largura_mbps):
    bits = tamanho_gb * 8 * 1024 * 1024 * 1024
    segundos = bits / (largura_mbps * 1_000_000)
    dias = segundos / 86400
    return dias

# Exemplo: 5 PB = 5.000.000 GB
print(f"5 PB @ 1 Gbps: {tempo_transferencia(5_000_000, 1000):.1f} dias")
print(f"5 PB @ 10 Gbps: {tempo_transferencia(5_000_000, 10_000):.1f} dias")
print(f"5 PB @ 100 Gbps: {tempo_transferencia(5_000_000, 100_000):.1f} dias")
O resultado não mente: mesmo em 100 Gbps — uma rede que pouquíssimas empresas no mundo têm —, são quase 5 dias contínuos de transferência sem nenhum tipo de overhead. E aqui no Brasil, a maioria das empresas roda em 1 Gbps ou menos.
Erros Comuns — o que devs fazem de errado com dados grandes
Na minha experiência, vejo três erros recorrentes que travam projetos antes mesmo de começar:
- Ignorar o custo de transferência real. O time joga 500 GB para a AWS S3 achando que “é rápido”, só para descobrir que a conta do egress bate R$ 30.000. O EHT fez a conta direito: para cinco petabytes, não existe pipe que salve.
- Não comprimir antes de transferir. Dados científicos, logs e datasets de ML geralmente comprimem 5x a 10x. Antes de pensar em pipe maior, tente
gzip,zstdouparquetcom Snappy. Para o EHT, isso não era viável porque os dados já vinham em formato bruto de radiotelescópio, mas em 99% dos casos de dev, é. - Subestimar a latência da sincronização. Cada estação do EHT tinha que estar alinhada com precisão sub-nanossegundo. Em sistemas distribuídos comuns, devs assumem que “NTP resolve”. Para alguns casos resolve. Para transações financeiras, telemetria de alta frequência ou pipelines de eventos ordenados, NTP não chega perto.
- Confundir throughput com bandwidth. Ter 10 Gbps de banda não significa mover 10 GB em 8 segundos — significa que, em condições ideais, no melhor dos casos. Em produção, com TCP overhead, retransmissões e congestionamento, você opera em 60-70% do nominal. Sempre.
O que devs podem tirar de lição disso
Três coisas ficam óbvias quando você olha para o EHT com olhos de engenheiro:
- Quando o dado é grande demais, a solução física ainda é válida. Não existe vergonha em mandar HD pelo correio se for a opção mais rápida e barata. O importante é saber calcular.
- Timestamps e sincronização são features, não detalhes. O EHT investiu milhões em relógios atômicos porque sem eles a correlação não funciona. Em qualquer sistema distribuído que você desenhar, o relógio é parte da arquitetura, não afterthought.
- A ciência ainda depende de engenharia engenhosa. A foto do buraco negro é celebrada como uma conquista da astrofísica, mas foi uma vitória de DevOps, SRE, storage engineering e logística. A mesma combinação de disciplinas que move o seu pipeline de produção.
FAQ — Perguntas que devs realmente fazem
Por que não usaram a internet acadêmica de alta velocidade?
Até as redes de pesquisa mais rápidas do mundo, como a Internet2 nos EUA ou a GÉANT na Europa, operam na casa de centenas de Gbps compartilhados entre milhares de instituições. Para uma transferência síncrona de 5 PB com janela curta, mesmo essas redes não dariam conta sem impactar outros projetos. O transporte físico eliminou a disputa por recursos.
Os dados não poderiam ter sido pré-processados nas antenas?
Em teoria sim, mas o processamento exigiria poder computacional significativo em locais remotos como a Antártida, onde a logística de manter supercomputadores é inviável. Mais importante: os dados brutos contêm informação de fase que se perde em qualquer compressão com perdas. Para correlação VLBI, o sinal cru é insubstituível.
Hoje em dia, com Starlink e fibras modernas, isso ainda aconteceria?
Provavelmente não na mesma escala. Em 2017, muitas das estações envolvidas tinham conectividade limitada — a base da Antártida, por exemplo, depende de satélites com banda modesta. Em 2026, com Starlink e fibras submarinas de 400 Gbps, o limiar em que o transporte físico vale a pena subiu bastante. Mas para projetos que geram dezenas de petabytes em janelas curtas, ainda é uma opção válida.
Quanto custaria transmitir 5 PB pela AWS Direct Connect hoje?
Usando uma porta de 10 Gbps em uso contínuo, o egress na AWS sairia na faixa de US$ 200.000 só em transferência (a US$ 0,02/GB). Fora o custo da porta dedicada, que passa fácil de US$ 10.000/mês. Mandar HDs por correio é absurdamente mais barato.
Qual a relação entre VLBI e sistemas distribuídos modernos?
A mesma família de problemas: múltiplos pontos coletando dados independentes, sincronização temporal, correlação tardia. Tecnologias como Apache Kafka, event sourcing e até blockchain derivam conceitualmente desse mesmo desafio — só que em escala e contexto diferentes.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.