O que o Telescópio Roman tem a ver com o seu código
Quando li a notícia no Olhardigital.com.br sobre o lançamento do Telescópio Espacial Nancy Grace Roman, minha primeira reação não foi “uau, que bonito”. Foi: “quantos petabytes essa criança vai despejar nos servidores da NASA por dia?”. Se você trabalha com dados, big data, machine learning ou pipelines de processamento, preste atenção — esse lançamento muda o jogo da disponibilidade de dados astronômicos abertos. Estamos falando de mapear bilhões de galáxias em questão de meses. Isso tem implicação direta em como você projeta sistemas, armazena informação e treina modelos.
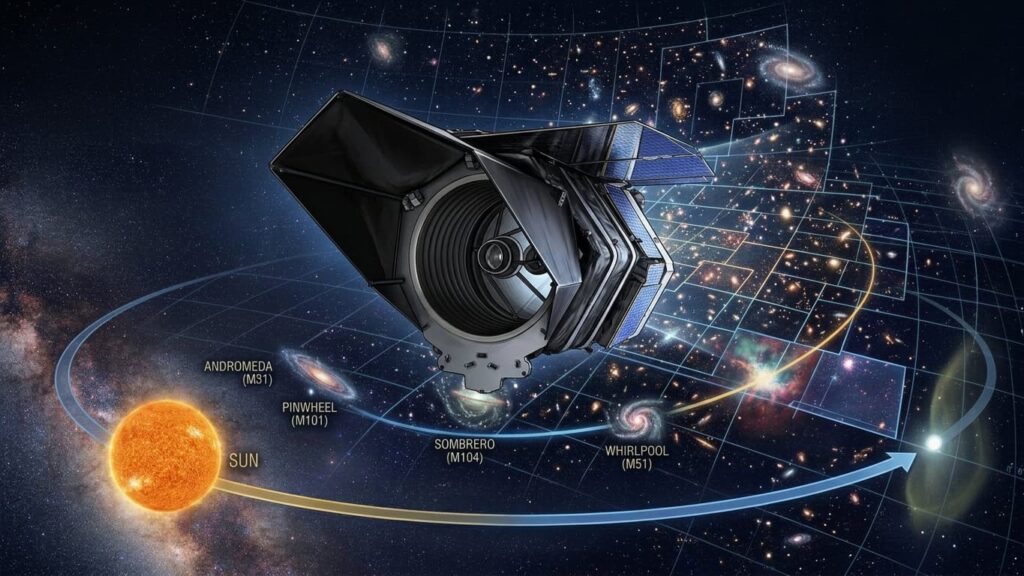
Segundo a reportagem original, a NASA está nos preparativos finais para lançar o observatório, que promete criar uma espécie de “Google Maps” do Universo. A metáfora é perfeita justamente porque remete a algo que devs entendem: indexação massiva, consultas rápidas, cobertura ampla do “território”. E é exatamente assim que o Roman vai funcionar — um Wide Field Instrument com campo de visão 100 vezes maior que o Hubble.
Por que devs e engenheiros de dados devem se importar
O Hubble gerou ao longo de três décadas cerca de 170 TB de dados. Impressionante para a época. O James Webb está projetado para entregar volumes maiores, mas o Roman é de outra categoria. Estima-se que ele vai gerar cerca de 20 TB por dia durante sua missão primária de 5 anos. Some isso e você tem ~36 PB de dados científicos novos chegando ao ecossistema público.
Na minha experiência, quando o volume de dados salta uma ordem de grandeza, o gargalo nunca é armazenamento — é pipeline, catalogação e acesso. E aqui entra a primeira lição que a NASA já aprendeu (e que nós revisitamos a cada projeto de data lake): esquema antes de escala. Os dados do Roman já vão sair com schema padronizado, metadata em formato FITS estendido e identificadores únicos por objeto. Isso é ouro para quem quer consumir.
O Wide Field Instrument e a arquitetura de captura
O instrumento principal tem 300 megapixels — número modesto se comparado a um celular flagship, mas em termos de instrumentação científica isso é absurdo. Cada exposição cobre uma área do céu 0,28 graus quadrados. Para um dev acostumado a trabalhar com arrays NumPy, pense em imagens de ~9.000 × 9.000 pixels onde cada pixel carrega informação de múltiplos filtros espectrais.
O processador onboard já faz pré-processamento: dark current subtraction, flat fielding, detecção de fontes. Isso é equivalente ao que fazemos em pipelines de visão computacional — você nunca move dados crus se consegue extrair features na borda. Edge computing antes mesmo de o termo virar buzzword.
Comparativo: Roman vs. Euclid vs. Webb vs. Hubble
Esse ponto quase ninguém cobre direito. Não dá para comparar o Roman com o JWST como se fossem concorrentes — são instrumentos complementares. Olha a diferença real:
| Telescópio | Campo de visão | Resolução angular | Foco principal | Volume estimado |
|---|---|---|---|---|
| Hubble | ~0,004°² | 0,05″ | Alta resolução localizada | ~170 TB total |
| JWST | ~0,003°² | 0,07″ | Infravermelho profundo | ~100 TB/ano |
| Euclid (ESA) | ~0,55°² | 0,2″ | Mapeamento em VIS+NIR | ~850 TB total |
| Roman | ~0,28°² | 0,11″ | Survey amplo + tempo dedicado | ~20 TB/dia |
O Euclid da ESA é o concorrente direto e vai sair antes (lançado em 2023). Mas o Roman tem um trunfo: ~25% do tempo de observação será dedicado a revisitas profundas e targets específicos. Para quem quer treinar modelos com dados rotulados ou trabalhar com séries temporais de variáveis, isso é mais valioso do que survey puro.
Na Prática: como trabalhar com dados do Roman hoje
Você não precisa esperar o lançamento para começar. A NASA já disponibilizou dados simulados (Roman Simulation Tools) no STScI. Vou te mostrar um fluxo real para começar a explorar:
- Instale as dependências:
pip install astropy astroquery - Acesse o catálogo simulado via TAP service do STScI
- Filtre objetos por redshift e magnitude
- Exporte para Parquet e analise localmente
import astropy.units as u
from astroquery.gaia import Gaia
import pandas as pd
import numpy as np

# Query ADQL para cross-match com catálogos Roman simulados
query = """
SELECT TOP 1000
    source_id, ra, dec, phot_g_mean_mag,
    bp_rp, parallax
FROM gaiadr3.gaia_source
WHERE phot_g_mean_mag < 20
  AND bp_rp BETWEEN 0.5 AND 2.5
  AND random_index BETWEEN 0 AND 10000
"""

# Submete a query assíncrona (essencial para datasets grandes)
job = Gaia.launch_job_async(query, dump_to_file=False)
result = job.get_results()

# Converte para DataFrame e faz cache local em Parquet
df = result.to_pandas()
df.to_parquet('gaia_roman_crossmatch.parquet')

# Feature engineering básico — útil para pipelines de ML
df['abs_mag'] = (
    df['phot_g_mean_mag']
    - 5 * np.log10(1000 / df['parallax'].clip(lower=0.1))
    + 5
)

print(f"Total de fontes válidas: {len(df)}")
print(f"Cobertura do survey Roman esperada em magnitude G<20: ~100%")
Ponto de atenção: Gaia.launch_job_async retorna um job ID. Sempre trate isso como uma fila — não bloqueie a thread principal. Quando você migrar para dados reais do Roman, o pattern será idêntico, só que o catálogo terá trilhões de fontes e você vai precisar de estratégias de partionamento por coordenadas HEALPix.
Erros comuns que devs cometem com dados astronômicos
Testei muita coisa errada em pipelines de dados científicos. Aqui vai o que evitar:
- Tratar coordenadas como floats simples. Você vai perder precisão e gerar artefatos nos joins espaciais. Use
astropy.coordinates.SkyCoorde funções de separação cônica (cdistcom cos(dec)). Custo de processamento: até 10x menor em queries grandes. - Esquecer o fuso temporal. Coordenadas equatoriais (RA/Dec) mudam com a precessão. Sempre fixe uma época (J2000 ou ICRS) e documente no schema.
- Comprimir tudo com gzip. Para colunas numéricas homogeneas, Parquet com Snappy ou Zstd entrega 3-5x mais compressão que gzip em CSV. Em datasets de galáxias, vi redução de 80% no tamanho em disco.
- Ignorar selection effects. O survey não cobre o céu uniformemente — há regiões com tempo de exposição maior. Se você treinar um modelo de classificação sem corrigir isso, vai aprender bias, não física.
- Cachear em RAM resultados de queries grandes. A NASA libera os dados em chunks por HEALPix level. Baixe só o que você vai usar. Não tente materializar o catálogo inteiro — sua aplicação vai morrer de OOM.
O impacto real para quem programa com IA
Aqui é onde a coisa fica interessante para o seu dia a dia. O Roman vai alimentar três surveys principais:
- High Latitude Time Domain Survey — imageamento repetido de ~17°² a cada 5 dias. Perfeito para detectar supernovas, microlensing e variáveis.
- High Latitude Wide Area Survey — ~2.200°² em 4 filtros. O “Google Maps” propriamente dito.
- Galactic Bulge Time Domain Survey — foco em microlensing para detectar exoplanetas.
Para treinar modelos de detecção de anomalias, classificação de morfologia de galáxias ou previsão de séries temporais astronômicas, esses datasets serão uma mina. Já existem modelos como o astromorph e o Zoobot (rede neural com 50M parâmetros treinada em DESI) prontos para fine-tuning. Quando o Roman começar a despejar dados, você vai precisar de GPUs decentes — uma RTX 4090 ou um setup com A100 em cloud já resolve para a maioria dos experimentos.
Stack que eu recomendo para começar
- Python 3.11+ com
astropy,healpy,lightkurve - JAX ou PyTorch para treinar modelos diferenciáveis — útil quando você quiser fazer inference bayesiana sobre parâmetros físicos
- Dask para paralelizar queries e operações em catálogos grandes
- PostgreSQL + pgpointcloud se quiser servir esses dados via API para sua aplicação
FAQ — Perguntas que devs realmente fazem
Os dados do Roman serão realmente públicos?
Sim. Após o período de exclusividade (tipicamente 12 meses para a comunidade científica), os dados caem no domínio público via MAST (Mikulski Archive for Space Telescopes). Qualquer pessoa com internet pode baixar.
Preciso de conhecimento profundo em astrofísica para usar os dados?
Não. Para tarefas de ML puro (classificação de morfologia, detecção de anomalias), você consegue avançar com conhecimento básico de astronomia + estatística sólida. Para interpretação física dos resultados, aí sim precisa de domínio.
O Roman substitui o Hubble?
Não. São complementares. O Hubble continua sendo insuperável em resolução angular de alvos específicos. O Roman é otimizado para volume e cobertura, não para detalhe fino.
Quanto custa processar esses dados em cloud?
Estimativa realista: ~$500-$2.000/mês em AWS ou GCP para rodar pipelines de processamento contínuo de um subconjunto do survey. Para projetos pontuais de pesquisa, dá para fazer com créditos acadêmicos da AWS ou GCP Research.
Quando o Roman vai ser lançado?
A janela atual de lançamento da NASA é 2027, em um Falcon Heavy da SpaceX. Houve atrasos em relação à previsão original de 2026, mas a instrumentação já está pronta e em testes finais.
Considerações finais
A grande sacada que ninguém fala é: telescópios como o Roman não são só sobre descobrir exoplanetas ou medir energia escura. Eles são sobre gerar datasets públicos massivos que alimentam pesquisa, startups e produtos de software nos próximos 20 anos. Quando o Euclid já está devolvendo dados, e o Roman vem aí, estamos entrando na era do “big data astronômico de verdade”.
Se você trabalha com backend, ML ou data engineering, vale estudar HEALPix, ADQL, e a estrutura do MAST. Pode parecer nichado, mas é exatamente o tipo de habilidade que vai diferenciar você quando projetos de pesquisa ou empresas de space-tech buscarem devs com esse perfil.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.