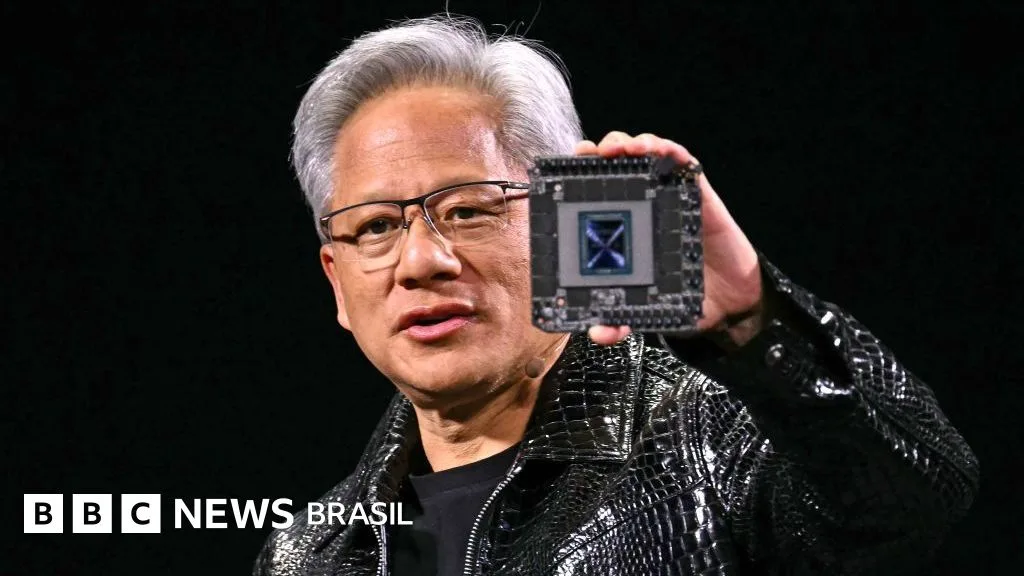
O ponto mais importante sobre a notícia atribuída ao BBC News não é o suposto drama pessoal de Jensen Huang: é que o trecho fornecido não basta para confirmar que ele pediu demissão nem que as alegações sobre sua vida privada sejam verdadeiras. Sem URL, data de publicação e confirmação independente, tratar isso como fato seria irresponsável. Para quem desenvolve software, a discussão útil é outra: como avaliar rumores sobre a liderança da Nvidia sem confundir manchete, risco de mercado e impacto técnico.
Segundo o material apresentado como sendo do BBC News, Huang teria deixado o cargo após relatos sobre sua vida pessoal. Eu não consigo autenticar essa publicação com as informações disponíveis aqui e, por isso, não vou reproduzir as acusações como fatos. Em empresas de tecnologia, a saída de um CEO pode ter consequências reais; uma alegação não verificada, por si só, não prova que essa saída aconteceu.
Jensen Huang, Nvidia e o que realmente importa para desenvolvedores
A Nvidia não é relevante para quem programa apenas por causa de seu CEO. Sua posição resulta de uma combinação de hardware, software e ecossistema: GPUs, bibliotecas como CUDA, ferramentas de desenvolvimento e uma ampla base de aplicações de computação acelerada. Essa combinação cria dependências técnicas e comerciais que podem afetar equipes de machine learning, infraestrutura e desenvolvimento de produtos.
Na prática, a troca de liderança — se confirmada em qualquer empresa desse porte — não significa que os repositórios, as APIs ou os contratos mudem no dia seguinte. O impacto costuma aparecer em decisões de investimento, prioridades de produto, disponibilidade de hardware, estratégia de software e relação com clientes. São sinais que precisam ser acompanhados com dados, não deduzidos de uma manchete.
Também é importante separar a Nvidia como companhia da Nvidia como plataforma de desenvolvimento. Um projeto pode depender de GPUs da marca, mas reduzir essa dependência com camadas de abstração, testes de compatibilidade e alternativas de execução. Isso não elimina custos de migração, mas evita que uma decisão estratégica de um fornecedor vire uma emergência técnica dentro do seu time.
Como um rumor sobre a liderança pode afetar o mercado de tecnologia
Uma notícia confirmada sobre a saída de um CEO pode influenciar ações porque investidores tentam estimar se a estratégia da companhia vai mudar. No caso da Nvidia, o mercado também observa a demanda por aceleradores, a concorrência, as restrições de exportação e o peso do software CUDA no ecossistema. Nenhum desses fatores, porém, pode ser avaliado apenas com base em especulação sobre uma pessoa.
Para quem trabalha com tecnologia, a pergunta mais prática não é “a ação vai subir ou cair?”. É “qual parte da minha arquitetura depende desse fornecedor, e quão caro seria substituí-la?”. Essa análise vale para a Nvidia, para provedores de nuvem, serviços de IA, bancos de dados gerenciados e qualquer plataforma que se torne central no produto.
CUDA é uma vantagem importante para workloads que já foram otimizados para GPUs Nvidia. Alternativas como ROCm, da AMD, e APIs mais portáveis podem ser adequadas em certos cenários, mas não são substitutos automáticos. Compatibilidade de bibliotecas, desempenho real, suporte operacional e disponibilidade de equipamentos mudam de projeto para projeto. Comparar somente preço por GPU costuma esconder parte do custo.
Dependência de CUDA: como reduzir lock-in sem reescrever tudo
Não recomendo abstrair cada operação desde o primeiro dia. Uma camada genérica demais pode esconder recursos importantes da GPU, complicar o debugging e reduzir o desempenho. Eu começaria identificando o que está efetivamente acoplado ao fornecedor: chamadas específicas, formato dos modelos, bibliotecas de inferência, scripts de implantação e métricas de monitoramento.
Depois, criaria uma fronteira pequena e explícita entre a aplicação e o provedor de inferência. A aplicação deveria depender de uma interface estável, enquanto cada implementação cuida das particularidades do backend. Assim, trocar de serviço ou testar um modelo local não exige espalhar condicionais por todo o código.
O exemplo abaixo usa apenas recursos padrão do Python. Ele não pretende substituir uma integração real com CUDA, ROCm ou uma API comercial; mostra como manter a aplicação desacoplada do fornecedor de inferência.
from typing import Protocol


class InferenceProvider(Protocol):
    def generate(self, prompt: str) -> str:
        ...


class LocalProvider:
    def generate(self, prompt: str) -> str:
        return f"Resposta do modelo local para: {prompt}"


class HostedProvider:
    def generate(self, prompt: str) -> str:
        return f"Resposta do serviço hospedado para: {prompt}"


def choose_provider(
    preferred: str,
    providers: dict[str, InferenceProvider],
) -> InferenceProvider:
    if preferred in providers:
        return providers[preferred]

    if not providers:
        raise ValueError("Nenhum provedor de inferência configurado")

    return next(iter(providers.values()))


providers: dict[str, InferenceProvider] = {
    "local": LocalProvider(),
    "hosted": HostedProvider(),
}

provider = choose_provider("local", providers)
print(provider.generate("Explique o resultado deste teste."))
O exemplo é simples de propósito. Em produção, eu acrescentaria timeouts, tratamento de erros, limites de custo, logs sem dados sensíveis e testes de contrato para garantir que todos os provedores respeitam o mesmo formato. O fallback também precisa ser uma decisão consciente: alternar para outro backend pode mudar latência, qualidade, custo e política de retenção de dados.
Na Prática: avaliando uma notícia e o risco técnico
- Verifique a publicação original. Procure a URL, a data e a autoria. Uma captura de tela ou um texto atribuído a um veículo não permite confirmar que a matéria foi publicada por ele.
- Busque confirmação independente. Para uma mudança executiva relevante, compare comunicados oficiais e veículos confiáveis. Diferencie notícia confirmada, relato atribuído a fontes e especulação.
- Separe pessoa, empresa e plataforma. Uma informação sobre o CEO não prova, por si só, uma mudança na estratégia de produto nem uma interrupção de serviços.
- Faça um inventário das dependências. Liste bibliotecas, imagens de contêiner, APIs, hardware e contratos que seriam afetados por uma mudança de fornecedor.
- Teste uma alternativa em um workload real. Compare latência, throughput, custo por requisição, qualidade de saída e esforço operacional. Um benchmark sintético isolado pode levar a uma escolha ruim.
- Defina critérios de migração. Registre quais mudanças justificariam sair de uma plataforma e quem tomaria essa decisão. Sem critérios, equipes podem reagir tarde demais ou migrar por ansiedade.
Erros comuns ao analisar rumores sobre empresas de tecnologia
- Repetir uma acusação como fato. Atribuir uma informação a um veículo sem verificar a publicação original pode espalhar conteúdo falso e causar danos pessoais. Alegações sobre a vida privada exigem cuidado especial.
- Confundir uma queda na bolsa com um problema técnico. Oscilações de mercado não demonstram que GPUs, SDKs ou serviços deixarão de funcionar. Decisões de arquitetura precisam de evidência operacional.
- Presumir que alternativa significa compatibilidade direta. Migrar código otimizado para CUDA para outro ecossistema pode exigir alterações, testes e ajustes de desempenho. Um nome parecido ou uma API parcialmente compatível não garante equivalência.
- Construir abstrações sem medir o custo. Uma interface ajuda quando reduz dependência concreta. Uma camada genérica que não corresponde às necessidades do projeto só acrescenta complexidade.
- Ignorar o custo de saída. O preço do hardware é apenas uma parte. Considere engenharia de migração, treinamento, observabilidade, suporte, consumo de energia e indisponibilidade durante a transição.
FAQ: Nvidia, Jensen Huang e dependência tecnológica
Jensen Huang pediu demissão da Nvidia?
O trecho fornecido afirma isso, mas não inclui link, data ou evidência que permita confirmar a informação. Eu não trataria a alegação como fato sem consultar a publicação original e fontes independentes.
Uma mudança de CEO faria CUDA deixar de funcionar?
Não automaticamente. CUDA é parte de um ecossistema técnico, não um recurso que depende apenas da presença de um executivo. Mudanças futuras de estratégia podem alterar prioridades e investimentos, mas isso precisa ser avaliado com anúncios e evidências concretas.
ROCm substitui CUDA em qualquer projeto?
Não. ROCm pode ser uma alternativa viável dependendo do hardware, das bibliotecas e do workload, mas a migração exige validação. Compare compatibilidade, desempenho, disponibilidade de suporte e custo operacional antes de decidir.
Como reduzir a dependência de um fornecedor de IA?
Defina interfaces pequenas para inferência, mantenha configurações fora do código de negócio e teste provedores alternativos regularmente. Não prometa portabilidade total: documente quais recursos continuam específicos de cada backend.
Minha recomendação é simples: não transforme uma alegação não verificada em premissa de arquitetura. Confirme a informação, monitore os sinais técnicos relevantes e prepare alternativas de forma proporcional ao risco real. Essa disciplina protege tanto a qualidade do debate quanto a estabilidade dos sistemas que construímos.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.