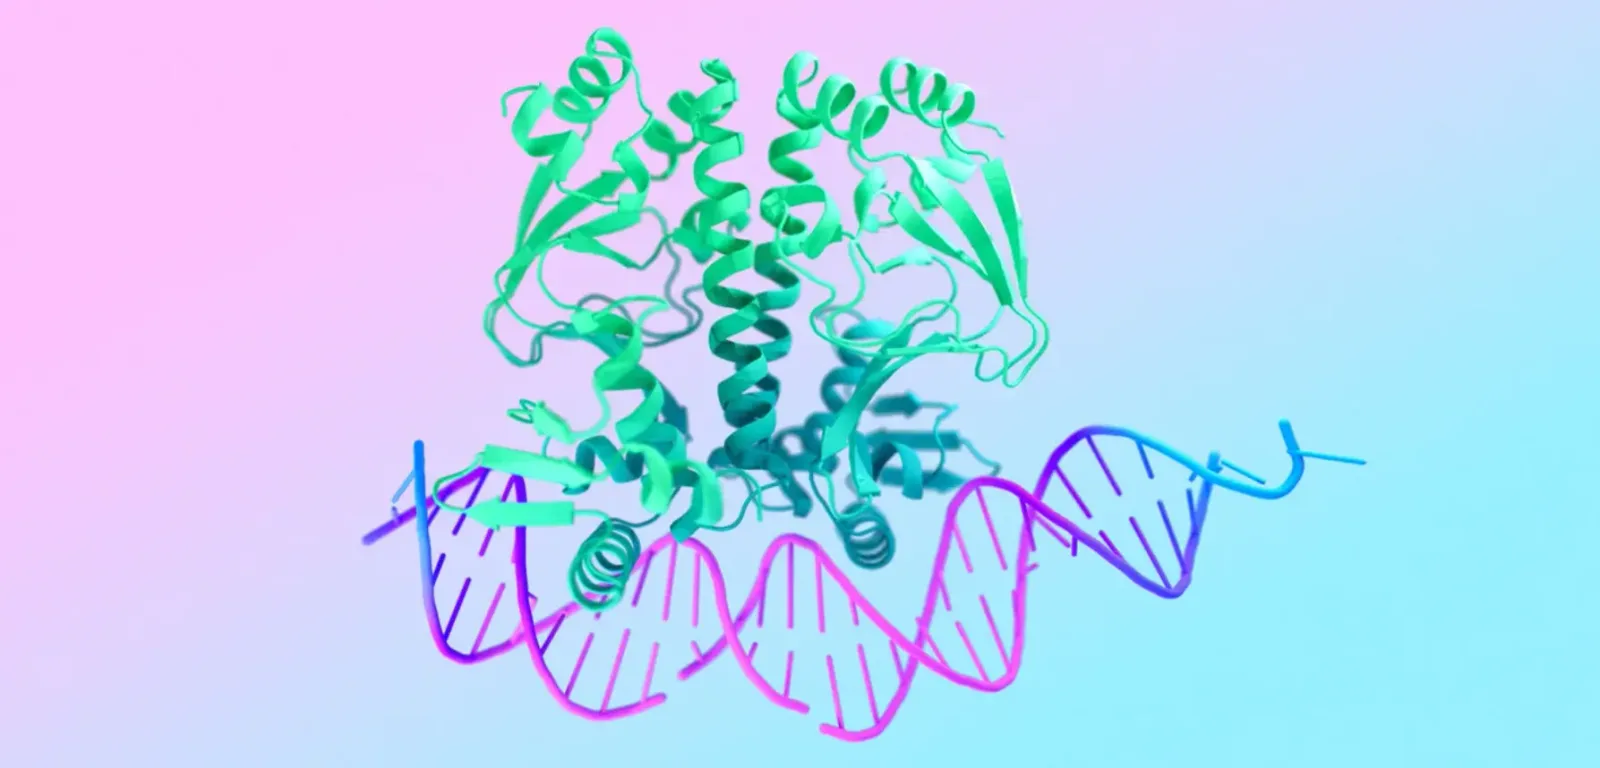
O AlphaFold não cura câncer nem transforma uma sequência genética em um tratamento pronto. O que ele faz é reduzir uma barreira importante: prever estruturas de proteínas para ajudar pesquisadores a formular hipóteses sobre mecanismos biológicos, mutações e possíveis alvos terapêuticos. Para quem trabalha com software, o ponto interessante é entender onde essa previsão entra no fluxo científico — e onde ela não pode substituir experimentos.
Segundo o Eurisko.com.br, o sistema do Google DeepMind já contribui para a investigação de mecanismos fundamentais da vida. Essa contribuição é concreta, mas precisa ser interpretada com precisão: uma estrutura prevista pode orientar uma pesquisa; não demonstra, sozinha, que uma mutação causa um tumor ou que uma molécula será um medicamento eficaz.
O que o AlphaFold prevê e por que isso importa para o câncer
Proteínas são moléculas que desempenham funções essenciais nas células. A sequência de aminoácidos de uma proteína influencia como ela se dobra no espaço e, com isso, como interage com outras moléculas. Uma alteração nessa sequência pode afetar estabilidade, atividade ou interação — processos que, em alguns contextos, estão ligados ao desenvolvimento de doenças.
O AlphaFold usa modelos de inteligência artificial para estimar a estrutura tridimensional de proteínas a partir de informações como a sequência de aminoácidos e relações evolutivas entre proteínas. O resultado ajuda pesquisadores a visualizar regiões da molécula e a investigar perguntas como: uma mutação pode alterar uma região funcional? Um sítio parece acessível? Duas proteínas podem interagir de uma forma plausível?
Essas respostas são pistas, não conclusões clínicas. No câncer, o comportamento de uma proteína depende também do tipo celular, da expressão do gene, de modificações químicas, de interações com outras moléculas e das condições do tumor. Uma estrutura isolada não representa toda essa complexidade.
Do modelo de proteína à investigação de um alvo terapêutico
Um fluxo de pesquisa pode começar com dados de sequenciamento tumoral. Pesquisadores identificam variantes genéticas, verificam se elas alteram a sequência de uma proteína e priorizam quais alterações merecem estudo. Uma estrutura prevista pode ajudar a interpretar a localização da variante, mas é apenas uma camada da análise.
Na prática, uma equipe pode combinar informações de expressão gênica, literatura científica, dados clínicos, ensaios celulares e estruturas experimentais. O modelo do AlphaFold ajuda a reduzir o espaço de hipóteses: em vez de testar possibilidades sem direção, os pesquisadores conseguem investigar regiões e interações com maior justificativa estrutural.
Isso pode acelerar etapas iniciais, como a seleção de alvos para estudos posteriores. Não significa que o sistema descubra automaticamente um medicamento. Identificar uma cavidade potencial na proteína, por exemplo, não comprova que uma molécula conseguirá se ligar a ela, chegar ao tecido certo, funcionar no organismo ou ser segura.
AlphaFold, cristalografia e outros modelos: qual ferramenta escolher?
O AlphaFold não elimina métodos experimentais como cristalografia de raios X, ressonância magnética nuclear ou microscopia crioeletrônica. Esses métodos podem fornecer evidência estrutural experimental, embora exijam amostras, instrumentação, tempo e conhecimento especializado. Uma previsão computacional é útil para orientar perguntas; uma medida experimental é necessária para confirmar aspectos da estrutura em condições específicas.
Também existem alternativas computacionais, como RoseTTAFold e ESMFold, com abordagens e capacidades diferentes. A escolha depende do problema, da disponibilidade dos dados e da validação necessária. Para muitos pesquisadores, consultar uma estrutura existente no AlphaFold Protein Structure Database é um primeiro passo mais simples do que executar um pipeline de predição do zero.
Outro cuidado é diferenciar a previsão de uma proteína isolada da previsão de um complexo molecular. O AlphaFold 3 foi desenvolvido para modelar interações entre diferentes tipos de moléculas, incluindo proteínas, DNA, RNA e ligantes. Isso amplia as perguntas que podem ser investigadas, mas não transforma uma pose computacional de interação em evidência experimental de ligação ou eficácia.
Como interpretar a confiança sem tirar conclusões exageradas
Os modelos podem fornecer medidas de confiança. No AlphaFold 2, o pLDDT indica a confiança estimada em regiões locais da estrutura. Em arquivos PDB do AlphaFold Database, esse valor costuma aparecer no campo B-factor. Já o PAE ajuda a avaliar a incerteza relativa entre partes da proteína, algo importante quando há domínios móveis ou regiões conectadas de forma flexível.
Um pLDDT alto não significa que a proteína esteja sempre naquela conformação dentro de uma célula. Também não prova que a proteína interage com outra molécula da maneira imaginada. Uma estrutura pode ter regiões bem previstas e, ainda assim, não representar mudanças provocadas por ligantes, modificações pós-traducionais ou condições específicas do ambiente celular.
Por isso, eu trataria os indicadores como metadados de incerteza, não como notas de qualidade universais. A pergunta certa não é apenas “qual é o pLDDT?”, mas “qual parte da estrutura é relevante para a hipótese e que evidência independente pode confirmá-la?”.
Na Prática: baixar e inspecionar uma estrutura do AlphaFold
Para um primeiro teste, podemos consultar a API do AlphaFold Protein Structure Database usando o identificador UniProt de uma proteína humana. O exemplo abaixo busca o modelo de TP53, baixa o arquivo PDB e calcula o pLDDT médio dos átomos de carbono alfa. Esse cálculo serve para exploração inicial; não valida uma hipótese sobre câncer.
Instale as dependências com pip install requests biopython. Depois, execute:
import requests
from io import StringIO
from Bio.PDB import PDBParser

uniprot_id = "P04637"  # TP53 humana
api_url = f"https://alphafold.ebi.ac.uk/api/prediction/{uniprot_id}"

response = requests.get(api_url, timeout=30)
response.raise_for_status()
records = response.json()

if not records:
    raise RuntimeError(f"Nenhum modelo encontrado para {uniprot_id}")

record = records[0]
pdb_url = record.get("pdbUrl")

if not pdb_url:
    raise RuntimeError("A resposta da API não contém uma URL PDB.")

pdb_response = requests.get(pdb_url, timeout=30)
pdb_response.raise_for_status()

structure = PDBParser(QUIET=True).get_structure(
    uniprot_id, StringIO(pdb_response.text)
)

plddt_values = [
    atom.get_bfactor()
    for atom in structure.get_atoms()
    if atom.get_name() == "CA"
]

if not plddt_values:
    raise RuntimeError("Não encontrei átomos CA para calcular o pLDDT.")

average_plddt = sum(plddt_values) / len(plddt_values)

print(f"Proteína: {record.get('uniprotId', uniprot_id)}")
print(f"Modelo: {record.get('entryId', 'não informado')}")
print(f"pLDDT médio dos átomos CA: {average_plddt:.1f}")
print(f"Arquivo PDB: {pdb_url}")
O valor médio é um resumo grosseiro. Ele pode esconder regiões flexíveis ou mal previstas, então, em uma análise real, eu examinaria a confiança por resíduo e visualizaria a estrutura em uma ferramenta molecular. Também verificaria a versão do modelo e confirmaria que o identificador UniProt corresponde à proteína e ao organismo desejados.
- Defina a pergunta biológica. Por exemplo, investigue se uma variante está próxima de uma região funcional conhecida.
- Confirme a identidade da sequência. Verifique organismo, isoforma e posição do resíduo; numeração divergente causa erros frequentes.
- Consulte a estrutura e os indicadores de confiança. Não interprete apenas uma imagem colorida ou um escore médio.
- Compare com evidências externas. Use literatura, dados genéticos e, quando disponível, estruturas experimentais.
- Trate a previsão como hipótese. Validação funcional e experimental continua necessária.
Erros comuns ao usar inteligência artificial estrutural em biologia
- Confundir previsão com prova. Um modelo plausível não confirma causalidade, ligação molecular ou eficácia de um tratamento.
- Ignorar isoformas e numeração. A posição de uma mutação pode mudar entre transcritos e versões de sequência. Antes de mapear variantes, confira a referência usada.
- Interpretar confiança local como certeza global. O pLDDT e o PAE respondem a aspectos diferentes; nenhum deles substitui validação experimental.
- Usar docking como confirmação. Uma molécula posicionada por software pode parecer adequada sem se ligar de verdade. Docking gera candidatos para investigar, não resultados clínicos.
- Esquecer contexto e limitações dos dados. Proteínas podem mudar de conformação, formar complexos e sofrer modificações que um modelo isolado não representa completamente.
- Automatizar sem rastreabilidade. Em pipelines científicos, registre identificadores, versões, parâmetros, arquivos de entrada e origem dos dados. Sem isso, fica difícil reproduzir ou auditar uma análise.
O que isso muda para quem desenvolve software?
O avanço mais relevante não é “a IA vai substituir a pesquisa”, mas a possibilidade de integrar modelos computacionais a fluxos de trabalho científicos mais rápidos. Isso exige boas práticas que desenvolvedores já conhecem: validação de entradas, tratamento de falhas de API, controle de versões, observabilidade e documentação dos resultados.
Também exige cuidado com a interface. Um painel que mostra uma estrutura em 3D pode transmitir uma falsa sensação de certeza se não apresentar a origem do modelo, a confiança por região e as limitações. Em aplicações científicas, explicar a incerteza faz parte do produto — não é um detalhe visual.
O AlphaFold ajuda a tornar perguntas estruturais mais acessíveis e pode orientar novas linhas de investigação do câncer. Mas a distância entre uma previsão computacional e um tratamento seguro continua passando por experimentos, validação clínica e avaliação de eficácia. É essa separação entre capacidade técnica e promessa exagerada que vale manter em qualquer projeto de IA aplicada à saúde.
Perguntas frequentes sobre AlphaFold e câncer
O AlphaFold consegue detectar câncer?
Não. Ele prevê estruturas de proteínas. A detecção de câncer depende de métodos diagnósticos e da avaliação clínica de dados como exames, biópsias e testes moleculares.
O AlphaFold cria medicamentos contra o câncer?
Não automaticamente. As previsões podem ajudar a estudar alvos e orientar etapas iniciais de descoberta de fármacos, mas candidatos precisam passar por validações experimentais e clínicas.
Uma estrutura com pLDDT alto está comprovada?
Não. O pLDDT estima confiança local do modelo. Ele não confirma a estrutura em todas as condições biológicas nem prova uma interação ou função específica.
Posso usar o AlphaFold para estudar uma mutação tumoral?
Sim, como parte de uma análise exploratória. Primeiro confirme a sequência, a isoforma e a posição da variante; depois interprete a estrutura junto com dados funcionais, genéticos e experimentais.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.