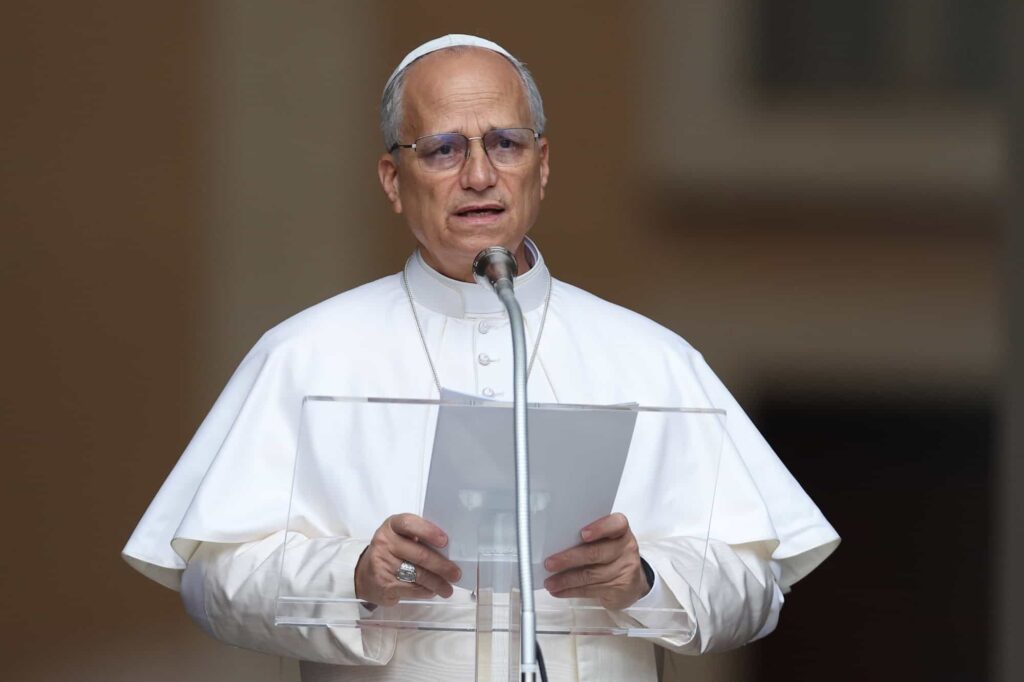
O Papa Leão XIV jogou luz em algo que a gente, como devs, precisa parar de fingir que não vê: estamos construindo sistemas que tomam decisões que mudam a vida das pessoas — e, na maioria das vezes, ninguém para pra perguntar se aquilo deveria mesmo estar nas mãos de um modelo. Segundo o Olhardigital.com.br, o pontífice alertou, nesta quarta (16), contra o risco de deixar que algoritmos assumam decisões que pertencem exclusivamente à consciência humana. Vou puxar esse fio do ponto de vista de quem escreve código, não de quem filosofa em abstrato.
O problema real não é a IA decidir — é decidir sem rasto humano
Na minha experiência, a falácia que mais aparece em reuniões de produto é a seguinte: “o modelo decide, e a gente só revisa se der problema”. Esse é o caminho mais rápido para um desastre ético, técnico e jurídico. Quando o algoritmo erra, o erro é silencioso — não tem alarme, não tem log emocional, não tem chefe perguntando “por que você fez isso?”. O sistema simplesmente cospe um resultado e segue.
Leão XIV acertou no alvo quando disse que “as relações tendem a tornar-se cada vez menos pessoais, mais virtuais”. Em software, isso se traduz em automação sem ponto de fricção humana. Onde o ser humano deveria hesitar, o pipeline continua rodando. Onde deveria haver dúvida, há confiança cega no output.
Onde isso já acontece no código que você escreve (ou consome)
- Seleção de candidatos: ferramentas de ATS que ranqueiam currículos com base em padrões históricos — e perpetuam viés. A Amazon já desligou um sistema desses em 2018 porque penalizava mulheres sistematicamente.
- Análise de crédito: modelos que decidem se alguém recebe empréstimo em milissegundos. O cliente nem sabe que foi rejeitado por um modelo, não por uma pessoa.
- Moderação de conteúdo: plataformas que suspendem contas antes de qualquer revisão humana. A pessoa perde renda enquanto um humano “confirma” depois.
- TRIAGEM médica: algoritmos que priorizam pacientes em hospitais. Decisão literalmente sobre vida ou morte.
- Justiça criminal: sistemas como o COMPAS nos EUA, que já foram auditados mostrando viés racial significativo em sentenças.
Repara: nenhum desses casos é ficção científica. São APIs rodando em produção hoje.
Por que devs seniores precisam levar isso a sério
Quando comecei a trabalhar com ML em produção, achava que o trabalho terminava quando o modelo passava nos testes. Erro de junior. O trabalho real começa quando você decide o que o modelo pode ou não decidir sozinho. Isso é arquitetura, não filosofia.
Existe um conceito que pouca gente aplica direito: human-in-the-loop (HITL). Não é colocar um humano “assistindo” no dashboard. É projetar o sistema de forma que a decisão sensível não aconteça sem validação explícita. Isso muda o design inteiro — da latência aceitável ao fluxo de UI.
O custo real de não ter HITL
Não é só ético. É financeiro. Multas do GDPR chegam a 4% do faturamento global. A ANPD brasileira tem autuado empresas por decisões automatizadas sem possibilidade de revisão. Um sistema mal desenhado não é só um risco moral — é um passivo contábil esperando para explodir.
Na Prática: implementando Human-in-the-Loop em um sistema de aprovação
Vou mostrar um padrão que uso em produção quando preciso garantir que decisões críticas não saiam sem revisão. É um middleware simples, mas que força a arquitetura a respeitar a fronteira humana.
from enum import Enum
from dataclasses import dataclass
from typing import Callable, Optional
import logging

logger = logging.getLogger(__name__)

class DecisionType(Enum):
    AUTO = "auto"           # baixo risco, pode seguir
    REVIEW = "review"       # precisa de humano antes de aplicar
    BLOCK = "block"         # nunca delegar ao modelo

@dataclass
class DecisionContext:
    user_id: str
    action: str
    risk_score: float       # 0.0 a 1.0
    affected_party: str     # quem sofre com a decisão

class HumanInTheLoopGateway:
    """
    Wrapper que NUNCA executa uma decisão sensível sem aprovação humana.
    A função 'model_predict' pode sugerir. O 'human_approve' decide.
    """

    BLOCKED_ACTIONS = {
        "terminate_employment",
        "deny_medical_treatment",
        "reject_credit_high_value",
    }

    HIGH_RISK_THRESHOLD = 0.7

    def __init__(
        self,
        model_predict: Callable[[DecisionContext], float],
        human_approve: Callable[[DecisionContext], bool],
        auto_threshold: float = 0.3,
    ):
        self.model_predict = model_predict
        self.human_approve = human_approve
        self.auto_threshold = auto_threshold

    def decide(self, ctx: DecisionContext) -> DecisionType:
        # 1. Ações críticas NUNCA saem sem humano
        if ctx.action in self.BLOCKED_ACTIONS:
            logger.warning(
                "action_blocked_from_automation",
                extra={"action": ctx.action, "user_id": ctx.user_id},
            )
            return DecisionType.BLOCK

        # 2. Score de risco alto? Humano decide.
        if ctx.risk_score >= self.HIGH_RISK_THRESHOLD:
            approved = self.human_approve(ctx)
            return DecisionType.AUTO if approved else DecisionType.BLOCK

        # 3. Modelo confiante e baixo risco? Auto, MAS com log auditável.
        score = self.model_predict(ctx)
        if score >= self.auto_threshold:
            logger.info(
                "auto_approved",
                extra={
                    "user_id": ctx.user_id,
                    "action": ctx.action,
                    "model_score": score,
                    "affected_party": ctx.affected_party,
                },
            )
            return DecisionType.AUTO

        # 4. Caso duvidoso: revisão humana.
        approved = self.human_approve(ctx)
        return DecisionType.AUTO if approved else DecisionType.BLOCK
O ponto-chave está nos BLOCKED_ACTIONS. Essa lista é uma decisão arquitetural consciente: eu, como dev, declarei que certos tipos de ação nunca saem do controle humano, não importa o que o modelo sugira. Não é configurável pelo time de produto sem revisão de engenharia e compliance.
Como usar isso num sistema real
- Mapeie todas as ações sensíveis que seu sistema executa. Faça uma lista explícita, não implícita.
- Classifique cada uma por risco: baixo (recomendação), médio (sugestão), alto (decisão), crítico (irreversível).
- Bloqueie a automação no nível do código, não em política escrita. Política escrita ninguém lê em incidente.
- Logue tudo com contexto: quem foi afetado, qual o score do modelo, quem aprovou. Logs viram evidência em auditoria.
- Defina SLA humano explícito: “revisão em até 4h”. Sem isso, o humano vira gargalo e o negócio pressiona para remover a trava.
- Audite mensalmente: pegue 10 decisões automáticas e pergunte “um humano teria decidido diferente?”. Calibrar é contínuo.
Erros comuns que vejo em time entregando feature de IA
1. Confiar no output do LLM como se fosse verdade factual
Esse é o erro de junior mais caro. O modelo gera um JSON bonito, com campos preenchidos, e o dev joga direto no banco. Cuidado: LLMs não sabem a diferença entre verdade e fluência. Em produção, isso vira dado errado em massa, cliente processado por cobrança indevida, e compliance batendo na porta.
2. Automatizar para “escalar” sem medir erro
“Aumentamos 10x o throughput.” Legal. E o erro também? Se o erro cresce junto, você só está acelerando o prejuízo. Toda automação precisa de métrica de qualidade, não só de velocidade.
3. Esconder o humano no dashboard
O pior padrão de HITL que existe: “tem humano revisando, sim, lá no painel”. Ninguém olha o painel. O humano tem que estar no fluxo, bloqueando a próxima etapa até clicar em “aprovar”. Caso contrário, é teatro de governança.
4. Tratar viés como problema de dados, não de produto
“O dataset está enviesado, então não é culpa do modelo.” Não. É culpa sua, que colocou o modelo em produção sabendo do viés. Dados são insumo; o produto é responsabilidade de quem shippa.
5. Achar que explicar o modelo resolve o problema ético
Explainable AI ajuda, mas não substitui accountability. Se um médico não consegue explicar por que receitou um remédio, você troca o médico. Se um modelo não consegue, você não coloca em produção — ou coloca com humano obrigatório.
Implicações práticas para o dev que programa amanhã
Quando você for desenhar uma feature nova com IA, faça essas três perguntas antes de abrir o editor:
- Quem é o afetado pelo output? Se for um ser humano real, com vida real, você precisa de HITL ou, no mínimo, de canal de contestação fácil.
- O erro é reversível? Cancelar uma compra errada é fácil. Cancelar uma aprovação de crédito errada é processo judicial.
- Tem log auditável? Se daqui a 6 meses aparecer um caso problemático, você consegue reconstruir a decisão? Se não, refaça antes de subir.
Isso não é burocracia. É o que separa um sistema que sobrevive a uma crise de um que vira caso de jornal.
FAQ — Perguntas que devs realmente fazem sobre IA e decisões humanas
Human-in-the-loop não mata a escalabilidade da IA?
Não necessariamente. Você escala nas decisões de baixo risco e mantém trava nas de alto risco. A maioria dos sistemas reais tem 80% de tráfego automatizado e 20% revisado — o ganho de escala é real, só não é 100%.
Como sei se meu modelo tem viés sem ser especialista em ML?
Comece pelos dados: qual a distribuição demográfica do seu dataset? Se 95% são homens brancos, o modelo não vai performar igual em outros grupos. Use ferramentas como aif360 (IBM) ou fairlearn (Microsoft) — ambas open source.
Vale a pena usar LLM para decisões de negócio críticas?
Não direto. Use para gerar contexto que alimenta uma decisão humana, ou para triagem inicial que vai para revisão. Nunca como decisor final em algo que afeta pessoa.
Qual regulação brasileira me obriga a ter revisão humana?
A LGPD (Art. 20) garante ao titular o direito de revisão de decisões automatizadas. Na prática, se seu sistema toma decisão que afeta alguém, você precisa oferecer canal de contestação com análise humana. Multa pode chegar a 2% do faturamento (limitada a R$ 50 milhões por infração).
Pope Leo XIV falou em IA, mas isso vale para qualquer algoritmo?
Sim. O alerta dele é sobre delegar consciência humana para qualquer sistema automatizado, seja um modelo de deep learning, um filtro de regras ou um if-else gigante. O princípio é o mesmo: decisões com peso moral exigem humanidade no loop.
O que eu levo disso para o próximo deploy
Quando o Papa fala em “consciência humana”, eu traduzo para o meu dia a dia assim: cada linha de código que automatiza uma decisão é uma promessa de que um humano ainda vai revisar o que importa. Quebrar essa promessa é fácil. Cumprir exige arquitetura, processo e, sim, humildade de reconhecer que o modelo não substitui ninguém.
O Papa Leão XIV não é dev. Mas ele identificou, em linguagem pastoral, exatamente o problema técnico que a gente finge não ver: estamos empurrando responsabilidade moral para código que, no fundo, não tem responsabilidade nenhuma. Quem programa isso somos nós. Assumir isso é o mínimo.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.