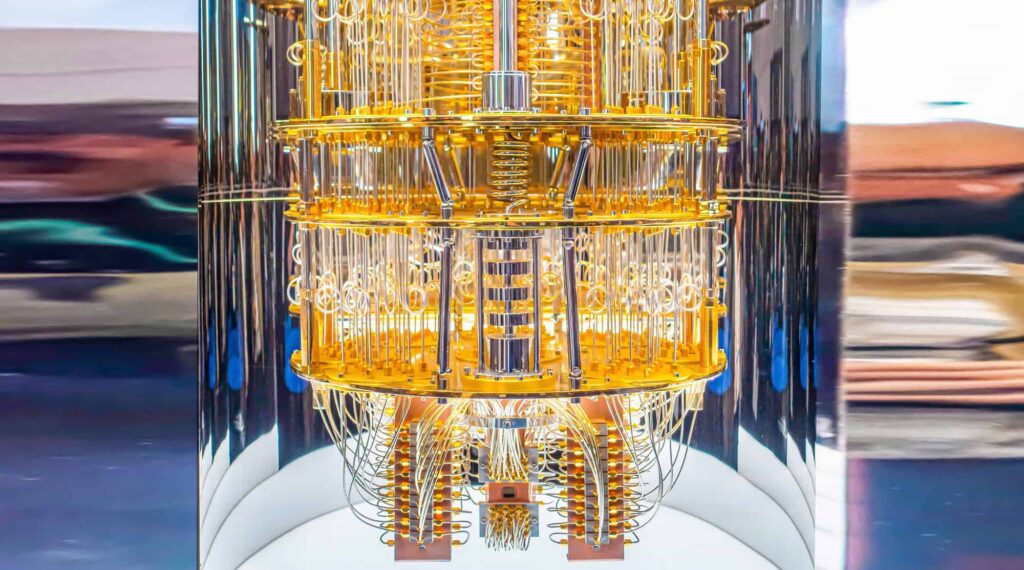
O que o benchmark QUOPS realmente diz sobre o futuro da computação quântica
Quando vi a notícia do Olhar Digital sobre o novo teste QUOPS (Quantum Universal Operation Performance System), minha primeira reação foi: finalmente alguém criou uma métrica que não é só marketing. Segundo o portal, o Sandia National Laboratories colocou lado a lado máquinas da Google, IBM e Quantinuum e descobriu que estamos a cerca de 100 mil vezes de distância de rodar aplicações quânticas úteis no mundo real. Isso muda completamente a narrativa vendida pelas big techs.
Na minha experiência acompanhando o ecossistema, vejo muita hype e pouca métrica comparável. O benchmark QUOPS me interessou justamente por isso: ele mede duas coisas simultaneamente — velocidade de operação e tamanho do circuito executado com fidelidade aceitável. Vamos dissecar isso tecnicamente, entender o que significa na prática para quem programa, e o que isso implica no roadmap dos próximos anos.
Entendendo o QUOPS: a métrica que faltava
O QUOPS não é só mais um “Qubits count” inflado. Ele pondera operações pelo porte do circuito quântico que o hardware consegue rodar de forma confiável. Em outras palavras: de nada adianta ter 1.000 qubits se você só consegue encadear 10 portas lógicas antes do decoerência destruir o resultado.
A fórmula conceitual é simples: QUOPS = número de operações quânticas bem-sucedidas × profundidade útil do circuito. Isso dá uma visão muito mais honesta do que os tradicionais “quantum volume” da IBM ou os benchmarks da Google.
O resultado mais impressionante do teste foi o processador Helios-1 da Quantinuum, baseado em íons aprisionados, que ultrapassou os 1.500 QUOPS. Para efeito de comparação, problemas reais — como simular moléculas complexas para descoberta de fármacos ou quebrar criptografia RSA-2048 — exigiriam entre 250 milhões e 340 milhões de QUOPS.
Por que arquiteturas diferentes importam (e por que isso afeta você)
Um ponto que a maioria dos devs ignora: não existe “computador quântico” genérico. Existem arquiteturas radicalmente diferentes, e cada uma tem trade-offs que impactam diretamente em qual tipo de problema ela resolve melhor.
Supercondutores (Google, IBM)
- Velocidade de operação altíssima (gigahertz)
- Escalabilidade mais fácil de fabricar em wafer
- Problema: decoerência em milissegundos, exigindo correção de erros pesada
- Conexões limitadas entre qubits vizinhos (topologia restrita)
Íons aprisionados (Quantinuum, IonQ)
- Qubits com fidelidade altíssima (99,9%+ em operações de 1 qubit)
- Conectividade total — qualquer qubit conversa com qualquer outro
- Velocidade menor (kHz a MHz), mas operações mais “limpas”
- Escalar é mais difícil, pois cada íon é um átomo individual
Quando programo circuitos em Qiskit ou Cirq, percebo que essas diferenças arquiteturais obrigam adaptações no código. Um mesmo algoritmo rodando em supercondutor vs íons aprisionados pode exigir re-roteamento completo das portas lógicas. Isso é o oposto do que acontece com CPUs clássicas — onde o assembly é praticamente portável entre fabricantes.
Na Prática: simulando o problema com Qiskit
Para vocês entenderem o que significa “circuito grande”, vou mostrar um exemplo real que esbarra no gargalo que o QUOPS expôs. O código abaixo simula um pequeno algoritmo de Bernstein-Vazirani — clássico em qualquer curso de computação quântica:
from qiskit import QuantumCircuit, transpile
from qiskit_aer import AerSimulator
from qiskit.visualization import circuit_drawer

def bernstein_vazirani_oracle(secret_string):
    """Cria um oráculo que codifica uma string secreta em um circuito quântico."""
    n = len(secret_string)
    qc = QuantumCircuit(n + 1)

    for i, bit in enumerate(secret_string):
        if bit == '1':
            qc.cx(i, n)

    return qc

# String secreta de 8 bits — problema pequeno, mas já ilustrativo
secret = '10110011'
n = len(secret)

# Monta o circuito completo
bv_circuit = QuantumCircuit(n + 1, n)
bv_circuit.x(n)  # estado |1⟩ no qubit auxiliar
bv_circuit.h(range(n + 1))  # superposição
bv_circuit.compose(bernstein_vazirani_oracle(secret), inplace=True)
bv_circuit.h(range(n))
bv_circuit.measure(range(n), range(n))

# Simula no backend clássico
simulator = AerSimulator()
transpiled = transpile(bv_circuit, simulator)
result = simulator.run(transpiled, shots=1024).result()
counts = result.get_counts()

print(f"Resultado mais frequente: {max(counts, key=counts.get)}")
print(f"String secreta real:     {secret}")
Esse circuito com 8 qubits + 1 auxiliar roda em qualquer laptop. Mas experimente escalar para 128 qubits lógicos com profundidade de circuito útil acima de 100 — aí você já precisa de hardware quântico real. E quando falamos de simulação molecular ou criptografia pós-quântica, estamos falando de milhares de qubits lógicos com correção de erros ativa. É nesse ponto que o abismo dos 100 mil vezes aparece.
O que isso significa para devs na prática
Antes que alguém pergunte “preciso aprender computação quântica agora?”, vou direto ao ponto: não, ainda não. Mas algumas coisas já valem o investimento de tempo:
- Entender os algoritmos: Shor, Grover, VQE, QAOA. Saber o que eles resolvem te dá visão estratégica para escolher problemas clássicos adequados.
- Brincar com frameworks: Qiskit (IBM), Cirq (Google), PennyLane (Xanadu) e Braket (AWS). Todos têm simuladores locais gratuitos.
- Criptografia pós-quântica: NIST já padronizou CRYSTALS-Kyber e CRYSTALS-Dilithium. Se você trabalha com TLS, JWT ou qualquer sistema de autenticação, migração vem aí.
- Modelos híbridos quântico-clássicos: o futuro próximo é variational quantum eigensolvers rodando parte em CPU e parte em QPU. Saber orquestrar isso com orquestradores como Kubernetes já é diferencial.
Particularmente, acho que o maior erro que devs cometem é tratar computação quântica como “ciência de ficção” e ignorar completamente. Quando o “quantum advantage” chegar de verdade — e o QUOPS sugere que estamos a talvez 10–15 anos disso — quem estiver preparado vai capturar valor absurdo.
Erros comuns que devs cometem ao falar de quantum
Lista honesta do que eu já vi errado em incontáveis fóruns e threads:
- Achar que qubits = bits clássicos multiplicados: 10 qubits não são “1024 vezes mais poderosos” que 10 bits. Eles representam 2¹⁰ estados em superposição, mas medir destrói a superposição e você só obtém 10 bits de informação.
- Ignorar decoerência e correção de erros: qubit físico não é qubit lógico. Para 1 qubit lógico útil, você precisa de centenas a milhares de qubits físicos hoje.
- Confundir quantum annealing com computação quântica universal: D-Wave faz annealing, bom para otimização combinatória. Não roda Shor nem Grover.
- Achar que toda aceleração quântica é relevante: muitos algoritmos quânticos só batem clássicos em casos muito específicos. Ordenar uma lista? Ainda é quicksort clássico.
- Subestimar overhead de orquestração: rodar em hardware quântico real hoje envolve filas, calibração diária, custo por shot. Não é “deploy e esquece”.
Comparativo rápido: quem está na frente hoje
| Empresa | Arquitetura | Pontuação QUOPS | Diferencial |
|---|---|---|---|
| Quantinuum | Íons aprisionados | ~1.824 (melhor) | Fidelidade altíssima, conectividade total |
| Supercondutor | Abaixo do líder | Velocidade de clock superior | |
| IBM | Supercondutor | Abaixo do líder | Ecossistema maduro e Qiskit |
Perceba: a Quantinuum lidera em fidelidade mesmo tendo clock mais lento. Isso reforça que qualidade de operação bate quantidade de qubits — e é exatamente isso que o QUOPS mede melhor que métricas anteriores.
FAQ — Perguntas reais que devs fazem
1. Computação quântica vai substituir CPUs clássicas?
Não. Computadores quânticos são aceleradores especializados, não substitutos. Assim como GPUs não mataram CPUs, QPUs vão coexistir em arquiteturas híbridas. CPU faz o trabalho sequencial, QPU acelera partes específicas do pipeline.
2. Quando o “quantum advantage” real vai chegar?
Estimativas conservadoras colocam entre 2030 e 2035 para vantagem quântica em problemas comerciais (simulação de materiais, otimização de portfólio, criptoanálise). O benchmark QUOPS sugere que ainda faltam ~5 ordens de grandeza de evolução no hardware.
3. Preciso de matemática avançada para programar em Qiskit?
Para usar de forma básica, basta álgebra linear introdutória. Para criar algoritmos novos ou entender proof-of-quantum-advantage, aí sim precisa de mecânica quântica, teoria de informação quântica e complexidade computacional.
4. Empresas brasileiras já usam computação quântica?
Algumas universidades (USP, UFMG, UnB) e o SENAI já têm acesso a hardware via IBM Quantum Network. Petrobras tem projetos exploratórios de VQE para simulação de catalisadores. Está nascendo, mas existe.
5. Vale a pena investir em certificados de quantum computing hoje?
Como diferencial estratégico, sim. Cursos da IBM Quantum, Xanadu PennyLane e MIT OpenCourseWare já cobrem o essencial. Como especialização única, ainda cedo — melhor tratar como skill adjacente à sua stack principal.
Considerações finais: o “100 mil vezes” como norte
O número mais importante dessa pesquisa não é o 1.824 QUOPS do Helios-1. É o fator de 100 mil vezes. Esse é o gap que separa o hype das big techs da realidade computacional. Sabendo disso, fica mais fácil filtrar bullshit corporativo e focar no que de fato importa: entender onde quantum vai agregar, preparar pipelines que aceitem QPUs no futuro e manter os olhos nas métricas reais — não em contagem de qubits de marketing.
Vou continuar testando circuitos no Qiskit e acompanhando o roadmap da Quantinuum. Se o gap dos 100 mil vezes cair para 10 mil vezes em dois anos, a conversa muda completamente. Até lá, computação quântica segue sendo investimento de longo prazo — mas ignorar é erro de principiante.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.