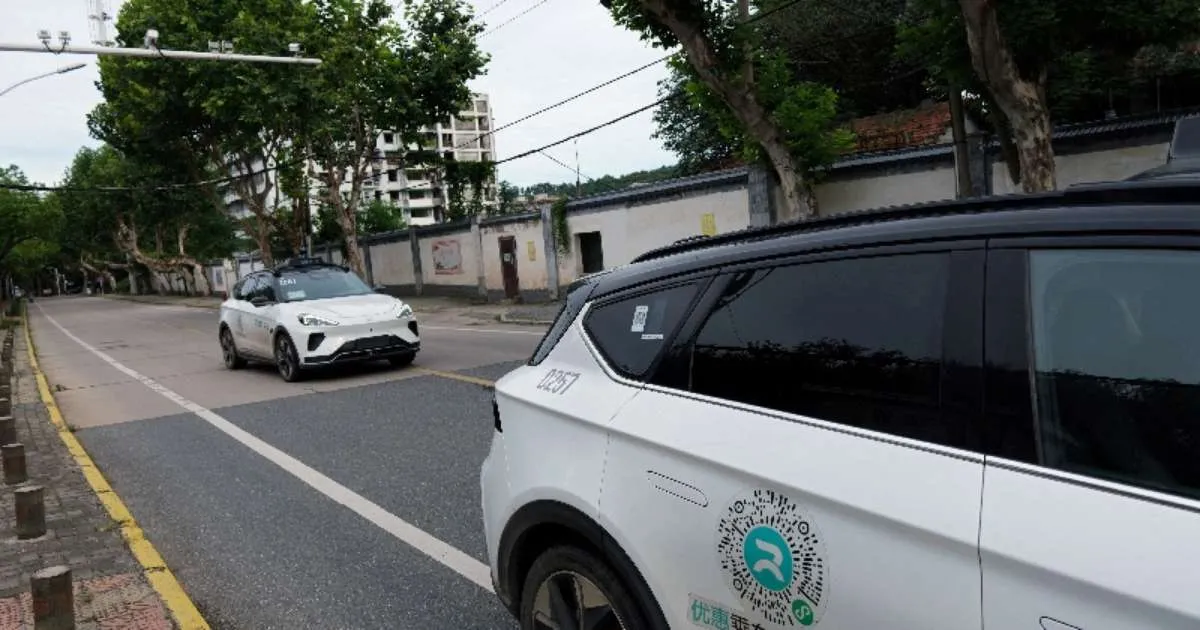
O plano da China para veículos autônomos em 2030: o que isso significa para quem programa
Segundo o Terra.com.br, o Ministério da Indústria da China divulgou um plano de ação agressivo para escalar veículos com direção autônoma até 2030. Não é só geopolítica industrial — é um movimento que vai redefinir o mercado de software embarcado, simulações, visão computacional e integração cloud-edge que a gente, como devs, já trabalha (ou vai trabalhar).
Na minha experiência acompanhando projetos de IoT e edge AI, sempre que um governo centraliza uma diretriz como essa, três coisas acontecem em sequência: surgem novos padrões técnicos, abrem-se oportunidades em SDKs e frameworks abertos, e quem está preparado captura os melhores contratos. Vou destrinchar isso com olhar técnico.
Por que 2030 importa mais do que parece
O prazo de 2030 não é arbitrário. Alinhado com metas anteriores de eletrificação e conectividade 5G/6G, ele pressupõe que toda a stack esteja madura: redes de baixa latência, regulamentação para direção autônoma L3/L4, homologação de componentes críticos e consolidação do setor automotivo chinês entre as top 10 globais.
Para nós, devs, isso significa que daqui pra frente veremos:
- Mais vagas em C++/Rust embarcado — porque o carro autônomo roda em RTOS com latência sub-10ms.
- Demanda por MLOps pesado — pipelines de dados, simulação, validação contínua e retraining de modelos.
- Aumento de APIs V2X (Vehicle-to-Everything) abertas para cidades inteligentes.
- Novos frameworks de simulação (CARLA, SUMO, LGSVL) com integrações nativas em clouds chinesas.
O stack técnico por trás de um veículo autônomo
Quando comecei a estudar isso a fundo para projetos de computer vision, percebi que um carro autônomo não é "um modelo de IA dirigindo". É uma arquitetura distribuída com camadas bem definidas. Olha a visão geral:
| Camada | Tecnologia | Linguagem/Stack comum |
|---|---|---|
| Percepção | Câmeras, LiDAR, Radar, Sensor Fusion | C++ + CUDA, ROS2, PyTorch/TensorRT |
| Localização | SLAM, GNSS, HD Maps | C++, RTK GPS, OpenCV |
| Planejamento | Path Planning, Behavior Trees | Python, C++, Julia (otimização) |
| Controle | PID, MPC, Controle de atuadores | C/C++ em RTOS (QNX, AUTOSAR) |
| Telemetria | V2X, 5G/6G, OTA updates | Go, Rust, gRPC, MQTT |
| Validação | Simulação, regression tests | Python, CARLA, Unity, Gazebo |
O que a China está dizendo com o plano é: queremos dominar todas essas camadas internamente. Isso inclui os compiladores, os frameworks de simulação e os padrões de comunicação.
Comparação com abordagens concorrentes
A estratégia chinesa difere da americana em pontos cruciais. A Tesla, por exemplo, aposta em visão pura (câmeras + redes neurais end-to-end). A Waymo usa LiDAR caro e HD Maps hiperdetalhados. O plano chinês, segundo o texto, menciona "rodovias, vias expressas urbanas e vias municipais" — isso implica dependência de infraestrutura conectada, não só de percepção local.
Na prática, isso é similar ao que a Europa já estuda com o C-ITS (Cooperative Intelligent Transport Systems). Mas com uma diferença importante: escala. Quando você implanta em uma única cidade, é piloto. Quando implanta em 50 cidades coordenadas, é plataforma.
Para devs, o impacto é que os sistemas chineses provavelmente serão mais abertos em protocolos V2X (algo como um "MQTT automotivo" em escala urbana), o que pode acelerar a chegada de padrões abertos que o resto do mundo vai adotar por conveniência.
Na Prática: simulando um sensor fusion básico
Quer entender como a camada de percepção funciona sem precisar de um carro real? Dá pra simular a fusão de sensores (câmera + LiDAR) com Python e NumPy. Esse trecho de código mostra o conceito de "fusion by weighted confidence":
import numpy as np

class SensorFusion:
 """
 Fusão simples: combina detecção de câmera e LiDAR
 com pesos baseados na confiança de cada sensor.
 """
 def __init__(self, w_camera=0.6, w_lidar=0.4):
 self.w_camera = w_camera
 self.w_lidar = w_lidar

 def detect_objects(self, camera_boxes, lidar_points):
 # camera_boxes: lista de [x, y, w, h, confianca]
 # lidar_points: lista de [x, y, z, distancia, confianca]
 fused = []

 for cb in camera_boxes:
 cx, cy, _, _, conf_c = cb

 # Procura ponto LiDAR próximo (distância euclidiana)
 nearest_lidar = None
 min_dist = float('inf')
 for lp in lidar_points:
 lx, ly, _, _, _ = lp
 d = np.hypot(cx - lx, cy - ly)
 if d < min_dist:
 min_dist = d
 nearest_lidar = lp

 if nearest_lidar and min_dist < 2.0:
 _, _, _, _, conf_l = nearest_lidar
 combined_conf = (
 self.w_camera * conf_c +
 self.w_lidar * conf_l
 )
 fused.append({
 "position": (cx, cy),
 "confidence": round(combined_conf, 3)
 })
 else:
 # Só câmera confiou
 fused.append({
 "position": (cx, cy),
 "confidence": round(conf_c * 0.7, 3) # penaliza
 })

 return fused


# Exemplo de uso
camera_detections = [
 [10.0, 5.0, 2.0, 2.0, 0.92],
 [25.0, 8.0, 1.5, 1.5, 0.85],
]

lidar_detections = [
 [10.1, 5.2, 0.0, 8.5, 0.98],
 [40.0, 12.0, 0.0, 15.0, 0.95],
]

fusion = SensorFusion()
result = fusion.detect_objects(camera_detections, lidar_detections)

for obj in result:
 print(obj)
Esse é um exemplo didático, claro. Em produção, o pipeline real usa ROS2, mensagens tipadas, FPGAs para pré-processamento e modelos YOLO/EfficientDet para detecção visual. Mas o princípio — pontuar detecções com base em concordância entre sensores — é o mesmo.
O que isso muda para o desenvolvedor brasileiro
Mesmo que a China esteja acelerando esse mercado, três ondas chegam até a gente:
- Ferramentas open source chinesas ganhando tração global: Baidu já abriu o Apollo, e a expectativa é que outros stacks surjam. Fica de olho no GitHub de empresas como Pony.ai, WeRide e Horizon Robotics.
- Demanda interna por simulações e testes: empresas brasileiras de agritech, mineração e logística autônoma (que já operam em ambiente controlado) vão absorver parte dessa expertise.
- Regulação como diferencial técnico: entender normas como ISO 21448 (SOTIF) e UN-R157 vai virar requisito em vagas sêniores.
Erros Comuns que devs cometem quando entram nessa área
Quando migrei parte do meu foco para projetos de IA aplicada, cometi (e vi muita gente cometer) estes deslizes:
- Treinar modelo sem pensar em edge deployment: um YOLOv8 gigante rodando em cloud é bonito, mas o carro precisa de latência baixa. TensorRT, ONNX Runtime e quantização INT8 são obrigatórios, não opcionais.
- Ignorar simulação por achar que "dados reais bastam": rodar 1 milhão de km em simulação vale mais que 100 km reais. Cenários perigosos (criança atravessando, neblina, chuva forte) são raros no mundo real e baratinhos na simulação.
- Subestimar a complexidade de fusão de sensores: sincronização temporal (timestamp drift entre LiDAR e câmera) é onde a maioria dos projetos trava.
- Não versionar dados e modelos como código: DVC, MLflow e Weights & Biases não são "nice to have" — são a única forma de auditar decisões de um veículo autônomo depois de um incidente.
- Esquecer do safety case: o código precisa provar matematicamente por que é seguro. Não basta "funcionar nos testes".
O lado regulatório que devs ignoram (e não deveriam)
O plano chinês menciona endurecimento das regras de produção, segurança viária, direção autônoma e atualizações OTA. Isso importa diretamente para nós porque:
- OTA updates viraram o novo "deployment de software crítico". Se um bug vai pra 50 mil carros, o recall é inevitável. Pipelines de CI/CD com canary release e rollback rápido são mandatórios.
- Aprovações especiais para componentes significam que vamos ver mais certificações tipo ISO 26262 e IEC 61508 aparecendo em descrições de vaga.
- Coibição de excesso de investimentos pode parecer estranho, mas evita o oposto do que aconteceu com cripto no Brasil: bolha, frustração e talentos dispersos.
FAQ — Perguntas que devs realmente fazem
1. Preciso saber dirigir pra trabalhar com veículos autônomos?
Não. A maioria das vagas é em software, simulação, ML ou backend. Direção serve só pra entender UX e o problema do usuário final.
2. Qual linguagem de programação é a mais usada?
C++ domina a parte embarcada (por performance e determinismo). Python é rei em ML, simulação e prototipagem. Rust está ganhando espaço em módulos novos por memory safety. Go aparece em serviços cloud/telemetria.
3. Quanto tempo leva pra entrar na área vinda de web/dev backend?
Na minha vivência, um dev backend sólido aprende o stack de perception/planning em 6–12 meses se já domina Python e tem base em Linux embarcado. O pulo do gato é entender ROS2 e pelo menos um framework de simulação.
4. A China vai mesmo dominar o mercado até 2030?
"Dominar" é forte. Mas escalar primeiro significa ditar padrões técnicos e capturar early adopters globais. A Europa já mostrou com GDPR que (primeiro) importa. Padrões técnicos funcionam igual.
5. Vale a pena estudar Apollo (Baidu) ou investir em CARLA?
Vale. Apollo é o "Linux do carro autônomo" chinês — completo, mas pesado. CARLA é mais leve, ideal pra aprender e fazer POCs. Combine os dois: CARLA pra prototipar, Apollo pra entender arquitetura de produção.
Considerações finais
Esse plano da China não é só sobre carros. É sobre controle da próxima camada de infraestrutura urbana inteligente. Para nós, devs, a leitura prática é direta: quem dominar o stack de simulação + edge AI + protocolos V2X nos próximos 3 anos vai estar na frente quando a demanda explodir.
Comece pequeno: instale o CARLA, rode o exemplo do meu código acima, leia a documentação do Apollo. Em 30 dias você já vai ter uma visão muito mais clara do que está vindo — e pode se posicionar antes da maioria.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.