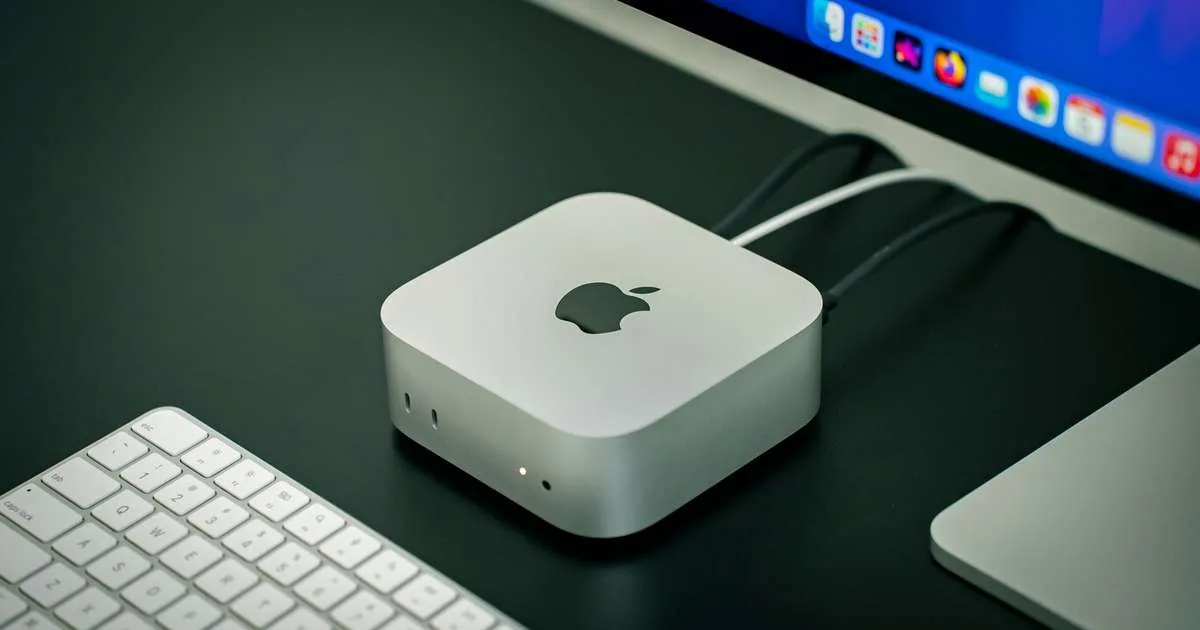
O Mac pode se beneficiar da corrida da IA antes mesmo de a Siri entregar a experiência que a Apple prometeu. O motivo não é misterioso: desenvolvedores e usuários avançados estão comprando computadores para executar modelos e agentes localmente, e o hardware da Apple tem uma combinação útil para isso — memória unificada, consumo relativamente baixo e formatos compactos como o Mac mini. Mas “momento IA” não significa que qualquer Mac virou uma estação de trabalho de inteligência artificial.
Segundo o Xataka.com.br, o Mac faturou US$ 10,792 bilhões entre julho e setembro, alta de 23,7% na comparação anual. O crescimento chama atenção, embora o computador ainda represente 9,4% da receita da Apple e esteja se recuperando de uma queda importante em 2023. Para quem programa, a pergunta mais interessante não é se a linha Mac está vendendo mais: é que tipo de carga de trabalho está começando a justificar um Mac dedicado — e em quais casos vale mais investir em outra plataforma.
Por que a IA local está mudando o papel do Mac
Durante anos, a discussão sobre IA da Apple ficou concentrada na Siri. O movimento mais concreto, para muitos desenvolvedores, está acontecendo em outro lugar: modelos abertos que podem ser executados no próprio computador, junto com ferramentas capazes de automatizar tarefas e interagir com serviços locais.
O Mac mini combina tamanho reduzido, baixo ruído e consumo moderado. Isso importa quando a ideia é deixar uma máquina ligada para servir modelos, executar tarefas agendadas ou hospedar um agente de IA. O OpenClaw, citado no contexto da procura por esses equipamentos, ajudou a popularizar esse tipo de uso. Ainda assim, o software não elimina os limites de RAM, armazenamento e capacidade de processamento da máquina.
Na prática, o apelo está em ter um computador que permanece disponível sem ocupar o espaço ou consumir a energia de uma workstation convencional. Um Mac mini pode funcionar como servidor doméstico para inferência, automações e serviços de desenvolvimento. Já um Mac Studio oferece mais margem de expansão de memória e desempenho, mas custa consideravelmente mais. A escolha depende do modelo que você quer executar e de quantas solicitações simultâneas espera atender.
Memória unificada: vantagem real, não mágica
Desde o M1, CPU, GPU e outros componentes do chip Apple Silicon podem acessar um conjunto compartilhado de memória. Em uma configuração tradicional com uma placa de vídeo dedicada, a GPU costuma ter sua própria VRAM, além da RAM do sistema. No Mac, a memória unificada reduz a necessidade de copiar dados entre esses espaços e permite que a GPU use uma parcela da memória disponível para carregar modelos maiores.
Esse desenho é útil para inferência local, mas precisa ser interpretado corretamente. Se um Mac tem 16 GB de memória unificada, isso não significa que os 16 GB estão livres para o modelo: o sistema operacional, o editor, o navegador, o Docker e outros processos também consomem memória. Um modelo quantizado pode caber onde uma versão em precisão maior não cabe, mas quantização reduz o tamanho e pode afetar a qualidade das respostas.
Também não dá para comparar apenas a quantidade de memória. Largura de banda, geração do chip, desempenho da GPU e suporte da ferramenta de inferência influenciam a velocidade. A memória unificada ajuda a manter o modelo carregado; ela não transforma automaticamente o Mac em um equivalente a uma GPU NVIDIA de alto desempenho para treinamento.
Inferência local não é treinamento de modelos
Executar um modelo já treinado, gerar embeddings ou testar um assistente de código são tarefas diferentes de treinar um modelo grande do zero. O Mac pode ser bastante prático para experimentar inferência, prototipar aplicações e manter dados no dispositivo. Para treinamento pesado, várias GPUs NVIDIA com CUDA ainda são uma escolha mais comum, apoiada por um ecossistema amplo de bibliotecas e infraestrutura.
Para um desenvolvedor web, isso costuma ser uma distinção decisiva. Se você quer testar um modelo local para resumir documentos internos ou gerar sugestões de código, pode não precisar de uma workstation. Se precisa treinar ou ajustar modelos em escala, usar CUDA em uma máquina Linux ou contratar uma GPU na nuvem tende a ser mais simples de escalar e administrar.
Mac mini, Mac Studio ou uma alternativa com Linux?
O Mac mini faz sentido quando a prioridade é uma máquina pequena, silenciosa e dedicada a tarefas contínuas. Ele também pode ser um segundo computador de trabalho ou um servidor de laboratório. O cuidado é não comprar a configuração básica supondo que a memória poderá ser ampliada depois: em Macs Apple Silicon, memória e armazenamento são decisões que precisam ser feitas na compra.
O Mac Studio é mais adequado para quem precisa de mais memória unificada, mais desempenho sustentado ou de uma máquina que também será estação principal de desenvolvimento. Essa folga pode ajudar a manter um modelo carregado enquanto IDE, navegador, containers e outros serviços estão ativos. Porém, se o objetivo é apenas chamar uma API de IA na nuvem, pagar pela configuração mais cara dificilmente se justifica.
Uma máquina Linux com GPU NVIDIA oferece vantagens diferentes: CUDA, uma seleção extensa de ferramentas para machine learning e possibilidade de trocar ou ampliar componentes em certos formatos. Em contrapartida, pode exigir mais espaço, energia, configuração e manutenção. Para tarefas que usam principalmente CPU e modelos menores, um mini PC Linux também pode ser uma alternativa econômica; não espere, porém, o mesmo desempenho de inferência de uma GPU dedicada.
Na minha avaliação, a comparação deve começar pela carga real, não pela marca do chip. Se seu trabalho depende de Xcode, desenvolvimento para o ecossistema Apple ou uma máquina compacta para inferência local, o Mac ganha pontos claros. Se você precisa de CUDA, múltiplas GPUs ou expansão de hardware, Linux costuma oferecer mais flexibilidade. Se a IA é usada apenas ocasionalmente, uma API hospedada pode sair mais barata do que manter um computador potente ligado.
O impacto para quem programa no dia a dia
Para desenvolvimento web, o processador não é o único gargalo. Uma aplicação pode envolver IDE, servidor local, navegador com várias abas, banco de dados, containers e uma ou mais máquinas virtuais. A memória disponível afeta diretamente quantos desses componentes você consegue manter abertos sem recorrer à troca de memória em disco.
Se você também executa um modelo local, ele compete por recursos com esse ambiente. Isso pode piorar a experiência de compilação, aumentar o uso de memória e tornar mais lenta a alternância entre tarefas. Um Mac com memória unificada generosa pode lidar bem com esse cenário, mas a configuração precisa ser dimensionada pelo conjunto de processos, não somente pelo requisito do modelo.
Considere ainda o tipo de compilação. Builds incrementais de projetos pequenos podem se beneficiar bastante de um processador rápido, enquanto builds grandes, múltiplos workers e testes paralelos também dependem de memória e armazenamento. Para longas sessões de código, ergonomia e ambiente de trabalho continuam importando: um Mac mini não inclui monitor, teclado ou mouse. O custo total deve incluir esses itens, além de armazenamento externo ou serviços necessários ao fluxo de trabalho.
Na Prática: testar um modelo local com Ollama
Uma forma simples de avaliar se a IA local serve para seu fluxo é subir um modelo no próprio computador e chamá-lo por HTTP. O exemplo abaixo usa a API local do Ollama. Primeiro, instale o Ollama, baixe um modelo compatível com sua máquina e deixe o serviço em execução; depois, instale a biblioteca de requisições do Python.
ollama pull qwen2.5:7b
python -m pip install requests
O script envia uma pergunta para o endpoint local. O nome do modelo deve corresponder ao que você baixou. A chamada usa streaming desativado para receber uma resposta JSON completa, o que simplifica a integração em um protótipo.
import requests

url = "http://localhost:11434/api/generate"
payload = {
    "model": "qwen2.5:7b",
    "prompt": "Explique, em três tópicos, como funciona uma API REST.",
    "stream": False
}

response = requests.post(url, json=payload, timeout=120)
response.raise_for_status()

data = response.json()
print(data["response"])
Esse teste ajuda a responder perguntas práticas: o modelo carrega sem esgotar a memória? A latência é aceitável? O resultado tem qualidade suficiente para sua tarefa? Repita o teste com o editor, o navegador e os containers que você usa de verdade. Uma demonstração executada com o restante do sistema fechado pode dar uma impressão enganosa do desempenho cotidiano.
Para uma aplicação real, não trate esse endpoint como se fosse automaticamente um serviço pronto para produção. Defina limites de tempo, trate indisponibilidade, valide a saída do modelo e considere autenticação e isolamento se o serviço deixar de ficar restrito ao próprio computador. O fato de a inferência ocorrer localmente também não elimina riscos: prompts podem conter dados sensíveis, e ferramentas de agente podem executar ações que precisam de permissões controladas.
Erros comuns ao comprar um Mac para IA
- Comprar pela quantidade de núcleos, sem olhar a memória. Um modelo que não cabe na memória disponível pode exigir ajustes, descarregamento ou uso de uma versão menor. Verifique o consumo do sistema e das aplicações simultâneas.
- Confundir inferência com treinamento. Rodar um modelo local não significa que a máquina seja adequada para treinar modelos grandes. O ecossistema e o tipo de GPU fazem diferença.
- Assumir que toda ferramenta aproveita igualmente o Apple Silicon. O desempenho depende do backend usado pela aplicação. Confirme o suporte a Metal ou a outros caminhos de aceleração antes de comprar com base em benchmarks de uma ferramenta específica.
- Ignorar o custo de armazenamento. Pesos de modelos, imagens de containers, dependências e projetos podem ocupar espaço rapidamente. Planeje a capacidade interna e, se usar armazenamento externo, verifique se a velocidade atende ao seu fluxo.
- Comprar para uma carga de trabalho hipotética. Se o seu uso é chamar um serviço remoto algumas vezes por dia, uma máquina dedicada à IA pode ficar ociosa. Faça uma estimativa de frequência, custo de API, privacidade e manutenção.
- Deixar um agente com acesso amplo demais. Agentes podem interagir com arquivos, scripts e serviços. Restrinja permissões, use diretórios de teste e revise as ações antes de permitir automações irreversíveis.
O “momento IA” do Mac depende do uso, não do marketing
Os números citados pelo Xataka.com.br mostram uma recuperação importante do Mac, mas não provam que a IA, sozinha, explica o crescimento. O computador continua sendo uma parte menor da receita da Apple do que o iPhone, e o resultado anual ainda precisa ser lido à luz da queda registrada em 2023. O sinal mais interessante é que novos usos — como inferência local e agentes sempre disponíveis — ampliam o papel de máquinas compactas que antes eram vistas sobretudo como computadores de entrada.
Para desenvolvedores, a memória unificada e a eficiência do Apple Silicon tornam o Mac uma opção atraente para prototipagem e execução local de modelos. Não substituem uma GPU dedicada em todo cenário, nem tornam irrelevantes o preço, a memória e o suporte das ferramentas. Eu escolheria pela carga de trabalho que realmente preciso executar: IDE e containers, modelo local, compilação, privacidade e custo total. É essa conta, e não o rótulo “IA”, que determina se o Mac mini ou o Mac Studio é uma boa compra.
Perguntas frequentes
Um Mac mini serve para executar modelos de IA localmente?
Sim, especialmente para inferência com modelos compatíveis com a memória e o desempenho da configuração. O resultado depende do tamanho e da quantização do modelo, da ferramenta utilizada e das outras aplicações abertas. Ele não substitui automaticamente uma workstation com GPU dedicada.
Memória unificada é melhor do que VRAM dedicada?
Não em todos os casos. A memória unificada facilita o compartilhamento entre CPU e GPU e pode permitir carregar modelos maiores do que a VRAM de uma placa específica. Já uma GPU dedicada pode oferecer mais desempenho e um ecossistema de aceleração mais adequado para determinadas cargas, como treinamento com CUDA.
Vale comprar um Mac Studio para programar com IA?
Vale se você precisa de mais memória e desempenho para executar modelos junto com ferramentas de desenvolvimento, ou se o computador também será sua estação principal. Se usa APIs na nuvem ou só testa modelos pequenos ocasionalmente, um Mac mini ou até o computador que já possui pode ser suficiente.
É melhor rodar IA localmente ou usar uma API na nuvem?
Depende de privacidade, latência, custo e escala. A execução local oferece mais controle sobre os dados e pode ser conveniente para experimentos frequentes. APIs hospedadas evitam comprar e manter hardware, além de facilitar o acesso a modelos maiores. Para decidir, compare o custo recorrente da API com o custo total da máquina e da energia.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.