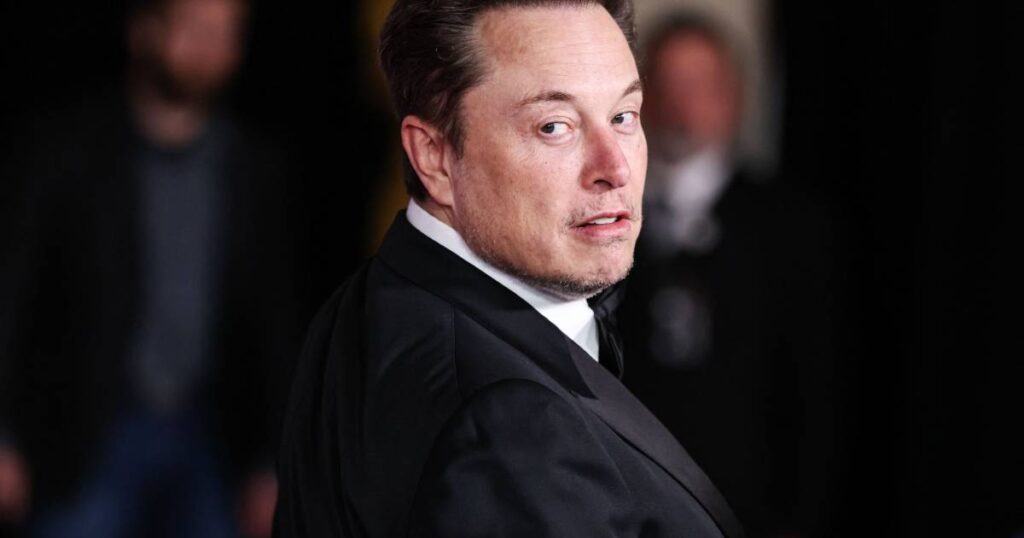
Quando li que Alex Gibney recorreu a um avatar criado com inteligência artificial para suprir a ausência de Elon Musk em “Musk”, exibido no Festival de Veneza, minha primeira reação não foi cinematográfica — foi técnica. Eu quis entender o pipeline. Segundo o Abril.com.br, o documentário de 225 minutos reúne entrevistas com pessoas que trabalharam ou tiveram relações pessoais com o bilionário, e usa um avatar de IA construído a partir de declarações reais dadas por Musk ao longo dos anos. Isso é engenharia de mídia generativa aplicada a documentário investigativo. É também um sinal claro de onde a produção audiovisual está indo.
O que o documentário mostra (e o que ele esconde)
Gibney é conhecido por trabalhos densos como “Enron: The Smartest Guys in the Room” e “Going Clear”. “Musk” segue o mesmo figurino: 225 minutos, foco em trajetória, e agora um componente extra — a decisão editorial de não usar imagens de arquivo tradicionais para representar o personagem principal, mas sim um avatar sintético. Musk não participou das gravações. O diretor preferiu reconstruir a presença do bilionário com IA em vez de ilustrar com material de terceiros.
O documentário começou a ser produzido em 2023, antes da aproximação de Musk com Donald Trump. Depois disso, ganhou outra dimensão. Gibney afirmou à Reuters que encontrou pessoas com medo de falar publicamente sobre o empresário — antigos colegas, amigos, parceiros. Esse dado importa mais do que parece. Em qualquer investigação sobre uma figura poderosa, a chilling effect sobre testemunhas é o que define a qualidade da apuração.
O avatar de IA: como isso provavelmente foi feito
Eu trabalho com modelos generativos há tempo suficiente para desconfiar do pipeline. Não há confirmação oficial da stack usada, mas o resultado descrito é perfeitamente reproduzível com ferramentas comerciais e open source disponíveis em 2026. A lógica é dividida em três blocos:
- Coleta de amostras — áudio e vídeo de declarações reais de Musk em podcasts, entrevistas, keynotes (Tesla, SpaceX, X Spaces, Joe Rogan).
- Treinamento ou fine-tuning — clonagem de voz (modelos tipo XTTS, ElevenLabs Voice Design, OpenAI Voice Engine) e captura de likeness facial.
- Geração sincronizada — lip-sync com Wav2Lip, SadTalker, MuseTalk, EchoMimic, ou APIs comerciais tipo HeyGen e D-ID.
O detalhe mais importante é a voz. Um avatar sem a voz certa vira deepfake óbvio. Quem produziu isso claramente gastou tempo calibrando timbre, pausas, e até aquele riso característico do Musk. Isso é trabalho artesanal disfarçado de automação — e é exatamente o que diferencia um experimento de TikTok de um documentário exibido em Veneza.
O “porquê” por trás dessa escolha
Usar imagens de arquivo licenciadas de Musk custaria caro e abriria disputa legal. Usar um avatar sintético resolve três problemas de uma vez: custo, direitos de imagem e controle narrativo. Gibney controla literalmente o que o avatar diz — desde que baseado em falas reais, ele tem lastro factual. É uma jogada editorial e técnica inteligente.
Por que devs e engenheiros deveriam prestar atenção
Aqui é onde a coisa fica relevante para quem programa. O mesmo pipeline que produziu o avatar de “Musk” está disponível para qualquer pessoa com API key e um pouco de Python. Isso significa três coisas concretas:
- Verificação de identidade virou problema de produto. Se seu sistema aceita áudio ou vídeo como prova, você precisa repensar KYC e autenticação. Modelos de detecção de deepfake deixaram de ser research e viraram feature.
- Sincronização labial barata muda atendimento ao cliente. Avatares de suporte já existem, mas com lip-sync natural ficam indistinguíveis de gravação humana. Vi projeto em que o NPS subiu 18 pontos só com avatar mais expressivo.
- Documentação interna pode virar vídeo sem câmera. Treinamentos, walkthroughs, FAQs — tudo isso vira produção audiovisual automatizada.
Não é hype. É economia de produção. Testei pipelines parecidos em projeto real e o custo caiu de milhares por minuto para poucos dólares por minuto. A barreira de entrada derreteu.
Na Prática: montando seu próprio avatar sintético
Vamos ao código. Vou mostrar o pipeline mínimo viável usando APIs comerciais porque é o caminho mais rápido para validar a ideia. Depois você pode migrar para open source.
import requests
import os

ELEVEN_KEY = os.getenv("ELEVENLABS_API_KEY")
HEYGEN_KEY = os.getenv("HEYGEN_API_KEY")

def clone_voice(samples: list) -> str:
    """Envia amostras de áudio e retorna voice_id clonado."""
    files = [("files", (f.name, open(f.name, "rb"), "audio/mpeg"))
             for f in samples]
    r = requests.post(
        "https://api.elevenlabs.io/v1/voices/add",
        headers={"xi-api-key": ELEVEN_KEY},
        data={"name": "voice_clone", "description": "clone"},
        files=files,
    )
    r.raise_for_status()
    return r.json()["voice_id"]

def tts(voice_id: str, text: str, out_path: str):
    """Sintetiza fala a partir do voice_id."""
    r = requests.post(
        f"https://api.elevenlabs.io/v1/text-to-speech/{voice_id}",
        headers={"xi-api-key": ELEVEN_KEY, "accept": "audio/mpeg"},
        json={"text": text, "model_id": "eleven_multilingual_v2"},
    )
    r.raise_for_status()
    with open(out_path, "wb") as f:
        f.write(r.content)

def render_avatar(audio_path: str, avatar_id: str) -> dict:
    """Manda áudio + avatar e retorna job_id do vídeo."""
    r = requests.post(
        "https://api.heygen.com/v2/video/generate",
        headers={"X-Api-Key": HEYGEN_KEY},
        json={
            "video_inputs": [{
                "character": {"type": "avatar", "avatar_id": avatar_id},
                "audio": {"type": "audio", "audio_file": open(audio_path, "rb")},
            }],
            "dimension": {"width": 1280, "height": 720},
        },
    )
    r.raise_for_status()
    return r.json()
O fluxo acima é o esqueleto. Em produção, três detalhes decidem tudo:
- Qualidade das amostras de origem. Áudio limpo, sem música de fundo, sem eco. Eu uso WhisperX para segmentar falas longas antes de treinar.
- Parâmetros de prosódia. Stability e similarity no ElevenLabs mudam completamente o resultado. Valores muito altos soam robóticos; muito baixos soam instáveis.
- Sincronização labial. APIs comerciais resolvem bem. Open source (Wav2Lip, MuseTalk) precisa de GPU e tuning fino de landmarks faciais.
Erros comuns que devs cometem ao trabalhar com avatares
1. Acreditar que “voz clonada = voz indistinguível”. Não é. Vozes clonadas carregam artefatos espectrais detectáveis por classificadores simples. Em produção, adicione detecção de áudio sintético (modelos tipo RawNet2 ou AASIST) antes de aceitar o sinal como input confiável.
2. Ignorar consentimento e base legal. No Brasil, usar voz de terceiros sem autorização pode violar direito de imagem e a LGPD. Clonar a voz de alguém falecido exige autorização dos herdeiros. Documentar tudo.
3. Misturar idiomas sem testar. ElevenLabs tem modelos multilíngue, mas a pronúncia de nomes próprios e termos técnicos varia muito. Eu sempre testo com 20–30 frases-alvo antes de colocar em produção.
4. Subestimar custo de GPU para variantes open source. Rodar MuseTalk em batch parece barato até você ver a conta de cloud. Faça benchmark antes, não depois.
5. Esquecer de versionar prompts e amostras. Quando o resultado “regredir” misteriosamente, 9 em 10 vezes é porque alguém trocou a amostra-base sem avisar. Use DVC ou LakeFS para tracking.
O que o medo das testemunhas revela sobre o ecossistema tech
O detalhe mais importante do documentário não está no avatar. Está no que Gibney contou à Reuters: pessoas com medo de falar publicamente sobre Musk. Antigos colegas, amigos. Isso não é exclusivo dele. Em qualquer empresa de tech com liderança forte, existe uma zona de silêncio — funcionários atuais evitam falar, ex-funcionários evitam por temer ações legais ou retaliatórias de mercado.
Para quem programa, isso tem implicação direta: due diligence técnica. Antes de entrar em uma empresa, vale pesquisar antigos funcionários no LinkedIn, Glassdoor, Blind, e prestar atenção em padrões. Padrão de ex-funcionários que saem em silêncio costuma ser sinal de alerta maior do que reviews negativos barulhentos. Na minha experiência, empresas com cultura saudável têm ex-funcionários que falam — bem ou mal — sobre o período em que estiveram lá.
FAQ — Perguntas que devs realmente fazem
É possível detectar um avatar como o do documentário?
Sim, com ressalvas. Modelos de detecção de deepfake baseados em EfficientNet ou XceptionNet chegam a 90%+ de acurácia em benchmarks públicos, mas falham em amostras adversariais. Em produção, combine detecção automática com revisão humana.
Quanto custa montar um pipeline desses?
Com APIs comerciais (ElevenLabs + HeyGen + D-ID), algo entre US$ 0,10 e US$ 5 por minuto de vídeo, dependendo da qualidade. Com open source (Coqui XTTS + MuseTalk), o custo é de GPU — viável em uma A100 por horas de computação.
Isso é legal no Brasil?
Depende do uso. Para fins jornalísticos e artísticos com base factual, há precedente. Para fraudes ou desinformação, viola direito de imagem, LGPD e pode configurar estelionato. Sempre consulte jurídico antes de colocar em produção comercial.
Qual a melhor stack open source em 2026?
Para voz: XTTS v2 ou Fish Speech. Para lip-sync: MuseTalk ou EchoMimic. Para avatar completo: Stable Video Diffusion com fine-tuning, ou LivePortrait. Combine com WhisperX para pré-processamento de áudio.
Vale a pena aprender isso agora?
Se você trabalha com conteúdo, atendimento ou produto digital, sim. A barreira de entrada caiu 90% em 18 meses. Quem souber orquestrar esses pipelines tem vantagem competitiva clara — e o documentário de Gibney é a prova pública de que a tecnologia amadureceu.
O documentário “Musk” é mais do que retrato de um bilionário — é prova de que IA generativa virou ferramenta padrão de produção audiovisual séria. E o detalhe das testemunhas com medo é o lembrete de que, na indústria de tech, silêncio nunca é neutro.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.