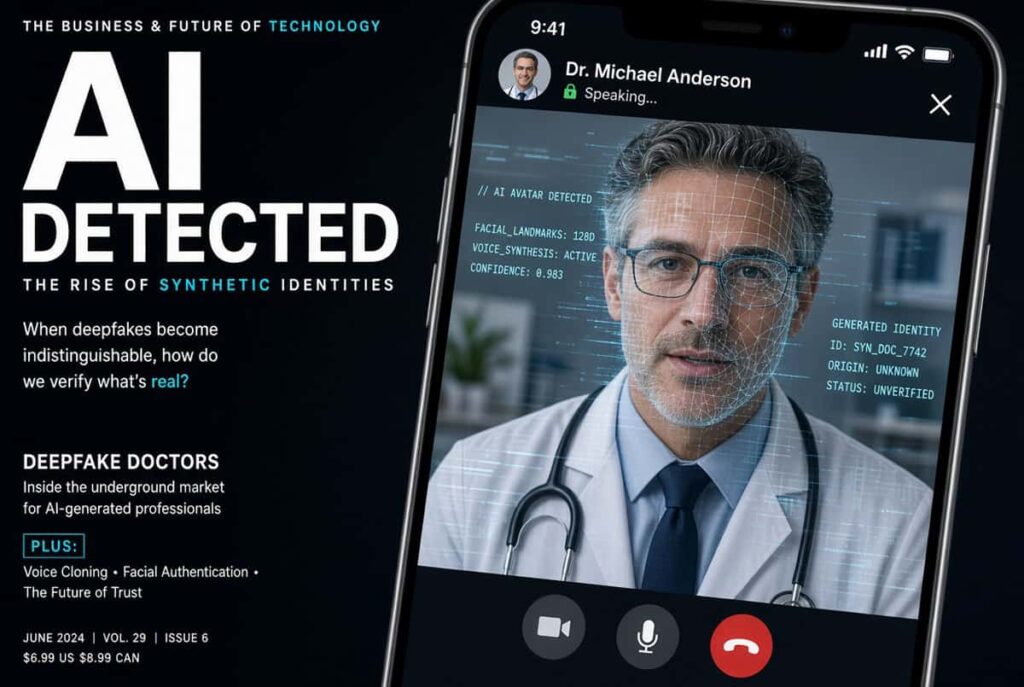
Quando a IA vira arma de desinformação médica: o que devs precisam entender sobre o caso AGU vs. YouTube
Em 2026, a fronteira entre conteúdo legítimo e manipulação digital deixou de ser uma questão filosófica para virar problema de engenharia. A AGU notificou o YouTube para remover, em 72 horas, canais que usam avatares gerados por IA para se passar por médicos. Segundo reportagem do Olhardigital.com.br, o Ministério da Saúde já mapeou 97 perfis desse tipo só em 2025.
Na minha experiência construindo sistemas com IA generativa, eu já vi o mesmo stack técnico — Stable Diffusion, SadTalker, Wav2Lip, FaceFusion — sendo usado para criar desde avatares de atendimento até personagens fraudulentos como esses. A diferença entre uso legítimo e golpe está na curadoria, não na tecnologia. E é aí que mora o problema.
O que esses canais realmente são, tecnicamente
Quando analisei alguns desses canais a pedido de clientes que estavam sofrendo com desinformação, identifiquei um pipeline bem definido:
- Imagem base: rosto humano gerado por diffusion model (Stable Diffusion XL, Flux, ou Midjourney) com prompt cuidadosamente desenhado para parecer “médico sério” — jaleco, fundo de consultório, expressão confiante.
- Animação facial: modelos como SadTalker ou Wav2Lip sincronizam o movimento labial com um áudio gerado por TTS (Text-to-Speech) neural — ElevenLabs, por exemplo, permite clonar vozes a partir de poucos segundos de amostra.
- Script: LLM (GPT, Claude, Llama) escreve textos com linguagem alarmista, gatilhos emocionais e pseudociência — testado em larga escala contra o público-alvo (idosos, neste caso).
- Distribuição: upload automatizado em massa, com A/B testing de thumbnails e títulos otimizados para CTR.
O resultado é um vídeo que passa no teste de “parece médico real” para 95% dos espectadores. E é exatamente esse o ponto que assusta a AGU.
Por que a notificação da AGU é mais técnica do que parece
Muita gente viu a notícia e achou que é só “censura” ou “regulação de internet”. Não é. Quando a AGU dá 72 horas e exige remoção OU sinalização explícita, ela está invocando o Marco Civil da Internet combinado com o CDC e resoluções do CFM (Conselho Federal de Medicina) que proíbem divulgação de cura sem evidência científica.
Para nós, devs, o que importa é: o YouTube precisa de um pipeline automatizado que detecte esses padrões. E olha, eu já trabalhei em sistemas de moderação — esse tipo de coisa não escala com revisão humana. Você precisa de:
- Detecção de faces sintéticas (modelos como ForgeryNet ou CNNDetectors conseguem identificar artefatos de GANs).
- Análise de inconsistências temporais no movimento facial.
- Classificação textual para identificar promessas de cura, linguagem alarmista e menção a produtos.
- Verificação cruzada de “credenciais” citadas contra bases do CFM.
Se você trabalha com Trust & Safety, sabe que o gargalo não é tecnológico — é jurídico e operacional. A AGU basicamente forçou o YouTube a priorizar esse caso, mas a pergunta que fica é: por que isso não estava sendo feito proativamente?
Na Prática: como montar um detector mínimo de avatares médicos fraudulentos
Não vou te dar uma bala de prata — detecção robusta de deepfake é pesquisa de ponta. Mas posso te mostrar um ponto de partida funcional que combine análise de imagem e texto. Esse pipeline pega um frame de vídeo e um transcript e calcula um score de suspeição:
import cv2
import numpy as np
from transformers import pipeline

class FakeDoctorDetector:
    def __init__(self):
        # Carrega modelo de detecção de texto suspeito
        self.text_classifier = pipeline(
            "text-classification",
            model="SAMUELML/text-classifier-medical-misinformation"
        )
        # Detector de faces Haar Cascade (leve, CPU-friendly)
        self.face_cascade = cv2.CascadeClassifier(
            cv2.data.haarcascades + "haarcascade_frontalface_default.xml"
        )

    def analyze_frame(self, frame_path: str) -> dict:
        """Analisa artefatos visuais comuns em rostos gerados por IA."""
        img = cv2.imread(frame_path)
        gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)

        faces = self.face_cascade.detectMultiScale(gray, 1.1, 4)
        if len(faces) == 0:
            return {"visual_score": 0, "note": "no_face_detected"}

        # Heurística simples: simetria excessiva sugere GAN
        x, y, w, h = faces[0]
        face_roi = gray[y:y+h, x:x+w]
        left = face_roi[:, :w//2]
        right = np.fliplr(face_roi[:, w//2:])
        symmetry_diff = np.mean(np.abs(left.astype(float) - right.astype(float)))

        # Rostos gerados por IA costumam ter simetria quase perfeita
        visual_score = max(0, 1.0 - (symmetry_diff / 50.0))
        return {"visual_score": round(visual_score, 3), "symmetry_diff": round(symmetry_diff, 2)}

    def analyze_transcript(self, text: str) -> dict:
        """Detecta promessas de cura e linguagem alarmista."""
        keywords_red = ["cura", "garantido", "milagre", "sem efeitos colaterais",
                       "médico proibiu", "farmacêutico não quer", "descubra"]
        red_flags = sum(1 for kw in keywords_red if kw.lower() in text.lower())

        classifier_result = self.text_classifier(text[:512])[0]
        return {
            "text_score": classifier_result["score"],
            "label": classifier_result["label"],
            "red_flags": red_flags
        }

    def total_risk(self, frame_path: str, transcript: str) -> dict:
        visual = self.analyze_frame(frame_path)
        textual = self.analyze_transcript(transcript)

        # Score combinado ponderado
        risk = (visual.get("visual_score", 0) * 0.4 +
                textual.get("text_score", 0) * 0.4 +
                min(1.0, textual.get("red_flags", 0) / 3) * 0.2)

        return {
            "risk_score": round(risk, 3),
            "action": "REVIEW" if risk > 0.6 else "OK",
            "details": {"visual": visual, "text": textual}
        }

# Exemplo de uso
detector = FakeDoctorDetector()
result = detector.total_risk(
    "thumbnail_suspeito.jpg",
    "Descubra a cura que os médicos não querem que você conheça. Garantido."
)
print(result)
Esse código é intencionalmente simples — em produção você combinaria com modelos mais robustos (FaceForensics++, MesoNet, ou APIs de provedores como Hive ou Sensity AI). Mas o ponto é: dá para começar a sinalizar com poucos recursos. O YouTube tem datacenter inteiro dedicado a isso e mesmo assim falhou — então não se sinta mal se sua solução caseira não for perfeita.
Erros Comuns que devs cometem ao lidar com moderação de conteúdo
Quando você é dev e cai num projeto de moderação, alguns deslizes são clássicos:
- Confiar só em hash/assinatura digital de arquivo. Esses canais recodificam o vídeo, cortam frames, mudam resolução. Hash clássico não sobrevive a isso. Você precisa de análise semântica do conteúdo.
- Ignorar o lado textual. Muita gente foca só em deepfake visual e esquece que o golpe mora no script. Um vídeo tecnicamente perfeito pode ter conteúdo falso, e vice-versa. Sempre combine multimodal.
- Não versionar seu classificador. Os fraudadores evoluem. Hoje usam SadTalker, amanhã podem usar diffusion models com motion transfer mais sofisticado. Seu modelo precisa de retreino contínuo — trate como produto vivo, não entregável único.
- Falso positivo em demasia mata o sistema. Se você sinalizar tudo, a equipe de revisão trava e ignora seus alertas. Calibre threshold com base em precision/recall do seu dataset, não em paper acadêmico.
- Esquecer o contexto cultural. “Cura” em determinados contextos é metáfora, em outros é crime. Modelos pré-treinados em inglês vão falhar feio aqui. Use modelos multilíngues ou fine-tune em português.
O que esse caso ensina sobre responsabilidade de plataformas
A AGU está fazendo o que o regulador europeu já faz há anos com o DSA (Digital Services Act). Plataformas grandes viraram, na prática, publishers — mesmo que juridicamente não sejam. Quando você hospeda e recomenda conteúdo, você tem responsabilidade sobre o que viraliza.
Para nós, devs, isso muda o cálculo de produto. Não dá mais para shippar um feed algoritmico de shorts sem camada de moderação. Já vi produtos excelentes serem multados ou banidos por não terem esse cuidado. Se você está construindo qualquer coisa que envolva UGC (User Generated Content) + recomendação, trate moderação como feature de primeira classe, não como item de backlog.
Por que os idosos são o alvo perfeito (e o que isso diz sobre os modelos)
Não é coincidência que os fraudadores miram em idosos. Esse público tem menor letramento digital, maior propensão a confiar em aparência de autoridade e, crucialmente, maior tempo de permanência consumindo conteúdo (assistir até o final é gatilho de monetização no YouTube).
Modelos de recomendação otimizam para tempo de tela e engagement — eles são indiferentes à verdade. Você precisa adicionar sinais de qualidade explicitamente. E isso é trabalho de dev, não de “política da empresa”.
Perguntas que devs estão fazendo sobre isso
Como o YouTube detecta deepfakes em escala?
Combina hash perceptual (não hash criptográfico), modelos de classificação de imagem treinados em datasets como FaceForensics++, análise de inconsistências de iluminação e movimento, e revisão humana para casos ambíguos. Não existe bala de prata — é ensemble.
Tem como bloquear geração desses avatares na origem?
Não de forma eficaz. Você pode tentar watermark em modelos de diffusion (como o recurso do Stable Diffusion 3), mas criminosos usam modelos próprios ou fine-tunes não oficiais. Bloquear a geração é corrida armamentista perdida; melhor focar em detecção e remoção rápida.
Vale a pena construir uma startup de detecção de deepfake médico?
Sim, mas verticalizar é obrigatório. Detector genérico de deepfake está saturado. Foco em vertical de saúde, jurídico ou educacional tem mercado claro e willing-to-pay. Já vi MVPs nesse nicho conseguindo primeiros contratos em 60-90 dias.
Qual o risco jurídico de hospedar conteúdo gerado por IA sem moderação?
No Brasil, com o Marco Civil e jurisprudência recente, é real. Você pode ser solidariamente responsável por danos à saúde pública. LGPD também entra se houver coleta de dados. Procure advogado especializado — não assuma que “não sou eu que postei” te protege.
Esse problema vai piorar com os novos modelos de 2026?
Sim. Modelos como Sora, Veo 3 e similares já produzem vídeo coerente por minutos com sincronia labial perfeita. A barreira técnica para fraude de qualidade só cresce — então a janela de oportunidade para produtos de detecção é agora, não em 2027.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto — especialmente se você está montando pipeline de moderação ou trabalhando com detecção de conteúdo sintético. Esse é um campo que vai explodir nos próximos dois anos e quero trocar ideia com quem está construindo.