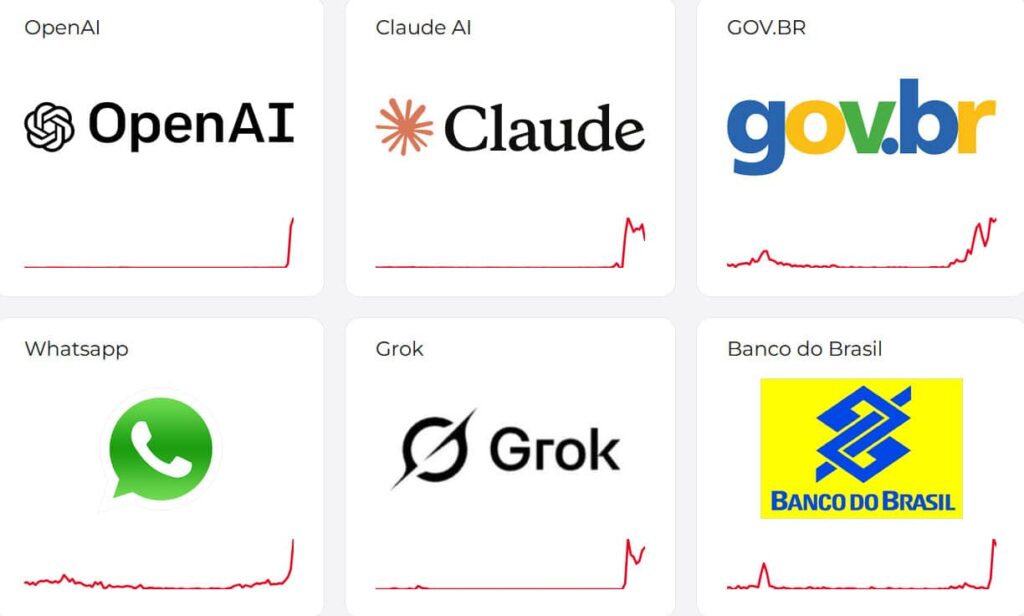
Ontem eu estava rodando um pipeline que dependia do Claude para classificar tickets de suporte quando, do nada, comecei a receber 503 Service Unavailable em massa. Resetei o token, conferi a VPN, verifiquei o status do provedor — e aí percebi que não era comigo. Segundo o Olhardigital.com.br, ChatGPT, Claude e Grok saíram do ar quase ao mesmo tempo, e a queda em cascata ainda derrubou o Gov.br, o Banco do Brasil e a Caixa. A suspeita principal? Uma falha nos data centers da Microsoft Azure, usada pelas três fabricantes de IA. E aqui, como dev, é onde a coisa fica interessante — porque o problema não é “a internet caiu”, é arquitetural.
O que realmente aconteceu: dependência compartilhada, falha compartilhada
Muita gente olha para esse tipo de notícia e pensa: “pane global, azar”. Mas não foi azar — foi concentração de risco. OpenAI, Anthropic e xAI rodam workloads críticos sobre a Azure. Quando um provedor de hiperescala enfrenta uma indisponibilidade regional (ou pior, global), todos os inquilinos daquele andar do prédio apagam junto. É a mesma lógica de colocar o banco, o cartório e o hospital no mesmo transformador de energia e rezar para a companhia elétrica nunca ter um curto.
O detalhe que me chamou a atenção no texto do Olhardigital foi a frase do Dane Knecht, CTO da Cloudflare, desvinculando a empresa dessa ocorrência. Em 2025, a Cloudflare já protagonizou panes que quebraram metade da web — então o mercado ficou em alerta vermelho automaticamente. O fato de a Azure ter sido a origem desta vez expõe um problema estrutural: a web moderna depende de pouquíssimos “landlords digitais” e a tolerância a falha ainda é tratada como exceção, não como requisito.
Por que três IAs rivais caíram juntas? A armadilha do “ambiente gerenciado”
Quando uma startup escolhe Azure, AWS ou GCP, ela está terceirizando não só computação, mas também disponibilidade, rede, DNS, balanceamento, observabilidade e failover. Ótimo para focar no produto. Péssimo quando o provedor está offline. No caso das IAs, existe um agravante: treinar e servir modelos grandes exige hardware especializado (GPUs H100, H200, MI300X) que está concentrado em poucos data centers no mundo. Não dá para simplesmente “migrar para outra região” se a sua carga depende de um cluster físico específico.
Isso cria o que eu chamo de dependência elástica aparente: a API te dá a sensação de infinitude (“é só fazer um POST e pronto”), mas por trás existe um cluster físico finito, com switches, fibra óptica e refrigeração que podem falhar. Quem nunca viu um dashboard da AWS dizendo “increased error rate” sabe do que estou falando.
Na Prática: como blindar seu código contra panes de provedor
Eu mantenho um wrapper interno em Python que uso em qualquer projeto que dependa de API externa. A ideia é simples: nunca confie que o provedor vai estar no ar. Abaixo uma versão enxuta, mas funcional, com retry exponencial, jitter e circuit breaker — três padrões que eu considero obrigatórios:
import time
import random
import requests
from functools import wraps
from typing import Callable, Any

class CircuitBreakerOpen(Exception):
    pass

class CircuitBreaker:
    def __init__(self, failure_threshold: int = 5, reset_timeout: int = 30):
        self.failure_threshold = failure_threshold
        self.reset_timeout = reset_timeout
        self.failures = 0
        self.last_failure = 0
        self.state = "closed"  # closed | open | half-open

    def call(self, func: Callable, *args, **kwargs) -> Any:
        if self.state == "open":
            if time.time() - self.last_failure > self.reset_timeout:
                self.state = "half-open"
            else:
                raise CircuitBreakerOpen("Provedor marcado como indisponível")

        try:
            result = func(*args, **kwargs)
            if self.state == "half-open":
                self.state = "closed"
                self.failures = 0
            return result
        except Exception:
            self.failures += 1
            self.last_failure = time.time()
            if self.failures >= self.failure_threshold:
                self.state = "open"
            raise

def resilient_request(url: str, headers: dict, payload: dict,
                      breaker: CircuitBreaker, max_retries: int = 5):
    @wraps(resilient_request)
    def _do():
        response = requests.post(url, json=payload, headers=headers, timeout=10)
        response.raise_for_status()
        return response.json()

    for attempt in range(max_retries):
        try:
            return breaker.call(_do)
        except (requests.exceptions.HTTPError,
                requests.exceptions.Timeout,
                requests.exceptions.ConnectionError) as e:
            if attempt == max_retries - 1:
                raise
            # Backoff exponencial com jitter
            sleep_for = (2 ** attempt) + random.uniform(0, 1)
            print(f"[retry] tentativa {attempt+1} falhou, aguardando {sleep_for:.2f}s")
            time.sleep(sleep_for)
        except CircuitBreakerOpen:
            raise

# Exemplo de uso
breaker = CircuitBreaker(failure_threshold=3, reset_timeout=60)
try:
    data = resilient_request(
        "https://api.anthropic.com/v1/messages",
        headers={"x-api-key": "SUA_CHAVE", "anthropic-version": "2023-06-01"},
        payload={"model": "claude-opus-4", "max_tokens": 1024,
                 "messages": [{"role": "user", "content": "ping"}]},
        breaker=breaker,
    )
except CircuitBreakerOpen:
    # Aqui entra seu fallback: fila, modelo local, modo degradado
    print("Serviço indisponível. Salvando requisição para reprocessar depois.")
O ponto-chave desse código não é só o retry — é o circuit breaker. Quando você detecta que o provedor está fora, para de martelar a API e libera recursos. Isso evita que seu sistema entre em colapso junto com o do provedor.
Fallback local: Ollama, llama.cpp e a opção nuclear
Para cargas que não exigem o modelo mais potente do mundo, eu mantenho um Ollama rodando num servidor on-premise (ou até numa boa workstation com 32 GB de RAM) servindo modelos como Llama 3.3, Qwen 2.5 ou DeepSeek. Quando a API externa cai, o sistema chaveia automaticamente para o modelo local. A qualidade cai, mas o serviço continua no ar — e isso, para o usuário final, vale muito mais do que a resposta perfeita.
Se você nunca configurou, é literalmente dois comandos:
curl -fsSL https://ollama.com/install.sh | sh
ollama pull llama3.3
ollama serve
A partir daí você tem um endpoint HTTP local compatível com a API da OpenAI. Trocar o base_url é o suficiente — daí a importância de nunca hardcodar o endpoint do provedor no meio do código. Use variável de ambiente ou um pequeno arquivo de configuração.
Erros comuns que eu vejo em produção (e que essa pane escancarou)
1. Confundir SLA com disponibilidade real. SLA de 99,9% parece ótimo até você multiplicar: são quase 43 minutos de downtime por mês permitidos. E pane de hiperescala pode facilmente bater isso em um único dia.
2. Timeout mal configurado. Vi código com timeout=300 numa chamada de IA. Quando o provedor trava, todas as workers ficam bloqueadas esperando 5 minutos. Use timeout agressivo (5–15s) e trate o resto com retry.
3. Hardcodar o provedor no código de aplicação. Em vez de requests.post("https://api.openai.com/..."), use requests.post(f"{settings.LLM_ENDPOINT}/..."). Quando precisar migrar, é uma linha — não uma semana.
4. Não ter fila de reprocessamento. Quando a API volta, todo mundo dispara requisição ao mesmo tempo e derruba o provedor de novo (o famoso thundering herd). Use um broker como RabbitMQ, Redis Streams ou SQS para distribuir a carga.
5. Ignorar provedores de “segunda linha”. Para inferência, dá pra combinar OpenRouter, Together AI, Groq, Fireworks e seu próprio endpoint. Custa um pouco mais, mas a resiliência compensa em qualquer produto sério.
6. Esquecer do cache. Boa parte das chamadas a LLM é repetível ou quase repetível. Um cache semântico simples (vetor + similaridade de cosseno) economiza dinheiro e sobrevive a panes. Eu já escrevi sobre isso no blog — vale procurar.
O que isso muda para o ecossistema brasileiro
O detalhe mais preocupante da notícia do Olhardigital foi o Gov.br e os bancos públicos estarem no mesmo pacote. Sistemas de governo operando em infraestrutura que também hospeda IAs comerciais é, no mínimo, uma escolha arquitetural questionável. Para o dev que trabalha com integração gov (NF-e, eSocial, gov.br ID), minha recomendação é tripla: implemente retentativas longas, mantenha uma fila de operações para processar quando o serviço voltar e nunca bloqueie o fluxo principal esperando resposta síncrona do governo. Use webhooks ou polling assíncrono sempre que possível.
Checklist pós-pane: o que eu reviso em todo projeto afetado
- Timeouts estão em 5–15s para chamadas externas?
- Retry com backoff + jitter está implementado em todo cliente HTTP?
- Circuit breaker existe para cada dependência crítica?
- Fallback (modelo local, modo degradado, cache) está plugado?
- Fila de reprocessamento absorve o backlog pós-pane?
- Observabilidade diferencia “minha aplicação está lenta” de “provedor está fora”?
- Alertas disparam antes do cliente reclamar?
Se você respondeu “não” para mais de dois itens, parabéns — você tem um projeto que vai cair junto com a próxima pane da Azure.
FAQ — Perguntas que devs realmente fazem
Como saber se o provedor está fora antes de levar o cliente a ligar reclamando?
Use o status page oficial combinado com healthchecks sintéticos próprios. Ferramentas como Better Stack, UptimeRobot ou um simples cron com curl já resolvem 80% do problema. Monitore latência também — pane nem sempre é binária.
Vale a pena rodar multi-cloud de verdade?
Depende do seu bolso e do seu time. Para a maioria das empresas, uma estratégia híbrida (provedor principal + fallback on-premise ou em outra cloud) entrega 90% do benefício com 30% do custo. Multi-cloud completo só se justifica em cenários regulados ou com SLA financeiro muito agressivo.
Como faço fallback de LLM sem duplicar custo de API?
Cache semântico + modelo local para prompts repetitivos + API externa só para inferência nova e crítica. Na minha experiência, dá pra cortar 40–60% das chamadas sem perda perceptível de qualidade.
O Cloudflare é mesmo confiável depois das panes recentes?
Confiável, mas não imune. O CTO já admitiu as falhas passadas publicamente — sinal raro e positivo. Para DNS e borda, continua sendo difícil bater em custo-benefício. Só não ponha todos os ovos lá.
Como testar resiliência sem esperar a próxima pane real?
Use Chaos Engineering. Ferramentas como Chaos Toolkit, AWS Fault Injection Service ou Gremlin permitem derrubar dependências sob controle. Eu recomendo rodar o jogo no mínimo uma vez por trimestre em produção — com feature flag desligando o caminho e medindo degradação.
A pane de ontem não foi um caso isolado. Foi um lembrete — pago caro — de que a web moderna é uma torre de cartas e quem ignora isso programa para quebrar. Se você chegou até aqui e reconheceu seu próprio código em algum dos erros comuns, me conta nos comentários qual foi o pior incidente de dependência que você já enfrentou. É dessas histórias que a gente aprende de verdade.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.