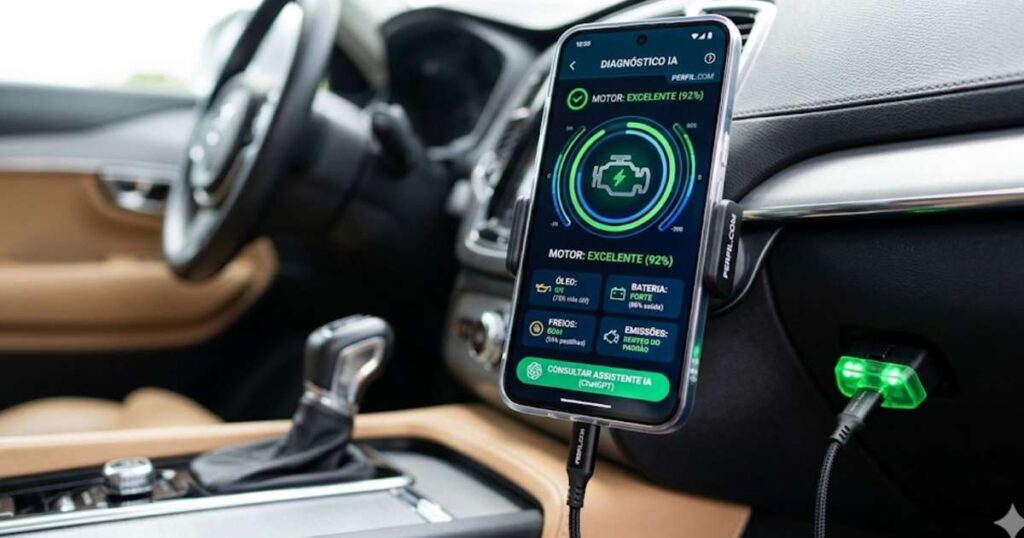
Sabe aquele medo clássico de levar o carro na oficina e sair com um orçamento que dói no bolso? Eu já passei por isso mais vezes do que gostaria de admitir. O que pouca gente entende é que existe uma camada técnica entre o painel do seu carro e o mecânico — e essa camada está sendo completamente redesenhada por IA generativa. A reportagem do Terra.com.br sobre scanners OBD2 turbinados com ChatGPT me chamou atenção porque toca num ponto que devs entendem bem: dados brutos só viram valor quando passam por uma camada inteligente de interpretação.
Por que o OBD2 tradicional era limitado — e o que mudou
O protocolo OBD2 existe desde os anos 90 e define uma interface padrão de diagnóstico veicular. Todo carro fabricado no Brasil a partir de 2010 (e na Europa/EUA desde 1996) tem uma porta J1962 — aquele conector trapezoidal geralmente abaixo do volante. O problema nunca foi a coleta de dados. O problema sempre foi o que fazer com eles.
Os scanners antigos funcionavam basicamente como tradutores do PID (Parameter ID). Você conecta, lê códigos de erro padronizados (DTCs — Diagnostic Trouble Codes), e recebe algo como P0420. Aí você abre o Google, descobre que é “Catalyst System Efficiency Below Threshold”, e fica na dúvida se é o catalisador, o sensor de oxigênio, ou se o mecânico está te vendendo um peixe.
O que a nova geração de dispositivos faz — e aqui entra o diferencial técnico — é enviar esses dados estruturados como contexto para um LLM. Não é mágica. É engenharia de prompt aplicada a telemetria veicular. O scanner coleta, normaliza, e a IA interpreta. O resultado sai em linguagem natural, no celular do motorista, antes mesmo dele sair de casa.
A stack técnica por trás desses dispositivos
Quando comecei a fuçar essas ferramentas, identifiquei alguns componentes que valem a pena entender:
- Microcontrolador ELM327 (ou clones STM32 mais modernos) — faz a ponte entre o barramento CAN do carro e o Bluetooth. Os clones baratos são famosos por serem instáveis, então cuidado.
- Protocolos OBD2 — CAN (ISO 15765) é o mais comum hoje, mas ainda existem carros usando ISO 9141-2 e KWP2000. Seu scanner precisa negociar automaticamente.
- Camada BLE/Bluetooth — comunicação com o smartphone. BLE consome menos bateria do carro, mas tem latência maior para streaming contínuo.
- App mobile — geralmente Flutter ou React Native, com integração direta com a API do LLM (OpenAI, Claude, Gemini).
- LLM como camada de raciocínio — recebe os códigos, contexto do veículo (modelo, ano, quilometragem) e gera explicações contextualizadas.
Na minha experiência testando essas ferramentas, o que separa um app medíocre de um excelente é a qualidade do prompt engineering. Um prompt ruim simplesmente joga os códigos DTC no LLM e pede “explique”. Um prompt bem feito inclui o histórico do veículo, padrões de uso, e até a temperatura ambiente — porque sim, DTCs mudam de significado dependendo do contexto térmico.
Na Prática: construindo um parser OBD2 com LLM integrado
Como devs, a parte mais interessante é entender como integrar isso num projeto próprio. Vou mostrar um exemplo funcional em Python que lê dados OBD2 via biblioteca obd e envia para um LLM gerar explicações em linguagem natural:
import obd
import openai

class DiagnosticoIA:
    def __init__(self, api_key: str):
        self.client = openai.OpenAI(api_key=api_key)
        self.connection = obd.OBD()  # auto-conecta via Bluetooth

    def ler_dtc(self) -> list:
        """Lê os códigos de erro ativos do veículo."""
        cmd = obd.commands.GET_DTC
        response = self.connection.query(cmd)
        if response.is_null():
            return []
        return [str(code) for code in response.value]

    def explicar_com_llm(self, dtcs: list, contexto_veiculo: dict) -> str:
        """Envia os DTCs para o LLM interpretar."""
        prompt = f"""
        Você é um mecânico especialista. Analise estes códigos OBD2:
        Códigos ativos: {dtcs}
        Veículo: {contexto_veiculo.get('modelo', 'desconhecido')}
        Ano: {contexto_veiculo.get('ano', 'desconhecido')}
        Quilometragem: {contexto_veiculo.get('km', 'desconhecida')}

        Para cada código, explique:
        1. O que significa em linguagem simples
        2. Sintomas que o motorista pode notar
        3. Faixa de preço estimada do reparo
        4. Se é urgente ou pode esperar

        Responda em português brasileiro, tom direto e objetivo.
        """
        response = self.client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}],
            temperature=0.3  # baixa para respostas mais técnicas
        )
        return response.choices[0].message.content

    def monitorar_tempo_real(self):
        """Monitora parâmetros críticos em tempo real."""
        comandos = [
            obd.commands.RPM,
            obd.commands.COOLANT_TEMP,
            obd.commands.SHORT_FUEL_TRIM_1,
            obd.commands.LONG_FUEL_TRIM_1,
            obd.commands.VOLTAGE
        ]
        dados = {}
        for cmd in comandos:
            response = self.connection.query(cmd)
            if not response.is_null():
                dados[str(cmd.name)] = str(response.value)
        return dados

# Uso prático
diag = DiagnosticoIA(api_key="sua-key-aqui")
codigos = diag.ler_dtc()
veiculo = {"modelo": "Honda Civic", "ano": 2019, "km": 85000}
print(diag.explicar_com_llm(codigos, veiculo))
Esse script demonstra o pipeline completo: coleta via protocolo OBD2 → estruturação dos dados → envio para o LLM com contexto relevante → resposta natural. Em produção, você adicionaria cache de respostas, retry logic, e talvez um modelo local menor (como Llama 3.1 8B rodando via Ollama) para reduzir custo de API.
Erros Comuns que devs cometem ao trabalhar com OBD2
Depois de apanhar bastante testando esses protocolos, listei os tropeços mais frequentes que vejo em projetos de garagem e até em produtos comerciais:
1. Achar que todo ELM327 é igual
Existem dezenas de clones chineses com firmware bugado que não implementam corretamente os protocolos CAN. Você conecta, funciona uma vez, depois trava. Invista em chips baseados em STM32 com firmware open-source (como o obd2-can-bus-stm32 no GitHub).
2. Ignorar o handshake do protocolo
O carro não responde comandos imediatamente. Existe um handshake inicial que varia por fabricante. Scanners malfeitos ignoram isso e travam o barramento CAN — em casos extremos, podem impedir o carro de dar partida. Isso é sério.
3. Confundir Mode 01 (dados ao vivo) com Mode 03 (DTCs)
São coisas diferentes. Mode 01 são os PIDs em tempo real (RPM, temperatura, pressão). Mode 03 são os códigos de falha armazenados. Misturar isso no prompt do LLM gera respostas sem sentido.
4. Esquecer de implementar timeout e reconexão
Bluetooth cai. O carro desliga. O scanner perde conexão. Seu código precisa lidar com reconexão automática e degradação graciosa. Se você só mostra “erro de conexão” sem tentar de novo, a UX fica horrível.
5. Mandar dados brutos demais pro modelo
Jogar 200 PIDs simultaneamente no contexto do LLM desperdiça tokens e dilui a resposta. Filtre primeiro, mande só o que é relevante. Um LLM interpreta melhor 5 PIDs com anomalia do que 200 PIDs normais.
Manutenção preditiva vs. reativa: o ganho real
O ponto que o Terra mencionou — e que vale aprofundar — é a transição de diagnóstico reativo para preditivo. Em software, chamamos isso de observabilidade. No carro, é a mesma coisa: em vez de esperar o erro acontecer, você monitora tendências.
Na prática, isso funciona com análise estatística dos PIDs ao longo do tempo. Por exemplo:
- Tensão da bateria — se a média decai 0.1V por mês, em 6 meses ela morre. O LLM detecta essa tendência antes de você ficar na mão.
- Long Term Fuel Trim — valores fora de ±10% indicam vazamento de vácuo ou sensor MAF sujo. Sem monitoramento, você só percebe quando o consumo sobe 15%.
- Coolant Temperature — se demora muito para chegar a 90°C, o termostato pode estar falhando. Reparo barato se pego cedo, termostato travado pode fritar o motor.
Como devs, a sacada é: estamos falando de time-series data + anomaly detection + LLM como camada explicativa. É o mesmo stack de monitoramento de produção (Prometheus + Grafana + alertas), só que aplicado a um veículo. Quando você pensa assim, fica óbvio o motivo de a economia chegar a R$ 2.000 anuais — você troca o conceito de “apagar incêndio” por “prevenir incêndio”.
FAQ — Perguntas que devs fazem sobre scanners OBD2 com IA
Funciona em qualquer carro?
Funciona em qualquer veículo com porta OBD2 padrão (Brasil: 2010+, EUA/Europa: 1996+). Veículos muito antigos, elétricos ou híbridos podem ter protocolos proprietários que exigem adaptadores específicos.
Posso usar com qualquer modelo de LLM?
Tecnicamente sim. OpenAI, Anthropic, Google Gemini, e até modelos locais como Llama 3.1 via Ollama. Para mobile, modelos quantizados rodam em smartphones topo de linha com latência aceitável.
Tem privacidade envolvida?
Muita. Você está enviando dados de telemetria do seu veículo para servidores de terceiros. Procure scanners que ofereçam modo offline (LLM local) ou criptografia ponta a ponta. Cuidado com apps gratuitos que monetizam seus dados de direção.
Quanto custa um setup completo?
Scanners Bluetooth genéricos: R$ 50–200. Apps de qualidade: R$ 50–300/ano (assinatura). Versão DIY com ESP32 + Ollama: ~R$ 300 inicial, mas exige conhecimento técnico.
O LLM pode alucinar e dar diagnóstico errado?
Pode. Por isso apps sérios usam RAG (Retrieval-Augmented Generation) com base de dados técnica validada. O LLM não inventa — ele consulta uma base curada de DTCs e sintomas. Implementar isso bem é a diferença entre produto confiável e brinquedo perigoso.
O que isso significa para devs que não mexem com carros
Pode parecer distante do seu dia a dia, mas tem duas lições valiosas aqui. A primeira: dados + LLM = produto. Esse caso de uso automotivo é só um exemplo. O mesmo padrão se aplica a qualquer domínio com dados técnicos densos que precisam virar ação para leigos — saúde, direito, finanças, agricultura. A segunda: interfaces conversacionais ganham quando o domínio é hostil ao usuário. Ninguém quer aprender 200 códigos DTC. Todo mundo quer uma resposta em português claro.
Se você é dev e quer entrar nesse mercado, comece pequeno: baixe uma biblioteca OBD2 para sua linguagem favorita, conecte num scanner usado, e veja que dados saem do seu próprio carro. A curva de aprendizado é baixa, e o potencial de produto é enorme — especialmente no Brasil, onde o parque automotivo é antigo e a cultura de “entender o carro” é fraca.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto. Se quiser, posso escrever um próximo post mostrando como construir um dashboard web em tempo real com os dados OBD2 — ou como treinar um modelo local focado em diagnóstico automotivo. É só pedir.