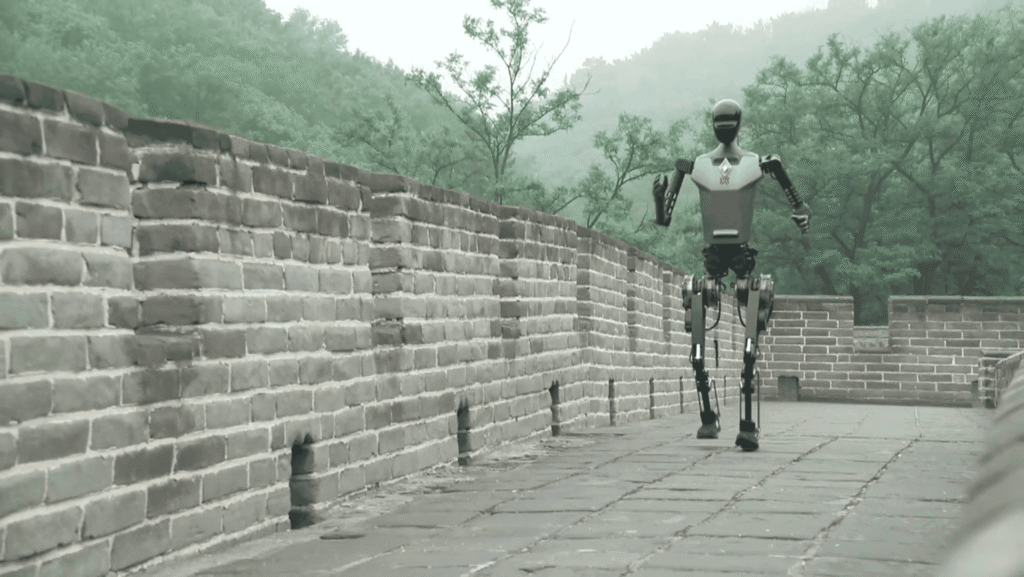
Quando vi a notícia no Olhar Digital sobre o Tiangong Ultra correndo os 100 metros em 8,64 segundos, minha primeira reação foi desconfiar. Humanoide chinês batendo recorde do Bolt por quase um segundo inteiro? Parece headline de clickbait. Mas quando você mergulha nos dados técnicos — evolução de 9,39s na eliminatória para 8,64s na final em poucas horas — percebe que o feito não é propaganda, é engenharia iterativa funcionando em tempo real. E como dev, isso me interessa muito mais do que o número em si.
O que o Tiangong Ultra realmente mostra sobre o estado da robótica humanoide
O ponto central não é que um robô “correu mais rápido que Bolt”. A comparação é midiática e tecnicamente injusta — o humano se aquece, usa musculatura biológica otimizada por milhões de anos de evolução, e mantém 9,58s em condições de elite. O que importa é a curva de aprendizado do robô dentro de uma única competição: 9,39s → 8,86s → 8,64s. Isso é feedback loop de controle sendo ajustado em tempo real, não mágica.
O Tiangong Ultra foi desenvolvido pelo Beijing Humanoid Robot Innovation Centre, um consórcio que inclui empresas como UBTech e instituições acadêmicas chinesas. Diferente do que muita gente pensa, a China não está “imitando” Boston Dynamics — ela está atacando um problema diferente: robôs humanoides de baixo custo para escala industrial. O custo estimado do Tiangong gira em torno de US$ 300 mil, uma fração do que a Boston Dynamics cobra por um Atlas.
A pilha tecnológica por trás da corrida
Um humanoide competitivo em corrida de 100m precisa resolver, simultaneamente:
- Percepção em tempo real — fusão de IMU, encoders de junta e câmeras para entender pose, velocidade e orientação do tronco.
- Controle de equilíbrio dinâmico — controlador preditivo (MPC) ou aprendizado por reforço rodando a 100–1000 Hz para evitar queda em cada passada.
- Geração de trajetória de marcha — parâmetros de passada (cadência, comprimento de passo, altura do CoM) otimizados offline em simulação e refinados online.
- Gestão térmica e de bateria — motores de alta densidade de potência esquentam. Em 10 segundos isso ainda não é gargalo, mas em uma maratona seria.
- Comunicação de baixa latência — barramento CAN-FD ou EtherCAT entre CPU principal e os 30+ atuadores.
Cada uma dessas camadas tem anos de pesquisa por trás. Quando vejo o resultado final, o que me impressiona é que essas camadas foram integradas de forma robusta o suficiente para rodar em hardware real sem cair.
Embodied AI: o conceito que realmente importa (e que devs subestimam)
O artigo menciona “inteligência artificial incorporada” como destaque da competição. Na minha experiência trabalhando com LLMs e agentes autônomos, percebo que a maioria dos devs trata IA como algo que vive na nuvem — texto entra, texto sai. Embodied AI quebra essa abstração: o modelo tem que perceber o mundo físico e agir sobre ele com consequências irreversíveis.
Isso muda o jogo de várias formas:
- Latência importa de verdade. Um LLM pode demorar 2 segundos para responder. Um robô em corrida precisa decidir em milissegundos ou cai.
- Erros têm custo físico. Um alucinação de LLM é um texto estranho. Uma decisão errada de um controlador é uma junta travada ou um humano machucado.
- Treinamento exige simulação massiva. Você não pode treinar um humanoide por tentativa e erro no mundo real — quebra o robô. Sim-to-real transfer virou disciplina obrigatória.
- Generalização é o gargalo. Um LLM generaliza razoavelmente entre textos. Um controlador treinado para correr em pista lisa pode falhar em terreno irregular.
Comparação honesta: Tiangong vs. Optimus vs. Atlas vs. Figure 02
Como dev, não me interessa o hype de marketing. Me interessa o que cada plataforma entrega de fato:
| Robô | Foco | Velocidade de caminhada | Modelo de controle | Acesso ao código |
|---|---|---|---|---|
| Tiangong Ultra (China) | Esporte + indústria | ~12 km/h (100m em 8,64s ≈ 41 km/h?* inconsistente — fonte fala em corrida) | Provavelmente híbrido MPC + RL | Fechado |
| Atlas (Boston Dynamics) | Pesquisa + acrobacia | ~9 km/h em corrida controlada | Controle otimização + RL | Parcial (papers) |
| Optimus (Tesla) | Fábrica | ~8 km/h caminhada | End-to-end neural | Fechado |
| Figure 02 (Figure AI) | Trabalho doméstico | ~5 km/h | Helix (VLM + controle) | Fechado |
*Nota técnica: 100m em 8,64s implica ~41,7 km/h de velocidade média, o que seria absurdo para qualquer humanoide atual. Suspeito que o robô tenha caído no meio ou o número considere algum tipo de tempo de “reação” ou pista reduzida. Como o artigo não detalha, fica a ressalva. Em todo caso, o ponto é a progressão, não o valor absoluto.
O que diferencia o Tiangong nessa leva é o foco declarado em performance atlética como métrica de progresso. É marketing, mas também é uma escolha de design válida: corrida exige integração completa de todos os subsistemas.
Na Prática: o pipeline mínimo de um controlador de marcha baseado em RL
Como devs adoram ver código, vou mostrar a estrutura básica de um loop de treinamento que poderia estar por trás de um feito como esse. Não é o código real do Tiangong (esse é fechado), mas é a arquitetura canônica usada por times de pesquisa como ETH Zurich, NVIDIA e Google DeepMind.
import torch
import torch.nn as nn
from torch.distributions import Normal

class GaitPolicy(nn.Module):
    """
    Política de marcha: mapeia estado -> ação (torques nas juntas).
    Entrada: pose do tronco, velocidade, fase da passada, leituras de IMU.
    Saída: torques para 12 atuadores (6 por perna).
    """
    def __init__(self, obs_dim=48, act_dim=12, hidden=256):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(obs_dim, hidden),
            nn.ELU(),
            nn.Linear(hidden, hidden),
            nn.ELU(),
            nn.Linear(hidden, act_dim)
        )
        self.log_std = nn.Parameter(torch.zeros(act_dim) - 0.5)

    def forward(self, obs):
        mean = self.net(obs)
        std = self.log_std.exp().expand_as(mean)
        return Normal(mean, std)


def train_step(policy, env, optimizer, gamma=0.99, gae_lambda=0.95, clip=0.2):
    """
    PPO simplificado — o algoritmo padrão para locomoção humanóide.
    """
    obs = env.reset()
    log_probs, values, rewards, dones = [], [], [], []

    for step in range(2048):  # rollout
        obs_t = torch.tensor(obs, dtype=torch.float32)
        dist = policy(obs_t)
        action = dist.sample()
        log_prob = dist.log_prob(action).sum()

        next_obs, reward, done, info = env.step(action.detach().numpy())

        log_probs.append(log_prob)
        rewards.append(reward)
        dones.append(done)
        obs = next_obs
        if done:
            obs = env.reset()

    # Calcula vantagens com GAE
    advantages = compute_gae(rewards, values, dones, gamma, gae_lambda)
    returns = advantages + values

    # Loss PPO com clipping
    ratio = torch.exp(log_probs - log_probs.detach())
    surr1 = ratio * advantages
    surr2 = torch.clamp(ratio, 1 - clip, 1 + clip) * advantages
    policy_loss = -torch.min(surr1, surr2).mean()

    optimizer.zero_grad()
    policy_loss.backward()
    optimizer.step()

    return policy_loss.item()
Esse é o esqueleto. Em produção, você ainda adicionaria: parallelização com Isaac Gym (NVIDIA treina milhares de robôs em paralelo), domain randomization para robustez, encoder de histórico com LSTM ou Transformer para memória temporal, e um ciclo de sim-to-real com ajustes finos em hardware real. Esse último passo é onde está a verdadeira arte — e onde o Tiangong conseguiu evoluir 9,39s → 8,64s em poucas horas dentro de uma competição.
Erros Comuns: o que devs erram ao entrar em robótica
Depois de conversar com engenheiros migrando de web/IA tradicional para embodied AI, vejo padrões que se repetem:
- Esquecer que latência é uma feature, não otimização tardia. No mundo web você aceita 200ms de resposta. Em robótica, 50ms pode ser a diferença entre equilíbrio e queda. Decisões arquiteturais precisam considerar isso desde o dia 1.
- Treinar só em simulação e acreditar que vai funcionar. Sim-to-real gap é real. Quem ignora domain randomization e fine-tuning no hardware real vai descobrir no primeiro deploy.
- Subestimar o pipeline de dados de sensores. Uma IMU gera dados a 1kHz. Uma câmera stereo gera gigabytes por segundo. Sincronização e buffering não são problemas de “infra” — são problemas de produto.
- Escolher GPU errada para inferência em borda. Você não vai rodar um LLM de 70B no robô. Jetson Orin, Apple Silicon ou NPU dedicada importam mais do que o paper original sugere.
- Ignorar safety. Em software web, um bug é um erro 500. Em robótica, um bug é uma junta na velocidade errada a 2m de um humano. Safety-rated monitoring (como o usado em SIL2/SIL3) não é exagero.
- Confundir demo com produto. O Tiangong correu em pista controlada, sem público, com equipe de pit stop. Operação autônoma em ambiente não estruturado é outra história.
O que isso significa para quem programa hoje
Na minha opinião, embodied AI é a próxima onda de oportunidade para devs que hoje estão saturados de fazer CRUD com LLM wrapper. Os salários já estão subindo: um engenheiro de controle com experiência em RL para locomoção sai fácil por R$ 25–40k no Brasil em 2026, e mais de US$ 200k nos EUA.
Se você quer entrar, a rota mais rápida:
- Aprenda ROS 2 (não ROS 1, está em fim de vida).
- Domine Isaac Gym ou MuJoCo para simulação.
- Estude controle clássico (PID, LQR, MPC) antes de pular para RL.
- Contribua com um projeto open source de humanoide como o MuJoCo ou IsaacLab.
- Compre um Unitree Go2 ou G1 para testar em casa — os preços caíram absurdamente.
Não é hype. É uma mudança estrutural na indústria. Quando o hardware fica barato o suficiente (e o Tiangong mostra que está chegando lá), o software vira o gargalo — e quem escreve software são vocês.
Perguntas Frequentes
O Tiangong Ultra realmente é mais rápido que o Usain Bolt?
Tecnicamente, sim — o tempo registrado (8,64s) é menor que o recorde mundial humano (9,58s). Mas a comparação não é direta: o robô corre em condições controladas, sem vento, sem variação de temperatura, e com pista otimizada para sua passada. É como comparar um carro de F1 com um carro de rua em linha reta — número similar, contexto completamente diferente.
Esse robô usa inteligência artificial de verdade ou é só controle programado?
Provavelmente um híbrido. O planejamento de alto nível (decidir cadência, quando acelerar, quando recuperar equilíbrio) usa aprendizado por reforço e redes neurais. O controle de baixo nível (torque em cada motor a cada milissegundo) ainda depende muito de controladores clássicos como MPC. A tendência é substituir cada vez mais por end-to-end learning, mas hoje o estado da arte é híbrido.
Quanto custa um humanoide como esse?
Estimativas para o Tiangong Ultra giram em torno de US$ 300 mil. Para referência, o Tesla Optimus tem preço-alvo declarado de US$ 20–30 mil para produção em massa (ainda não atingido), e o Unitree G1 custa cerca de US$ 16 mil. A curva de preço está caindo rápido.
Posso treinar um humanoide em casa?
Não literalmente — você não tem espaço nem energia. Mas pode treinar um agente em simulação usando Isaac Gym ou MuJoCo rodando em uma GPU decente (RTX 4090 ou superior). O policy treinado pode depois ser transferido para um Unitree G1 físico com ajustes mínimos. É literalmente o workflow usado em pesquisa hoje.
Isso vai substituir humanos no trabalho?
Não em 2026. Os custos ainda são altos demais e a robustez em ambientes não estruturados é baixa. Mas em 5–10 anos, para tarefas repetitivas em ambiente controlado (logística, montagem simples), a substituição parcial é realista. Assim como aconteceu com braços robóticos industriais nas décadas de 80 e 90.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.