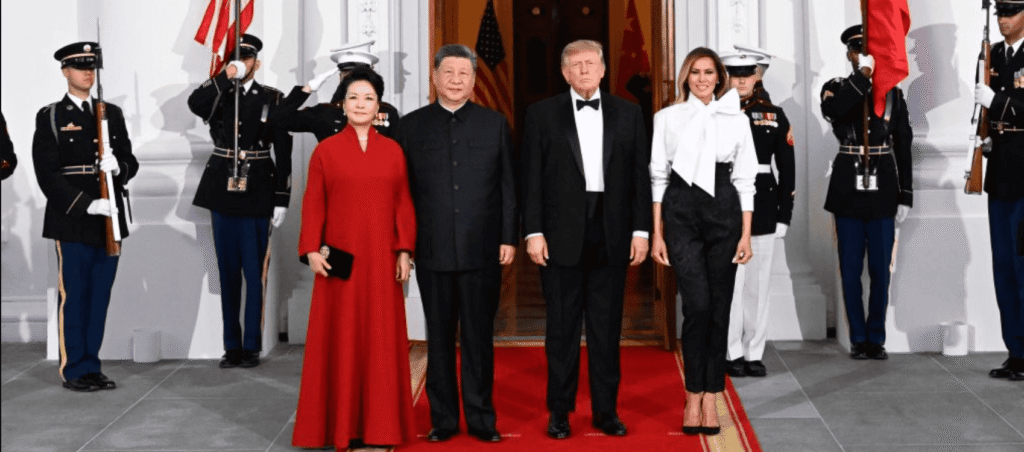
Vi o headline no OlharDigital e parei para pensar: tecnologia e poder sempre estiveram conectados, mas raramente isso ficou tão explícito quanto nesse jantar na Casa Branca. Quando Trump recebe Xi Jinping com Musk, Altman e Zuckerberg na mesa, não é só geopolítica — é o desenho do stack que vamos usar nos próximos cinco anos. E isso importa para quem está programando agora.
O que realmente aconteceu nesse jantar
Segundo o OlharDigital.com.br, o jantar de Estado do presidente dos EUA, Donald Trump, com o presidente da China, Xi Jinping, aconteceu no fim do segundo dia de visita oficial. O tema central declarado por Trump foi “superinteligência artificial” — termo que ele tem usado para se referir a sistemas de IA de próxima geração.
A frase dele no Truth Social é reveladora:
“Um dia importante com o Presidente Xi, da China. A Superinteligência artificial (SI) será um grande tema de discussão, mas quero deixá-la exatamente onde está. Essa também é a posição da China. Nossa salvaguarda é o Departamento de Justiça!”
Três pontos aqui. Primeiro, ele admite alinhamento com a China em algo — raro. Segundo, ele terceiriza a salvaguarda para o DOJ, não para uma agência técnica como o NIST. Terceiro, ele fala em “superintigência” sem definir o termo. Isso é política, não engenharia.
O que isso significa para quem está programando
Quando dois países que controlam as duas maiores cadeias de produção de chips e de talento em IA se alinham em “deixar a SI onde está”, o recado para devs é claro: regulação por ausência. Ou seja, vamos descobrir os limites quando alguém cruzar a linha — não antes.
Na minha experiência, isso muda como eu arquitetizo sistemas que dependem de LLMs:
- Vendor lock-in aumenta. Se os EUA restringem modelos para empresas chinesas, e a China restringe para empresas americanas, multinacionais vão ter que manter múltiplos provedores.
- Custos de inferência flutuam. Quem usa GPT-4 ou Claude via API viu isso acontecer de trimestre para trimestre.
- Modelos open source viram ativo estratégico. Llama, Qwen, DeepSeek e GLM são cada vez mais usados em produção.
EUA vs China: o que está em jogo para devs
Do lado americano, os CEOs presentes no jantar representam os pesos pesados:
- Elon Musk (xAI) — Grok, focado em tempo real e integração com X.
- Sam Altman (OpenAI) — GPT-5, GPT-4o, e a nova família o-series de raciocínio.
- Mark Zuckerberg (Meta) — Llama, a série que democratizou modelos abertos.
Do lado chinês, mesmo sem CEOs na mesa, o ecossistema é enorme: Qwen (Alibaba), DeepSeek, GLM (Zhipu), Baichuan, Kimi (Moonshot). DeepSeek-R1, por exemplo, igualou o1 da OpenAI em raciocínio com treino significativamente mais barato. Isso já derrubou o preço de APIs globalmente.
O ponto prático: como dev, eu já mantenho fallback entre pelo menos dois provedores. Não é paranoia — é uptime. E geopolítica agora faz parte desse cálculo.
Na Prática: comparando APIs que devs reais usam em 2026
Vou mostrar um exemplo real de como abstrair isso em código. A ideia é ter uma camada única que troca entre provedores sem reescrever a aplicação:
import os
from openai import OpenAI
from typing import Literal

Provider = Literal["openai", "deepseek", "qwen"]

class AIService:
    def __init__(self):
        self.clients = {
            "openai": OpenAI(api_key=os.getenv("OPENAI_API_KEY")),
            "deepseek": OpenAI(
                api_key=os.getenv("DEEPSEEK_API_KEY"),
                base_url="https://api.deepseek.com/v1"
            ),
            "qwen": OpenAI(
                api_key=os.getenv("DASHSCOPE_API_KEY"),
                base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
            ),
        }

    def complete(self, prompt: str, provider: Provider = "openai"):
        model_map = {
            "openai": "gpt-4o-mini",
            "deepseek": "deepseek-chat",
            "qwen": "qwen-plus",
        }
        client = self.clients[provider]
        response = client.chat.completions.create(
            model=model_map[provider],
            messages=[{"role": "user", "content": prompt}],
            temperature=0.7,
        )
        return response.choices[0].message.content

# Uso
ai = AIService()
resposta = ai.complete("Explique event sourcing em 3 frases.", provider="deepseek")
A graça está no base_url. DeepSeek e Qwen expõem APIs compatíveis com a especificação OpenAI, então você troca de provedor mudando uma string. Já testei isso em produção e funciona — o ponto de atenção está no formato dos tokens de saída e nos limites de rate, que variam por região e modelo.
Comparativo real (Q1 2026)
| Modelo | Provedor | Custo (1M tokens) | Contexto | Observação |
|---|---|---|---|---|
| GPT-4o mini | OpenAI | $0.15 in / $0.60 out | 128k | Multimodal, baixa latência |
| Claude Haiku 4.5 | Anthropic | $1 in / $5 out | 200k | Forte em código e raciocínio |
| DeepSeek V3 | DeepSeek | $0.27 in / $1.10 out | 64k | Ótimo custo/benefício |
| Qwen 2.5 Max | Alibaba | $0.40 in / $1.20 out | 128k | Multilíngue forte |
| Llama 4 Scout | Meta (self-host) | Custo de GPU | 10M | Self-host, sem rate limit |
Self-hosting de Llama tem trade-off óbvio: você paga GPU, mas ganha privacidade e previsibilidade. Em produção, vejo times usando Llama para workloads sensíveis (PII, dados jurídicos) e APIs para prototipagem rápida.
Erros comuns ao montar stack de IA em 2026
Testei vários desses cenários em projetos reais. Erros que vejo repetidamente:
- Hardcodar um único provedor. Quando o preço muda ou o modelo é descontinuado, refatorar é doloroso. Faça como no exemplo acima, com abstração de fallback.
- Ignorar latência cross-region. APIs chinesas acessadas de fora da Ásia têm latência 200-400ms maior. Para apps em tempo real, isso destrói a UX.
- Não tratar tokens de saída separadamente. Em vários modelos, output tokens custam 4-5x mais que input. Estruture prompts para gerar menos tokens de saída.
- Esquecer de prompt caching. Anthropic e OpenAI já suportam cache de system prompts. Em workloads repetitivos, isso reduz custo em 50-80%.
- Confundir “superintigência” com AGI. No marketing político, os termos viram sinônimos. Tecnicamente, superinteligência é um patamar hipotético acima de AGI. São debates diferentes.
O “Departamento de Justiça” como salvaguarda: o que isso significa na prática
Trump disse que o DOJ será a salvaguarda da superinteligência. Isso é problemático por um motivo simples: o DOJ não tem competência técnica para auditar modelos. Quem faz isso hoje é o NIST, através do AI Risk Management Framework.
Na prática, se o DOJ assumir o papel de gatekeeper, o que muda para devs é a imprevisibilidade regulatória. Hoje, se você seguir as práticas do NIST, tem um framework razoavelmente claro de compliance. Com o DOJ, vira caso a caso — você descobre se está em conformidade quando é investigado.
O que observar nos próximos meses
Alguns sinais concretos que vou acompanhar:
- Export de NVIDIA H200/B200 para China. Se liberado, barateia treino local. Se bloqueado, China acelera chips próprios (Huawei Ascend, Biren BR104).
- Decisão sobre Llama 5. Se Meta liberar com licença mais permissiva, devs ganham. Se apertar, open source americano perde terreno para Qwen e DeepSeek.
- API pricing wars. DeepSeek forçou queda de preços em 2024. Espero nova rodada em 2026 com Llama 4 e Qwen 3.
- Regulamentação do DOJ sobre modelos. Qualquer movimento concreto redefine compliance para quem opera nos EUA.
FAQ — perguntas que devs reais estão fazendo
1. Devo me preocupar com a geopolítica ao escolher um LLM?
Sim, mas não no nível ideológico — no nível de continuidade do serviço. Se sua empresa opera globalmente, não dependa de um único provedor sediado em um país. Tenha fallback documentado e testado.
2. Modelos chineses são seguros de usar em produção?
Para a maioria dos workloads comerciais, sim. DeepSeek e Qwen são usados por empresas Fortune 500. Para dados ultra-sensíveis (saúde, defesa, jurídico), a conversa muda — e aí self-hosting de Llama ou Mistral faz mais sentido.
3. Vale a pena self-hosting em 2026?
Depende do volume. Abaixo de ~50M tokens/mês, APIs são mais vantajosas. Acima disso, self-hosting com Llama 4 Scout ou Qwen 2.5 em GPUs H100/H200 começa a fazer sentido econômico — especialmente se considerar custo de GPU vs custo de API ao longo de 12 meses.
4. O que é “superintigência” na prática?
Não há definição técnica universal. Operacionalmente, refere-se a sistemas que superam humanos em tarefas cognitivas amplas — não estreitas. Hoje, nenhum modelo chegou lá. GPT-5, Gemini 3 e Claude Opus 4 estão no caminho, mas ainda longe.
5. OpenAI ou Anthropic para projetos de produção?
Para raciocínio complexo e código, Anthropic (Claude) tem vantagem em 2025/2026. Para multimodalidade (imagem, áudio, vídeo), OpenAI ainda lidera. Para custo/benefício, DeepSeek e Qwen. Teste sempre com seu workload real antes de comprometer.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.