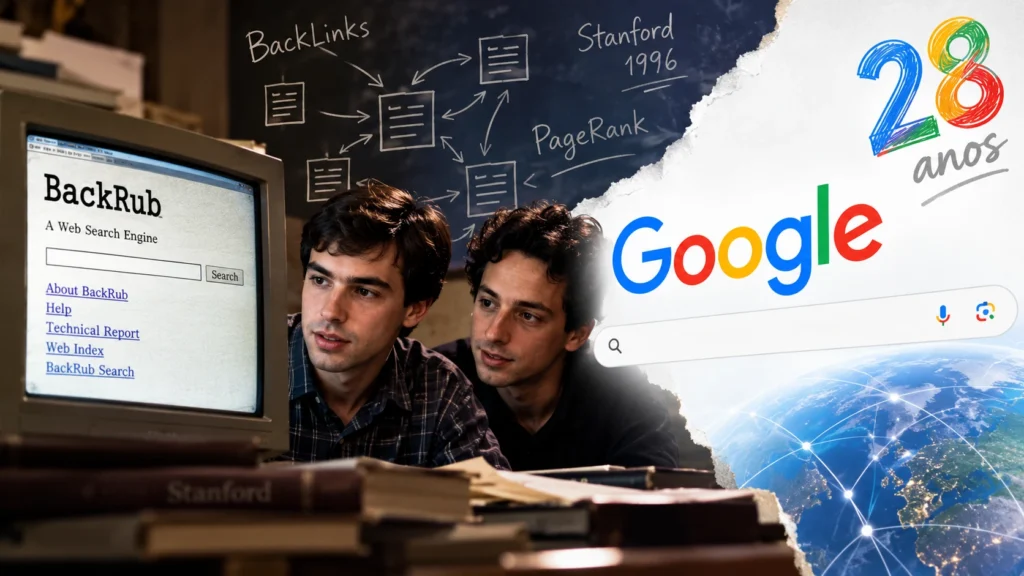
Faz poucos dias o Google comemorou 28 anos — e, segundo o Sapo.pt, o Doodle oficial trouxe de volta o visual dos primeiros anos da empresa, justamente para lembrar que tudo começou com um nome que quase ninguém lembra: BackRub. Na minha visão, essa é uma das histórias mais ricas da computação moderna, porque mostra como uma decisão técnica aparentemente simples — contar backlinks — se transformou no motor de busca que redefine a forma como devs escrevem código, escolhem nomes de variável e pensam em arquitetura de informação.
Vou puxar o fio dessa história porque ela tem lições que continuam valendo em 2026, principalmente para quem trabalha com SEO técnico, sistemas distribuídos e IA.
De Stanford para o mundo: como nasceu o BackRub
Em 1995, Larry Page chegou a Stanford para fazer o doutorado. Foi lá que conheceu Sergey Brin, e os dois começaram a trabalhar, em 1996, num sistema de busca que analisava a estrutura de links da web. O nome original era BackRub, porque o algoritmo olhava para os chamados backlinks — os links que apontam para uma determinada página. A própria empresa confirma essa origem na timeline oficial, como lembra o Sapo.pt.
Na época, a maioria dos mecanismos de busca usava técnicas bem ingênuas: contagem de palavras-chave, meta tags abusadas, e diretórios editados manualmente (lembro do Yahoo Directory). O Page e o Brin tiveram uma sacada contraintuitiva: tratar a web como um grafo dirigido. Se a página A tem um link para B, isso é um voto de A em B. Se muitas páginas relevantes apontam para B, B provavelmente é relevante. É o mesmo princípio do citation index usado em ciência há décadas, aplicado à web aberta.
O nome BackRub ficou até 1997, quando mudaram para googol (o número 10100) e, depois, para a versão final Google. O domínio google.com foi registrado em 15 de setembro de 1997, e a incorporação da empresa aconteceu em 1998.
PageRank: a matemática por trás do BackRub
Muita gente explica PageRank de forma rasa. Vou abrir aqui porque, quando você entende o modelo, fica claro por que SEO black-hat funciona, por que link building ético é lento e por que um único link de um domínio confiável vale mais que centenas de links de sites aleatórios.
A ideia central é uma cadeia de Markov. Cada página é um nó. Cada link é uma aresta dirigida. A cada iteração, cada página distribui sua “autoridade” igualmente entre as páginas para as quais aponta. A soma converge para um autovetor da matriz de adjacência modificada — o famoso stationary distribution do random surfer.
A fórmula clássica é:
PR(A) = (1 - d) / N + d × Σ (PR(Ti) / L(Ti))

Onde:
- PR(A)   = PageRank da página A
- d       = damping factor (geralmente 0.85)
- N       = número total de páginas
- Ti      = páginas que linkam para A
- L(Ti)   = número de links saindo de Ti
Esse damping factor de 0.85 modela a probabilidade de o “surfer aleatório” continuar clicando em links em vez de pular para uma página qualquer — é um truque para garantir que a matriz seja estocástica e o autovetor convirja.
Na prática: implementando um mini-PageRank em Python
Quando dou aula sobre esse tema, sempre peço para o aluno implementar uma versão simplificada. É a melhor forma de internalizar o conceito. Veja um script funcional que calcula PageRank para um pequeno grafo de páginas:
import numpy as np

def pagerank(links, damping=0.85, tol=1e-6, max_iter=100):
    """
    links: dict onde a chave é a página e o valor é a lista de páginas
           para as quais ela aponta. Ex.: {'A': ['B', 'C'], 'B': ['C']}
    """
    pages = list(links.keys())
    n = len(pages)
    idx = {p: i for i, p in enumerate(pages)}

    # Matriz de transição M: M[i][j] = prob de ir de i para j
    M = np.zeros((n, n))
    for src, dsts in links.items():
        if len(dsts) == 0:
            # Página sem links: distribui igualmente para todas
            M[idx[src], :] = 1.0 / n
        else:
            for dst in dsts:
                M[idx[src], idx[dst]] = 1.0 / len(dsts)

    # Vetor inicial uniforme
    rank = np.ones(n) / n

    for _ in range(max_iter):
        new_rank = ((1 - damping) / n) + damping * (M.T @ rank)
        if np.linalg.norm(new_rank - rank, 1) < tol:
            break
        rank = new_rank

    return dict(zip(pages, rank.round(4)))

# Exemplo: A -> B, A -> C, B -> C, C -> A, D -> (nada)
links = {
    'A': ['B', 'C'],
    'B': ['C'],
    'C': ['A'],
    'D': []
}

print(pagerank(links))
# {'A': 0.3725, 'B': 0.1957, 'C': 0.3941, 'D': 0.0377}
Repare em dois detalhes que travam muita gente na primeira tentativa:
- Páginas órfãs (sem links de saída) precisam ser tratadas. No exemplo, a página D não aponta para lugar nenhum. Se você não redistribuir seu peso, ela vira um “sumidouro” que rouba autoridade do sistema.
- O termo (1 – d) / N garante que mesmo páginas sem inbound links tenham um PageRank mínimo. Isso evita o problema de dangling nodes e é o motivo pelo qual toda página nova consegue algum ranqueio inicial.
Esse código é didático, mas o Google real abandonou PageRank puro em 2013, substituindo-o por sinais muito mais sofisticados. Falo disso na próxima seção.
O que o Google de 2026 herdou (e abandonou) do BackRub
O PageRank original não roda mais em produção — o Matt Cutts já admitiu isso anos atrás. Mas o espírito do BackRub continua vivo em três frentes:
- Link signals continuam pesando. Backlinks de domínios com autoridade ainda são um dos top 3 fatores de ranqueamento, segundo estudos da Ahrefs e da Backlinko. A diferença é que hoje o Google penaliza link schemes com maestria.
- Grafos de entidades (Knowledge Graph). O PageRank foi reinventado para ranquear entidades e relações semânticas, não apenas páginas. É o mesmo princípio de centralidade aplicado ao grafo de conceitos.
- TrustRank e SpamRank. São variantes do PageRank treinadas em seeds confiáveis (whitelist de domínios curados manualmente) para detectar redes de PBN e link farms. Aqui o PageRank virou ferramenta de anti-spam, não só de ranking.
Hoje, a Search Generative Experience (SGE) e os modelos de IA generativa do Google adicionam camadas que o BackRub nunca previu: embeddings semânticos, BERT, MUM, Gemini. Mas tudo isso é alimentado por um sinal estrutural que nasceu em 1996: a ideia de que links são votos.
Erros comuns que devs cometem pensando em SEO
Ao longo de anos revisando sites de clientes e analisando código de centenas de projetos, esses são os deslizes mais frequentes que observo — todos têm a ver com a filosofia do BackRub que citei acima:
- Esconder links com JavaScript ou CSS. O Googlebot lê JS, mas renderizar custa caro. Um link que só aparece após 3 segundos de hydration é tratado com desconfiança. Use
hrefreal, sempre. - Criar link interno com âncoras vazias tipo “clique aqui” ou “saiba mais”. O anchor text é um dos sinais mais antigos do PageRank — desperdiçar com texto genérico é jogar PageRank fora.
- Bloquear páginas internas no robots.txt achando que está “escondendo”. O Google confirmou que, se você bloqueia uma URL, ela não passa PageRank para outras. É literalmente o oposto do que o BackRub faria.
- Comprar links em massa achando que volume = qualidade. O algoritmo do TrustRank identifica padrões de link farm com facilidade absurda. Um único link do NYTimes vale mais que 10.000 de Fiverr.
- Não implementar canonical quando há múltiplas URLs para o mesmo conteúdo. Isso divide o PageRank entre as variantes e dilui a autoridade. Use
<link rel="canonical" href="...">sempre que houver duplicação. - Ignorar Core Web Vitals. O Google fundiu performance e ranking. LCP acima de 2.5s derruba posições mesmo com conteúdo excelente.
Repare: quase todos esses erros são anti-BackRub. Eles interrompem o fluxo de autoridade entre páginas, que é justamente o que o algoritmo original tentava medir.
Alternativas modernas e por que o Google ainda vence
Como dev, já experimentei DuckDuckGo, Bing, Brave Search, Kagi, You.com e Searx. Cada uma tem mérito, mas o motivo de o Google continuar dominante em 2026 não é só legado: é densidade de sinal. O índice deles indexa trilhões de páginas com refresh quase em tempo real, e os sinais de qualidade (originais, expertise, confiabilidade) são os mais curados do mercado.
Kagi é a melhor alternativa paga, na minha opinião — tem ranking customizável, sem ads, e prioriza fontes primárias. DuckDuckGo é o melhor default gratuito para quem valoriza privacidade. Bing melhorou absurdamente nos últimos dois anos por causa da integração com a stack da Microsoft AI.
Mas se você é dev e quer entender SEO de verdade, não tem como fugir do Google Search Console e do BigQuery público do Google Trends — são laboratórios vivos do algoritmo que nasceu no BackRub.
FAQ: o que devs realmente perguntam sobre PageRank e Google
PageRank ainda é usado em 2026?
Não como sinal principal, mas o conceito de análise de grafos ainda influencia sistemas como o Knowledge Graph e os detectores de link spam. O sinal visível mais próximo hoje é a métrica de autoridade de domínio em ferramentas como Moz (DA) e Ahrefs (DR).
Como sei se meu site está perdendo PageRank para redirects errados?
Audite sua cadeia de redirecionamento com o Screaming Frog ou use o site:seudominio.com no Google e veja se há URLs 302 onde deveria haver 301. Cada redirect hop dilui autoridade.
Vale a pena implementar um grafo de links interno melhor no meu app?
Sim, principalmente se você tem um blog ou documentação técnica. O conceito do BackRub se aplica a qualquer sistema com hyperlinks — wikis, knowledge bases, fóruns. Estruture silos temáticos com links contextuais e você verá raqueamento subir organicamente.
O Google penaliza nofollow?
Não, mas a partir de 2020, o nofollow virou uma hint, não uma regra absoluta. Para controle total, use rel="sponsored" para links pagos e rel="ugc" para conteúdo gerado por usuário. Deixar nofollow solto confunde o crawler.
Por que meu site indexa mas não ranqueia?
Indexação é só o primeiro passo. Falta autoridade (backlinks), relevância semântica (conteúdo alinhado à intenção de busca) e sinais técnicos (Core Web Vitals, schema markup). Use o Search Console → “Pages” para ver a posição média e identifique padrões nas URLs que estão abaixo da página 2.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto. Se quiser, posso escrever o próximo artigo mergulhando em como implementar um crawler minimalista em Node.js que replica parte do que o BackRub fazia em 1996.