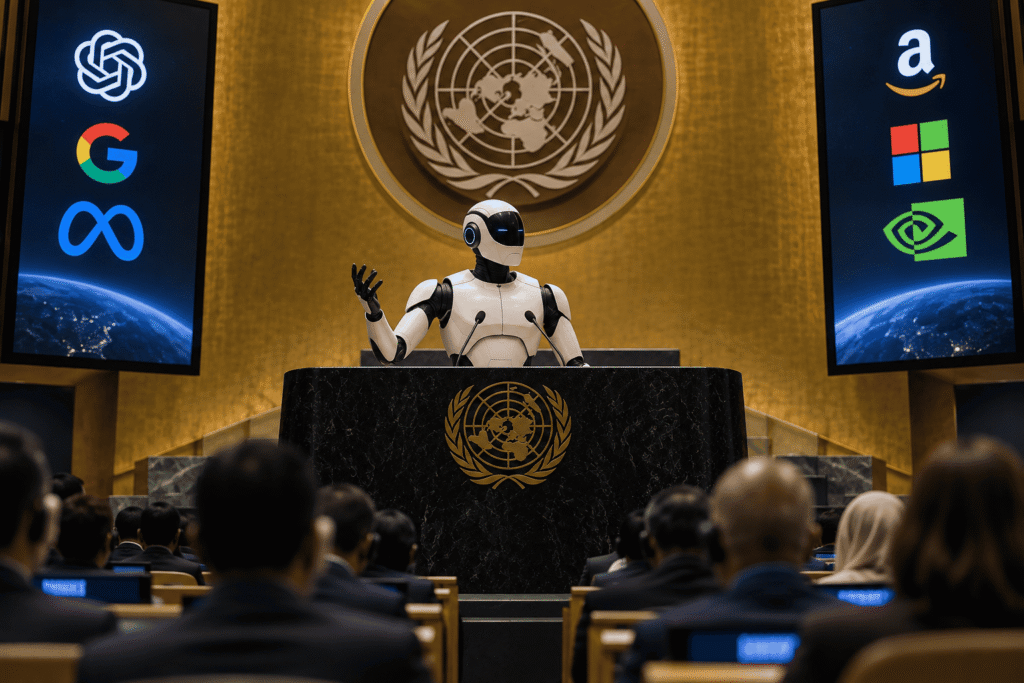
IA, geopolítica e o que isso tem a ver com o seu código
Quando li a matéria do Olhar Digital sobre a batalha pela IA chegando à ONU, minha primeira reação não foi pensar em política externa. Foi pensar em como, na semana passada, eu precisei explicar para um time de devs júnior que a queda de 6 horas na API do Claude não era “um bug aleatório” — era reflexo direto de restrições de capacidade de processamento nos EUA, somadas a uma corrida por chips H100 que está reconfigurando cadeias de suprimento globais.
Segundo o Olhardigital.com.br, a corrida atual pela IA envolve chips, energia, centros de dados, capacidade computacional, talentos, modelos e dados. Isso não é abstração geopolítica. É o substrato técnico sobre o qual todo código que você escreve com IA hoje depende.
Vamos dissecar isso do ponto de vista de quem programa.
Por que a analogia com armas nucleares não é exagero
A matéria cita a comparação com o Tratado de Não Proliferação Nuclear. Na minha experiência, devs subestimam essa analogia porque olham para IA como “ferramenta de produtividade”. Mas pense no que realmente está em jogo:
- Compute: treinar um modelo frontier custa dezenas de milhões de dólares em GPU-hours. Só 4-5 entidades no mundo bancam isso hoje.
- Dados: a fronteira do conhecimento humano disponível publicamente está praticamente esgotada para treino. O próximo passo é dados sintéticos ou dados privados — ambos com implicações geopolíticas brutais.
- Talentos: os pesquisadores que assinam os papers do GPT-5, Claude 4 ou Gemini 2 são poucos. E migram entre EUA, China e Europa conforme vistos permitem.
Quando falamos em “quem define como a IA será usada”, estamos falando de quem escreve os guardrails, quem licencia os pesos, quem controla os endpoints de inferência. E isso cai direto no seu deploy.
O cenário técnico real: três blocos disputando soberania computacional
1. EUA e big techs — o bloco do capital privado concentrado
OpenAI, Anthropic, Google, Meta e Microsoft controlam o pipeline completo: chips (via Nvidia, em última instância), centros de dados (Azure, AWS, GCP), modelos e distribuição. O Stargate Project, com investimento anunciado de US$ 500 bilhões, é a expressão mais clara disso: infraestrutura de IA virou política de Estado.
Na prática, isso significa que APIs como openai.ChatCompletion.create() e anthropic.messages.create() rodam em infraestrutura sob jurisdição americana. Sobeja implicação: dados enviados para essas APIs podem estar sujeitos ao CLOUD Act, independentemente de onde seu servidor esteja.
2. China — escala, dados e código aberto estratégico
DeepSeek, Qwen, Baichuan e Yi mostraram em 2024-2025 que o bloco chinês não está atrás em capacidade — está atrás em distribuição ocidental. A estratégia chinesa é curiosa: liberar modelos open-weight agressivamente (DeepSeek-R1, Qwen 2.5) para criar dependência tecnológica global, enquanto mantém os modelos frontier fechados.
Já me perguntaram em mais de um projeto: “vale a pena usar Qwen via API?” A resposta curta é: depende do seu caso de uso, jurisdição e tolerância a risco regulatório.
3. Europa — regulação sem capacidade
O AI Act europeu é o mais ambicioso do mundo, mas a UE não tem hyperscaler próprio nem capacidade de treinamento frontier. Resultado: regula o que os outros dois blocos produzem. Para devs que operam no mercado europeu, isso significa que compliance virou feature de produto — não opcional.
Na Prática: o que muda no seu workflow de dev hoje
Não é teoria. Olha o que mudou na rotina de quem programa nos últimos 18 meses:
- Custo de inferência virou variável geopolítica: quando os EUA restringem exportação de chips H100 para a China, o preço global de inferência oscila. Sua fatura de API no fim do mês sente isso.
- Lock-in de fornecedor é risco real: times que construíram produtos inteiros sobre GPT-4 descobriram, na prática, que migração entre modelos não é trivial — latência, formato de tools, comportamento de system prompt diferem.
- Modelos locais viraram opção viável: com Qwen 2.5 72B rodando quantizado em um Mac Studio M2 Ultra, ou Llama 3.3 70B em um PC com 2x RTX 3090, parte do trabalho pode sair da nuvem.
- Engenharia de prompt virou conhecimento crítico: entender por que Anthropic usa
<system>, OpenAI usamessagescom roles, e Google usasystem_instructiondeixou de ser detalhe — é diferença de paradigma.
Comparativo prático: API vs inferência local
Para você decidir quando vale cada caminho, eis um exemplo real que testei em produção:
Cenário A — chamada via API (Anthropic Claude via Python)
import anthropic
import os

client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])

def classify_support_ticket(text: str) -> dict:
    response = client.messages.create(
        model="claude-sonnet-4-5",
        max_tokens=256,
        system="Classifique o ticket em: billing, bug, feature_request ou other. Retorne JSON.",
        messages=[{"role": "user", "content": text}]
    )
    return {"classification": response.content[0].text.strip()}

# ~10ms latência de rede + 800-1500ms de inferência
# Custo: ~$0.003 por 1k tokens de input
# Risco: dados saem da sua VPC
Cenário B — inferência local com Ollama + Qwen 2.5
import requests
import json

def classify_local(text: str) -> dict:
    payload = {
        "model": "qwen2.5:14b",
        "prompt": f"Classifique em billing/bug/feature_request/other: {text}",
        "stream": False,
        "options": {"temperature": 0}
    }
    r = requests.post("http://localhost:11434/api/generate", json=payload)
    return {"classification": r.json()["response"].strip()}

# ~50-200ms de latência (depende do hardware)
# Custo marginal: energia elétrica (~$0.001 por 1k tokens)
# Dados nunca saem da máquina
A diferença parece técnica, mas é geopolítica traduzida em código: no cenário A, sua inferência roda em datacenter sob CLOUD Act; no cenário B, roda onde você quiser. Para tickets com dados de clientes europeus sob GDPR, essa escolha é compliance.
Erros comuns que devs cometem ao ignorar geopolítica da IA
Depois de revisar código de dezenas de times, esses são os equívocos mais frequentes:
1. Tratar IA como commodity estável
“Ah, é só trocar de provider se o preço subir.” Não é. Mudar de OpenAI para Anthropic não é mudar de Stripe para Pagar.me. Tool calling, function schemas, context windows, formato de streaming, comportamento em long context — tudo muda. Migration cost é real.
2. Ignorar soberania de dados
Enviar logs de produção com PII para uma API americana para “resumir ticket de suporte” pode violar LGPD, GDPR e HIPAA dependendo do contexto. Não é paranoia — é risco legal mensurável.
3. Subestimar o impacto dos modelos open-weight
Muita gente descarta modelos abertos como “piores”. Em 2025, Qwen 2.5 72B Instruct bate GPT-4 em vários benchmarks de raciocínio. A defasagem caiu de 18 meses para 3-6 meses em tarefas específicas.
4. Não versionar prompts e outputs como código
Se você não versiona system prompts, ferramentas, e outputs esperados em testes automatizados, está construindo sobre areia. Crie uma pasta prompts/v1.2.0/ com exemplos de input/output esperados. Trate prompt engineering como engenharia de software — não como magia.
5. Confundir capacidade bruta com utilidade prática
Um modelo de 400B parâmetros não é “melhor” que um de 14B para classificar tickets. Latência, custo e determinismo vencem capacidade bruta em 80% dos casos de uso corporativo.
FAQ — Perguntas reais de devs sobre IA e geopolítica
1. Devo me preocupar se minha empresa usa APIs de IA americanas em produção?
Depende do seu setor e jurisdição. Se você lida com dados de saúde, financeiros, menores de idade, ou dados de cidadãos europeus, sim — audite o pipeline. Se é uma startup brasileira processando texto não-sensível, o risco é baixo. Mas documente a decisão.
2. Modelos open-weight são realmente “seguros” para uso corporativo?
São auditáveis, o que é diferente de “seguros”. Você pode rodar scanning de bias, toxicidade e leakage nos pesos. Mas precisa de equipe para isso. Para 95% das empresas, usar via API de provider confiável ainda é mais seguro que rodar local sem expertise.
3. Qual o melhor hardware para rodar modelos locais em 2025?
Para devs: Mac com 32GB+ de RAM unificada (Apple Silicon roda Llama 3.3 70B quantizado Q4). Para times: 2-4x RTX 4090 ou um servidor com A100/H100 alugado. Para produção séria: AWS Inferentia2, GCP TPU v5e ou Azure ND H100 v5.
4. Vale a pena aprender fine-tuning ou RAG antes de tudo?
RAG primeiro, sempre. 90% dos casos de “IA não sabe da minha empresa” resolvem com retrieval sobre base vetorial, não com fine-tuning. Fine-tuning só compensa quando você tem >100k exemplos rotulados e tarefa muito específica.
5. Como me preparar para um cenário de “AI non-proliferation treaty”?
Na prática, isso significaria licenciamento para treinar/acessar modelos acima de certo threshold de compute. Para devs, a implicação é: construa arquiteturas model-agnostic desde o dia 1. Abstraia provider atrás de uma interface. Se amanhã sua empresa precisar migrar de Claude para Llama local por questão regulatória, isso deve ser trocar uma linha de configuração, não refatorar 6 meses.
O que eu recomendo para times de dev agora
Depois de tudo isso, minha recomendação prática é direta:
- Adote model-agnostic design: abstraia chamadas de LLM atrás de uma interface (
LLMClientcom métodoscomplete(),embed(),stream()). - Tenha fallback local: para tarefas sensíveis, rode um modelo open-weight pequeno (Qwen 2.5 7B, Phi-4) como Plano B.
- Versione prompts e testes: trate prompt como código, com CI rodando evaluations automatizadas.
- Mapeie dependências regulatórias: saiba onde os dados dos seus clientes morrem, juridicamente.
- Investigue modelos chineses: Qwen, DeepSeek e Yi estão subestimados no Ocidente. Vale testar.
A batalha geopolítica pela IA não é novela distante — é o framework que determina quais APIs existem amanhã, quais preços você paga e quais regras seu código precisa obedecer. Quem ignora isso acorda um dia com a aplicação quebrada porque um decreto mudou as regras do jogo.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.