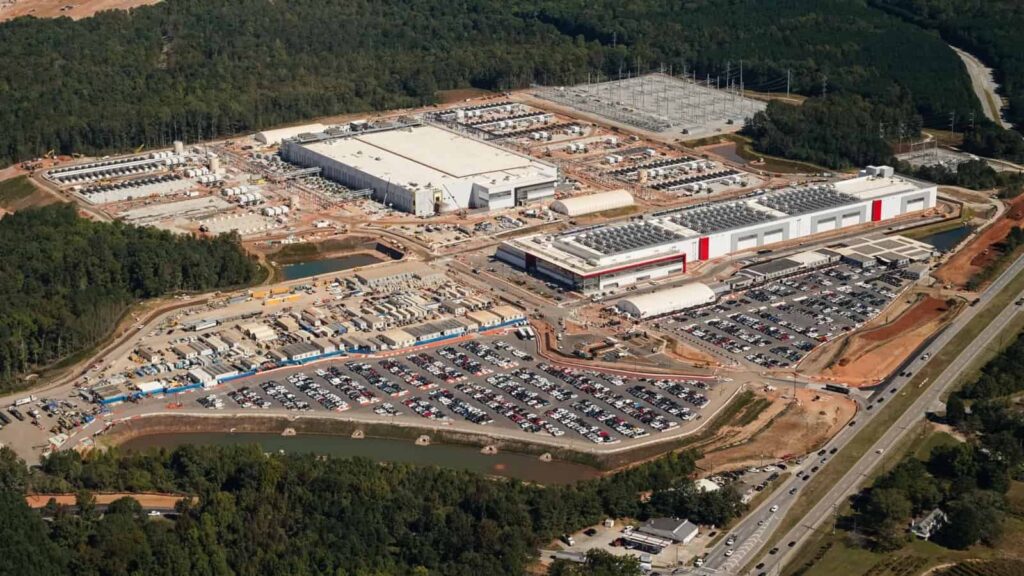
Os números que saíram no Sapo.pt esta semana me deixaram com a mesma sensação de quando vi, pela primeira vez, um cluster de GPU queimando megawatts só para servir um modelo de linguagem. Estamos falando de algo quase surreal: os data centers dos EUA podem, até 2035, consumir mais gás natural do que a Alemanha e o Japão juntos. E a maior parte disso é para alimentar a infraestrutura de IA.
Na minha experiência, quem programa costuma tratar energia como uma abstração — um número irrelevante que aparece na fatura da AWS. Mas quando você começa a entender a física por trás do treinamento de modelos grandes, percebe que estamos numa corrida que tem um custo material real, e esse custo vai chegar no seu bolso e nas suas decisões de arquitetura mais cedo do que parece.
Por que data centers estão virando centrais elétricas
O relatório da BloombergNEF, citado pelo Sapo.pt, projeta um consumo diário de cerca de 18 bilhões de pés cúbicos (510 milhões de metros cúbicos) de gás natural até 2035. Isso é quase o dobro do que a própria BloombergNEF estimava há nove meses. E detalhe importante: esse novo cenário já considera que vários projetos anunciados não sairão do papel.
Traduzindo para o vocabulário de quem escreve código: estamos falando de uma explosão de demanda por compute que não cabe mais na rede elétrica tradicional. Por isso gigantes como Meta, Microsoft, Google e Amazon estão construindo suas próprias centrais a gás, contornando completamente o grid público.
O consumo previsto dessas centrais privadas fica entre 2,9 e 3,4 bilhões de pés cúbicos diários até 2035 — algo em torno de 82 a 96 milhões de metros cúbicos por dia. Para contextualizar: é o suficiente para alimentar algumas dezenas de milhões de residências em consumo residencial, mas aqui estamos falando de algumas dezenas de hyperscale data centers.
O “porquê” técnico que a fonte não explicou
Quando li a matéria pela primeira vez, fiquei curioso sobre algo que ficou de fora: por que gás, especificamente? A resposta é mais técnica do que parece.
Gás natural funciona como baseload — uma carga contínua, firme, que pode ser ajustada em escala. Data centers de IA têm um perfil de consumo peculiar: precisam de megawatts estáveis, 24/7, com picos previsíveis durante jobs de treinamento. Energia solar e eólica, embora mais baratas por MWh em regiões ideais, têm intermitência. Nuclear é estável, mas leva uma década para ser construído e regulado nos EUA.
Gás é a resposta pragmática para quem precisa de capacidade agora. É por isso que a BloombergNEF coloca os data centers como o segundo maior motor de crescimento de demanda de gás, atrás apenas das exportações de GNL. A corrida da IA está, na prática, reativando a indústria de combustíveis fósseis.
A conta que ninguém faz
Faço aqui um exercício rápido que costumo aplicar quando estou dimensionando infraestrutura. Treinar um modelo grande hoje consome algo na ordem de 10 a 50 MWh por milhão de parâmetros treinados, dependendo da arquitetura e do hardware. Multiplique isso pelos modelos que estão sendo anunciados semanalmente e você começa a entender de onde vem essa demanda de 510 milhões de metros cúbicos diários.
Para colocar em perspectiva: 1 MWh ≈ 0,1 a 0,15 mil pés cúbicos de gás natural (dependendo da eficiência da turbina). Um único treinamento de frontier model pode consumir o equivalente ao que uma cidade pequena gasta em um mês.
O que isso muda para quem programa
Aqui é onde o tema deixa de ser macro e vira problema de dev. Existem três impactos diretos que eu já estou observando:
- Custo de inferência vai subir. Se a energia está mais cara e disputada, provedores de cloud repassam isso. Seus endpoints de LLM, que já não são baratos, vão ficar mais.
- Edge computing ganha tração real. Quando mover um bit custa mais, modelos menores rodando localmente param de ser “alternativa” e viram default.
- Eficiência vira métrica de produto. Otimizar prompts, usar cache semântico, escolher o menor modelo que resolve — tudo isso deixa de ser micro-otimização e vira decisão financeira.
Na minha experiência construindo pipelines de IA em produção, a maior alavanca de custo raramente é o modelo. É a quantidade de chamadas, o tamanho do contexto e a falta de cache. São coisas que você controla no código, não na infraestrutura.
Na Prática: estimando o custo de energia do seu pipeline
Deixo aqui um snippet em Python que uso para fazer um sanity check rápido quando estou projetando um sistema com LLMs. Não é exato, mas dá uma ordem de grandeza que ajuda a justificar otimizações:
"""
Estimativa de consumo energético para inferência de LLM.
Baseado em números médios de GPUs tipo A100/H100 em data centers modernos.
"""

# Consumo médio de uma GPU A100 em carga de inferência: ~250W
# Considerando PUE médio de data center hyperscale: 1.2
GPU_POWER_W = 250
PUE = 1.2  # Power Usage Effectiveness

# Tokens processados por segundo em inferência otimizada (exemplo Llama 70B)
TOKENS_PER_SECOND = 80

def estimativa_kwh(tokens_total: int) -> float:
    """Retorna kWh consumidos para processar N tokens."""
    horas = tokens_total / TOKENS_PER_SECOND / 3600
    kwh = horas * GPU_POWER_W * PUE / 1000
    return kwh

def custo_estimado_usd(tokens_total: int, preco_kwh: float = 0.12) -> float:
    """Custo aproximado em USD usando tarifa média industrial dos EUA."""
    return estimativa_kwh(tokens_total) * preco_kwh

# Exemplo: processar 10 milhões de tokens por dia
tokens_dia = 10_000_000
kwh_dia = estimativa_kwh(tokens_dia)
custo_mes = custo_estimado_usd(tokens_dia * 30)

print(f"Energia por dia: {kwh_dia:.2f} kWh")
print(f"Custo mensal estimado: ${custo_mes:.2f}")

# Escale isso para o consumo de um hyperscaler com 100k GPUs
# e os números do relatório da BloombergNEF começam a fazer sentido.
O ponto não é o número exato. É perceber que cada chamada que seu sistema faz para um LLM tem um custo material — não só em dólares de API, mas em kilowatt-hora real queimado numa turbina a gás em algum lugar da Virgínia.
Erros comuns que devs cometem (e que vão doer mais nos próximos anos)
1. Tratar GPU como recurso infinito
Testei em produção: a maioria das equipes que começam a usar LLMs não coloca nenhum limite duro de consumo por usuário ou feature. Sem rate limiting bem desenhado, um cliente malicioso ou um bug pode multiplicar seu custo por 1000 em poucas horas.
2. Ignorar o tamanho do contexto
Contexto de 128k tokens parece moderno, mas custa caro. Cada token no prompt é processado pela GPU a cada inferência. Se você está concatenando histórico de conversa sem compactar, está literalmente queimando gás natural à toa.
3. Escolher modelo por marketing, não por métrica
É tentador pegar o modelo mais novo e maior. Na minha vivência, para 80% das tarefas de produção, um modelo 7B bem ajustado ou um modelo médio com prompt bem estruturado resolve. Você economiza compute, energia e latência.
4. Não medir o que importa
Logs de quantos tokens entraram e saíram, quantas chamadas por feature, qual o custo por usuário ativo. Sem isso, você está pilotando no escuro. Quando o custo de energia subir (e vai subir), você não vai saber onde cortar.
5. Esquecer do cache
Cache semântico com embeddings é uma das otimizações com melhor ROI que já implementei. Perguntas similares geram respostas similares — não faça a GPU recomputar isso 10 mil vezes por dia.
Comparação: o cenário americano vs. o que o resto do mundo está fazendo
Enquanto os EUA apostam em gás natural para alimentar a corrida da IA, a Europa tem restrições muito mais duras de emissões, e a China está investindo pesado em renováveis paired com nuclear. Isso tem uma implicação geopolítica interessante: o país com energia mais barata e abundante para IA vai ter vantagem competitiva em custo de inferência global.
Para nós, devs, isso significa que o preço que você paga por APIs de modelos hospedados nos EUA pode não refletir o custo real de produção — está subsidiado por uma bolha de capital e energia barata. Quando a bolha ajustar, o mercado vai se reorganizar.
FAQ — Perguntas que um dev faria
Por que não usam energia renovável nos data centers?
Em muitos casos já usam — Google, por exemplo, tem data centers operando com 90%+ de energia limpa. O problema é que a oferta renovável não está crescendo no mesmo ritmo da demanda, e a intermitência solar/eólica exige backup firme. Para treinamento de modelos, que exige operação contínua, o backup acaba sendo gás ou diesel.
Isso vai afetar o preço das APIs de IA que eu uso?
Provavelmente sim, no médio prazo. Historicamente, o custo de inferência caiu por ganhos de eficiência (modelos menores, hardware melhor, técnicas como quantização). Mas se o custo de energia subir mais rápido que esses ganhos, vamos ver pressão de preço. Modelos open-source rodando localmente vão ficar mais atrativos.
Vale a pena investir em edge AI / modelos locais?
Depende do caso. Para aplicações com privacidade crítica, baixa latência ou volume alto, sim — o payback costuma ser de 6 a 18 meses. Para produtos em que você precisa de modelo de fronteira absoluto, ainda não compensa. Mas o espaço está evoluindo rápido; vale revisitar a decisão a cada 6 meses.
Quantificar minha pegada de carbono como dev faz sentido?
Faz mais sentido do que parece. Não por questão de moral, mas por questão de risco. Empresas vão começar a exigir relatórios de sustentabilidade de fornecedores. Se seu sistema consome muita inferência de LLM, isso vai aparecer no relatório. Melhor estar preparado.
Esse cenário realmente vai se concretizar?
O próprio relatório assume que vários projetos não serão concluídos. Mas a tendência é clara: a demanda por compute de IA está crescendo mais rápido que a infraestrutura energética pode acomodar. Os números podem ser exagerados em 30%, mas a direção está consolidada.
No fim das contas, a lição que tiro disso é simples: cada linha de código que escrevemos hoje tem um custo energético associado, e esse custo vai deixar de ser invisível nos próximos anos. Quem entender isso antes vai ter vantagem — tanto em performance de carreira quanto em systems design.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.