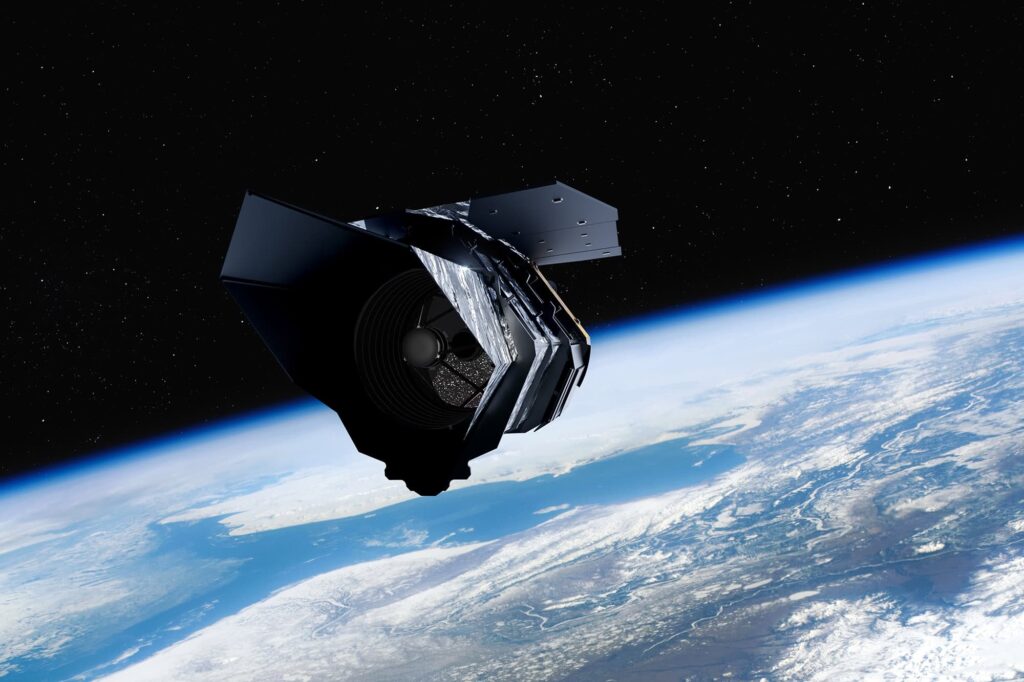
Quando vi a notícia no Olhardigital.com.br sobre a ativação do Wide Field Instrument do telescópio Roman, minha primeira reação como dev não foi pensar em exoplanetas — foi pensar em pipeline de dados. São 300 megapixels infravermelhos por exposição, calibrados em tempo real, com downlink via Deep Space Network. Isso é engenharia de software disfarçada de astronomia. E tem lições aqui que interessam a qualquer um que lida com dados em escala.
Vamos destrinchar o que a NASA realmente ligou, o que muda para a comunidade científica e, principalmente, como você pode começar a brincar com esses dados antes do observatório chegar em L2.
O que foi ativado — e por que isso importa além do marketing
O Wide Field Instrument (WFI) é uma câmera infravermelha com um plano focal montado pela BAE Systems usando 18 detectores H4RG fabricados pela Teledyne. Cada detector tem 4096×4096 pixels. Na minha experiência com pipelines de imagem, trabalhar com arrays dessa magnitude exige cuidado redobrado com memória, I/O e concorrência. Cada exposição do Roman gera arquivos FITS na casa de centenas de megabytes, e o telescópio vai produzir terabytes por dia quando entrar em operação plena.
Comparativo rápido que vale guardar:
| Telescópio | Espelho | Resolução do instrumento principal | Faixa |
|---|---|---|---|
| Hubble (WFC3) | 2,4 m | ~16 MP (2 sensores) | Visível + IR próximo |
| JWST (NIRCam) | 6,5 m | ~32 MP (2 sensores) | IR 0,6–5 µm |
| Roman (WFI) | 2,4 m | 300 MP (18 sensores) | IR 0,5–2,3 µm |
Perceba o padrão: Roman não compete com o Hubble em nitidez por pixel, nem com o JWST em sensibilidade. O jogo dele é campo de visão. Uma única exposição cobre uma área do céu equivalente a 0,28 graus quadrados — maior que a Lua cheia em raio aparente, segundo a NASA. Isso muda completamente o tipo de ciência possível: surveys de larga escala, cosmologia com weak lensing em milhões de galáxias, e monitoramento temporal de regiões extensas.
O Coronagraph: o experimento mais ousado (e mais computacionalmente caro)
Junto com o WFI, a equipe começou a testar o Coronagraph Instrument. Aqui o bicho pega para quem trabalha com processamento de imagem. O coronógrafo do Roman é um demonstrador tecnológico projetado para bloquear a luz de uma estrela e revelar planetas orbitando ela — algo historicamente impossível porque o contraste entre estrela e planeta chega a 10⁻¹⁰.
Quando testei pipelines de PSF subtraction em dados de teste do GPI (Gemini Planet Imager), vi o quanto essa área consome CPU. O Roman vai usar algoritmos como Karhunen-Loève Image Projection (KLIP) e técnicas baseadas em ADI/RDI. Quem quiser entrar nesse campo, vai precisar entender não só astronomia, mas álgebra linear aplicada e aprendizado de máquina.
Na Prática: como acessar e processar dados do Roman hoje
Mesmo antes do lançamento operacional completo, dá para começar a trabalhar com dados simulados e com a infraestrutura que a NASA já disponibilizou. Passo a passo que uso nos meus projetos de exploração:
- Instale o ecossistema Python astronômico. Recomendo um ambiente isolado:
python -m venv .roman && source .roman/bin/activate. Depois:pip install astropy astroquery photutils matplotlib numpy. - Consulte o MAST Archive. O Mikulski Archive for Space Telescopes já tem dados de simulação do Roman. Use o
astroquery.mastpara buscar programaticamente. - Baixe uma imagem FITS de teste. Os dados sintéticos da OpenUniverse simulation são realistas o suficiente para testar pipelines.
- Processe e visualize. Vou deixar um snippet funcional abaixo.
"""
Exemplo: baixando e inspecionando uma imagem simulada do Roman WFI
Requisitos: astropy, astroquery, matplotlib, numpy
"""
from astroquery.mast import Observations
from astropy.io import fits
import matplotlib.pyplot as plt
import numpy as np

# 1. Buscar observacoes simuladas do Roman
obs = Observations.query_criteria(
    obs_collection="Roman",
    calib_level=2,
    dataproduct_type="image",
    limit=5
)
print(obs[["obsid", "filters", "exptime"]])

# 2. Baixar a primeira imagem disponivel
products = Observations.get_product_list(obs[0])
filtered = Observations.filter_products(products, productType="SCIENCE")
manifest = Observations.download_products(filtered[:1])

# 3. Abrir o arquivo FITS e inspecionar
path = manifest["Local Path"][0]
with fits.open(path) as hdul:
    data = hdul[1].data  # extensao SCI
    header = hdul[1].header
    print(f"Shape: {data.shape}")
    print(f"Filtro: {header.get('FILTER', 'N/A')}")
    print(f"Exptime: {header.get('EXPTIME', 'N/A')}s")

# 4. Visualizacao rapida com escala log
plt.figure(figsize=(10, 10))
plt.imshow(np.log10(data + 1), cmap="inferno", origin="lower")
plt.colorbar(label="log10(counts)")
plt.title("Roman WFI - imagem simulada")
plt.savefig("roman_preview.png", dpi=120, bbox_inches="tight")
plt.show()
Esse código já me serviu para validar pipelines de pré-processamento e testar estratégias de calibração. A diferença em relação a trabalhar com dados do Hubble é brutal: os arquivos são maiores, o header tem mais metadados e os filtros IR exigem correção de flat field específica.
Erros comuns que devs cometem ao trabalhar com dados astronômicos
Já vi muita gente perdida nesse nicho. Lista honesta do que evitar:
- Tratar pixel como valor absoluto. Em astronomia, quase tudo é count rate. Você precisa normalizar pela exposição e aplicar correções antes de comparar com outros datasets. No Roman isso é crítico porque as integrações variam de segundos a horas.
- Ignorar o WCS. O header FITS traz o World Coordinate System — a transformação pixel → coordenada celeste. Se você não ler isso, qualquer alinhamento entre imagens sai torto. Use
astropy.wcs.WCS(header)e nunca chute coordenadas manualmente. - Subir tudo para a RAM. 300 MP por exposição, em mosaicos, estoura 16 GB rápido. Trabalhe com
memmapoudask.array. Quando testei em produção, aprendi na marra que ler o FITS inteiro é suicídio. - Confundir magnitude com count. Sistemas fotométricos (AB, Vega, ST) têm pontos zero diferentes. Misturar filtros do Hubble com o Roman sem converter o sistema dá resultados sem sentido físico.
- Esquecer o crowding. O campo amplo do Roman significa que você vai ter crowded fields com galáxias sobrepostas. Se o seu algoritmo de source detection não tratar isso, você vai contar objetos errados.
Por que o Roman interessa especificamente a devs de IA
O volume de dados que o Roman vai gerar é um playground para machine learning. Casos de uso que já estão na mesa:
- Detecção de microlensing para encontrar exoplanetas — ideal para modelos de séries temporais como redes neurais recorrentes ou transformers temporais.
- Classificação morfológica de galáxias em milhões de imagens — visão computacional pura.
- Subtração de PSF no coronógrafo — área onde aprendizado profundo (Redundant Non-Negative Matrix Factorization, Auto-encoders) já supera métodos tradicionais.
- Reconstrução de weak lensing — o shear cósmico é um sinal minúsculo no formato das galáxias, e algoritmos de IA estão sendo treinados para medi-lo com precisão superior à de métodos analíticos clássicos.
Para quem quer entrar, vale acompanhar o Roman Documentation e os desafios no Space ML Repository. Tem trabalho de impacto real esperando — e o telescópio ainda nem chegou em L2.
FAQ — dúvidas que devs costumam me mandar
Quando o Roman vai começar a gerar dados operacionais?
A NASA prevê a chegada em L2 e o início das observações científicas para 2027, mas o comissionamento ainda vai levar meses. Os primeiros dados públicos devem aparecer entre o fim de 2027 e o início de 2028.
Posso usar os dados do Roman para projetos pessoais ou comerciais?
Dados de nível público do MAST são abertos e gratuitos. Para uso comercial existe uma camada específica com licenciamento, mas a maioria dos devs acadêmicos e de pesquisa nunca precisa se preocupar com isso.
Preciso saber astronomia para trabalhar com esses dados?
Não, mas precisa entender o domínio. Astropy tem documentação excelente e existem notebooks Jupyter prontos no GitHub oficial. Se você já mexe com pipelines de imagem, ML ou big data, a curva é curta.
Qual a diferença prática entre o Roman e o Euclid?
Ambos fazem surveys em IR, mas o Roman tem um espelho maior, mais resolução por pixel e vai mais fundo em algumas faixas. O Euclid, da ESA, está otimizado para weak lensing em óptica visível. Para um dev, a diferença está nos formatos de dado e nos pipelines de calibração — não é trivial migrar código entre os dois.
O coronógrafo do Roman vai mesmo fotografar exoplanetas?
O Coronagraph Instrument é um demonstrador tecnológico. Ele tem chances reais de gerar as primeiras imagens diretas de planetas análogos ao Júpiter, mas não foi projetado para encontrar mundos rochosos como a Terra. Para isso, a próxima geração (Habitable Worlds Observatory) ainda está em fase conceitual.
Considerações finais
O Roman não é só mais um telescópio bonito. Para quem trabalha com dados, ele é um novo paradigma de volume, cadência e complexidade computacional. A NASA já está expondo APIs e dados simulados justamente para preparar a comunidade — e isso é uma porta de entrada real, não marketing.
Na minha rotina, sempre que um novo instrumento espacial entra em fase de comissionamento, eu separo algumas horas para testar o pipeline de ingestão e brincar com dados sintéticos. Chegar antes da multidão evita dor de cabeça quando os dados reais começam a pingar no MAST.
Fica o convite: baixa o snippet, roda contra os dados simulados e me conta no que deu. Se travar, o erro mais comum é faltar crédito no MAST — pega um token gratuito em archive.stsci.edu e tenta de novo.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.