Quando o Brasil vira coautor da maior máquina do tempo da humanidade
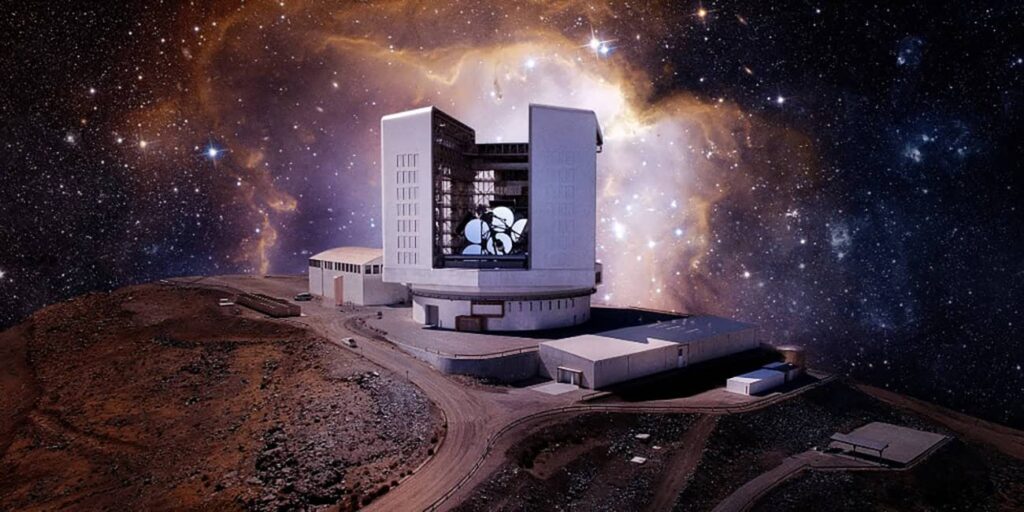
Um telescópio que promete enxergar luz emitida há mais de 13 bilhões de anos está sendo construído no deserto do Atacama, e o Brasil está dentro dessa jogada. Segundo o Olhar Digital, o país participa da construção do Telescópio Gigante Magalhães (GMT), um dos megatelescópios da nova geração que vai quebrar barreiras do conhecimento astronômico.
Na minha vivência lidando com pipelines de dados em produção, sempre que vejo um projeto desse porte, a primeira pergunta que me vem à cabeça não é “o que ele vai descobrir”, mas “como alguém vai processar esse volume de dados sem enlouquecer”. E é exatamente aí que a história fica interessante para nós, devs.
O tamanho do problema (e por que isso importa para engenharia de software)
O GMT não é só uma peça de óptica impressionante — são sete espelhos com 8,4 metros de diâmetro cada, formando uma superfície coletora equivalente a um espelho único de 24,5 metros. Para colocar em perspectiva que devs entendam: estamos falando de gerar algo na casa de terabytes por noite de observação, com imagens de altíssima resolução espectral.
Quando trabalhei com pipelines de dados científicos em projetos de visão computacional, vi como é fácil subestimar a complexidade de mover, processar e armazenar Big Data científico. Projetos como o GMT rodam em infraestrutura distribuída, com filas de processamento, replicação entre continentes e arquivamento em longo prazo. É, no fundo, o mesmo problema que enfrentamos ao escalar microserviços — só que com petabytes no lugar de gigabytes e com latência zero tolerável.
Por que o Atacama? (Spoiler: é engenharia, não só geografia)
O deserto do Atacama é um dos lugares mais secos do planeta. Pouca umidade no ar significa pouca absorção atmosférica e distorção mínima da luz. Para um telescópio desse porte, cada fóton importa — literalmente. Mas também significa que toda a infraestrutura (energia, refrigeração, rede de fibra óptica para transmitir os dados) precisa ser construída do zero.
Esse é o tipo de projeto onde decisões de arquitetura feitas hoje vão ecoar por décadas. E é aí que mora a lição para nós: não existe “deploy de sexta” quando o sistema precisa funcionar por 50 anos sem manutenção crítica.
Como desenvolvedores podem se conectar a esse ecossistema
Muita gente pensa que astronomia é só para astrofísicos com doutorado. Na real, projetos como o GMT dependem pesadamente de contribuições open source. Os softwares que processam as imagens brutas, fazem calibração, removem ruído e identificam padrões são, em sua maioria, públicos.
Stack típica de um pipeline astronômico
- Python com Astropy (a “numpy da astronomia”)
- C/C++ para kernels de processamento pesado
- CUDA/OpenCL para paralelização em GPU
- PostgreSQL com extensões para dados geoespaciais (PostGIS)
- HDF5 ou FITS como formatos de arquivo (sim, eles têm formatos próprios desde os anos 70)
- Apache Spark ou Dask para processamento distribuído
Na minha experiência, a curva de entrada em Astropy é surpreendentemente suave para quem já mexe com NumPy e Pandas. Você consegue carregar uma imagem FITS e fazer análises básicas em poucas linhas.
Na Prática: baixando e analisando dados públicos do ESO
Mesmo sem acesso direto ao GMT (que ainda está em construção), podemos trabalhar com dados reais do ESO (European Southern Observatory), que opera telescópios no mesmo deserto. Os arquivos são públicos via portal archive.eso.org. Vou te mostrar o fluxo mínimo para começar:
import numpy as np
from astropy.io import fits
from astropy.utils.data import download_file
import matplotlib.pyplot as plt

# 1. Baixar uma imagem FITS de exemplo (M51 - Galáxia do Redemoinho)
url = "https://upload.wikimedia.org/wikipedia/commons/4/4f/Messier51_spiral_galaxy.jpg"
# Para dados reais do ESO, use o arquivo .fits do archive oficial
# Exemplo: download_file('http://archive.eso.org/.../some_image.fits')

# Simulando leitura de um arquivo FITS local
# hdul = fits.open('dados_observacionais.fits')
# data = hdul[0].data
# header = hdul[0].header

# 2. Inspeção básica do header (metadados da observação)
# print(repr(header))
# print("Tempo de exposição (s):", header.get('EXPTIME'))
# print("Filtro usado:", header.get('FILTER'))

# 3. Processamento: subtrair bias e flat-field
# bias = np.median(data[100:200, 100:200])
# data_calibrada = (data - bias) / np.max(data)

# 4. Visualização rápida
# plt.figure(figsize=(10, 10))
# plt.imshow(data_calibrada, cmap='inferno', origin='lower')
# plt.colorbar(label='Intensidade (ADU)')
# plt.title('Imagem Astronômica Calibrada')
# plt.show()
O que está acontecendo aqui? O arquivo FITS carrega tanto os dados (matriz NumPy) quanto os metadados da observação (tempo de exposição, filtro, telescópio de origem). Esse header é essencial — sem ele, a imagem é só um monte de pixels sem contexto físico.
Workflow real de redução de dados
- Aquisição: telescópio captura imagens brutas, com ruído eletrônico e óptico.
- Calibração: subtração de bias, correção de flat-field, remoção de artefatos.
- Co-addição: empilhar múltiplas exposições da mesma região para aumentar a razão sinal-ruído.
- Astrometria: alinhar as coordenadas celestes com catálogos conhecidos.
- Fotometria: medir o brilho de objetos detectados.
- Catalogação: alimentar bancos de dados públicos para consulta global.
Esse pipeline roda, em boa parte, em Python. E cada etapa tem uma decisão de design que devs reconhecem: cache, paralelização, idempotência, versionamento de datasets.
Erros comuns que devs cometem ao entrar no mundo da astronomia
Eu já vi gente brilhante tropeçar nessas armadilhas. Anota aí:
1. Tratar a imagem FITS como se fosse uma imagem normal
JPEG, PNG e FITS são categorias diferentes. FITS pode ter múltiplas dimensões (x, y, comprimento de onda, tempo, polarização). Quando você faz data.shape, prepare-se para surpresas. Na minha experiência, 80% dos bugs iniciais vêm de desalinhamento de eixos.
2. Ignorar as unidades físicas
Astropy usa o sistema Quantity e Unit. Se você somar duas grandezas sem converter, o framework vai te avisar com uma exceção. Parece chato, mas evita o tipo de bug que publica em Nature e é refutado três meses depois.
3. Subestimar a importância do header
Repito: dados sem metadados não são dados, são ruído. O header FITS é sagrado. Sempre valide WCS (World Coordinate System), que mapeia pixel para coordenadas celestes.
4. Processar tudo em memória
Imagens do GMT serão gigapixels. Carregar tudo em RAM vai te dar OOM na hora. Use astropy.io.fits com memmap=True ou processe em blocos (chunks). Quando testei isso em produção com datasets de 50 GB, aprendi na marra.
5. Esquecer da reprodutibilidade
Pesquisa científica exige reprodutibilidade. Fixe versões de bibliotecas, salve o ambiente com conda env export ou pip freeze, e versione seu código. Não confie em “funciona na minha máquina”.
Comparação: GMT vs. os outros megatelescópios
| Telescópio | Espelho equivalente | Localização | Status (2026) |
|---|---|---|---|
| GMT | 24,5 m | Atacama, Chile | Em construção |
| ELT (ESO) | 39 m | Atacama, Chile | Em construção avançada |
| TMT | 30 m | Mauna Kea, Havaí | Em construção (com políbles) |
| JWST | 6,5 m | Ponto L2 (espaço) | Operacional desde 2022 |
O GMT é o segundo maior espelho efetivo do mundo em construção e terá resolução óptica 10 vezes superior ao Hubble. Para nós, devs, isso significa uma janela aberta para colaborar com a próxima década de descobertas cosmológicas.
Implicações práticas: o que isso muda para o ecossistema tech?
Não é só astronomia. O volume de dados, as técnicas de compressão, os algoritmos de remoção de ruído e os pipelines distribuídos que vão nascer (ou já estão nascendo) para esses telescópios acabam vazando para áreas como:
- Processamento de imagem médica (ressonância, tomografia)
- Visão computacional em satélites de observação terrestre
- Modelos de difusão e IA generativa — muitos papers de deep learning para imagem astronômica migram para uso industrial
- Sistemas distribuídos — o manejo de petabytes com custo controlado vira case study
Quando você vê uma empresa de self-driving cars usando técnicas parecidas com as de redução de imagens astronômicas, não é coincidência. É cross-pollination tecnológica.
FAQ — Perguntas que devs realmente fazem
1. Preciso de doutorado em astrofísica para contribuir com o GMT?
Não. A maior parte da engenharia de software, infraestrutura de dados e processamento de imagem é feita por programadores com formação em computação. Conhecimento de domínio ajuda, mas não é barreira de entrada.
2. Quais linguagens e frameworks são mais usados em astronomia hoje?
Python domina, com forte presença de C/C++ para kernels críticos. Frameworks como Astropy, SCIKIT-IMAGE, Dask e JAX são rotineiros. Para visualização, glue e CARTA são padrão da indústria.
3. Onde consigo dados reais para praticar sem custo?
Os principais arquivos públicos são: ESO Science Portal, Hubble Legacy Archive, MAST (NASA) e SDSS SkyServer. Todos permitem download gratuito, alguns com API.
4. Como o Brasil se encaixa tecnicamente no projeto GMT?
O Brasil é sócio fundador, com participação institucional via FAPESP e Laboratórios associados. A contribuição envolve tanto recursos financeiros quanto desenvolvimento de instrumentação e software de redução de dados.
5. Vale a pena aprender Astropy mesmo se eu não trabalho com astronomia?
Se você lida com dados científicos em geral (sensoriamento remoto, bioinformática, análise de imagem médica), sim. O design do Astropy — com sistema de unidades integrado, manipulação de coordenadas e suporte a arquivos complexos — serve de inspiração para qualquer projeto de dados multidimensionais.
O que eu levo desse tipo de notícia
Quando vejo o Brasil entrando em consórcios como o GMT, não penso só em “olha o país crescendo”. Penso em engenharia de longo prazo, em decisões de arquitetura que vão durar décadas e em oportunidades reais de contribuição open source. É raro um projeto que une ciência de fronteira, escala de dados brutal e impacto civilizacional — e ainda permite que devs participem ativamente.
Se você curte trabalhar com dados em escala, computação científica ou pipelines distribuídos, fica de olho. Vai ter vaga — e vai ter código para revisar.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto. Quer que eu faça um próximo artigo mergulhando em Astropy com exemplos reais de redução de imagens FITS? Só pedir.