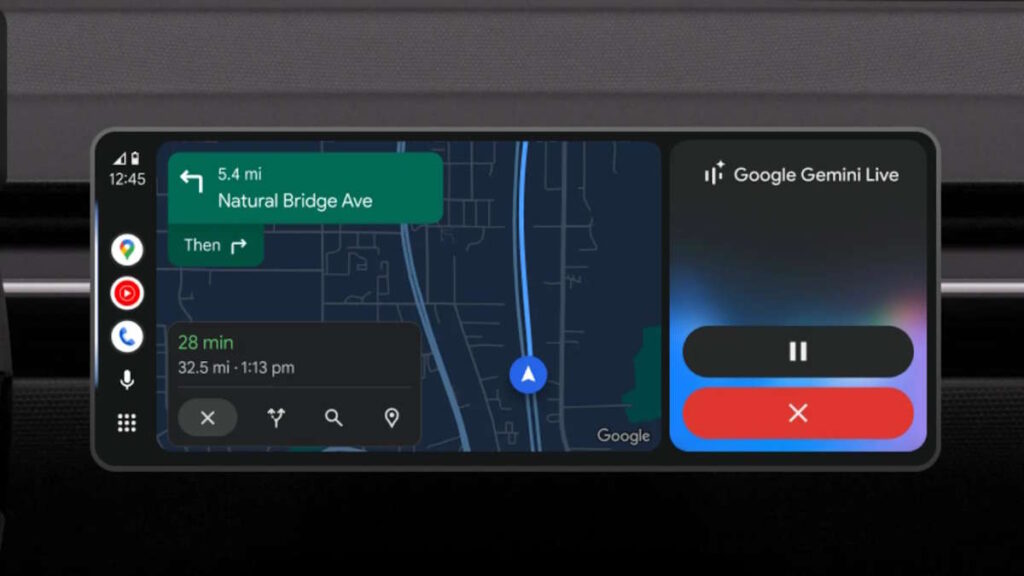
Gemini no Android Auto: quando a IA generativa encontra a realidade da estrada
Segundo o Sapo.pt, a transição do Google Assistente para o Gemini no Android Auto está a gerar uma onda de queixas entre os utilizadores. E, na minha experiência como dev que trabalha com LLMs em produção, os problemas relatados não me surpreendem — são exatamente o tipo de falha que acontece quando se troca um sistema baseado em comandos determinísticos por um modelo conversacional generativo num contexto onde latência e previsibilidade são críticas. Não quero entrar aqui no debate do “perigo na estrada” como se fosse um moralismo vazio. Quero dissecar tecnicamente o que está a falhar, por que está a falhar e o que isso ensina a quem constrói interfaces de voz para sistemas embarcados.
O problema central: o Gemini é um LLM, e LLMs não são determinísticos
O Google Assistente clássico funcionava, em grande parte, com um pipeline de NLU (Natural Language Understanding) baseado em intent classification e slot filling. Quando dizias “navega para casa”, havia um modelo treinado especificamente para reconhecer aquele intent e extrair a entidade (endereço de casa). Resposta em milissegundos, porque o caminho era curto e cacheável.
O Gemini é um LLM generativo. Mesmo o Gemini Nano, que roda localmente em alguns dispositivos, opera com arquitetura transformer e tem overhead computacional completamente distinto. Quando lhe pedes “navega para casa”, o modelo precisa de gerar tokens, raciocinar sobre o contexto, e potencialmente devolver uma resposta em linguagem natural antes de executar a ação. Isto, em hardware automotivo limitado, é receita para lag.
Na minha experiência, vejo este padrão repetir-se sempre que uma empresa troca um sistema de comandos por um chatbot: a promessa é “linguagem natural”, a entrega é “linguagem natural lenta”. E em contexto de condução, lentidão é sinônimo de distração.
Por que os utilizadores estão certos nas queixas
O Sapo.pt reporta casos em que comandos simples exigem várias tentativas e diálogos demorados. Isto bate certo com um problema clássico de LLMs: alucinação de intent e ambiguidade semântica. Quando um modelo generativo tem de decidir entre interpretar “manda mensagem à Maria” como abrir WhatsApp ou SMS, ou perguntar “qual Maria?”, ele muitas vezes opta pelo caminho que gera mais tokens, não pelo caminho mais útil.
Quando uso modelos generativos para automação, percebo que o grande vilão não é a capacidade de compreensão — é a imprevisibilidade do output. Um classificador de intents dá-te sempre a mesma resposta para o mesmo input. Um LLM pode dar-te hoje uma interpretação e amanhã outra. Num carro, isto é intolerável.
Comparação com alternativas: o que devíamos aprender com a Siri e a Alexa
A Apple e a Amazon resolveram este problema com uma arquitetura híbrida: um modelo leve de NLU na borda (on-device) que faz o trabalho sujo do reconhecimento de intent, e só em casos complexos (ou quando o utilizador explicitamente invoca o modo conversacional) é que um LLM é chamado.
No fundo, o que a Google fez foi inverter esta lógica: passou o LLM para primeiro plano, relegando o NLU determinístico. Para um developer que esteja a desenhar uma interface conversacional para sistemas embarcados, a lição é clara: o LLM deve ser a camada de exceções, não a camada padrão. Os 95% de comandos previsíveis do dia a dia devem ser tratados por algo mais rápido e determinístico.
| Sistema | Arquitetura | Latência Típica | Determinismo |
|---|---|---|---|
| Google Assistente (antigo) | Intent classification + NLU | ~300-500ms | Alto |
| Gemini (atual) | LLM generativo | ~1.5-3s | Baixo |
| Siri (híbrida) | NLU local + LLM cloud | ~400ms-2s | Médio |
| Alexa (híbrida) | NLU local + LLM opcional | ~500ms-1.5s | Médio |
Na Prática — como construir uma interface de voz que não mata o utilizador
Se estás a desenvolver um sistema de voz para um contexto onde latência importa (carro, dispositivo médico, comando industrial), segue este passo a passo:
- Define o vocabulário core primeiro. Mapeia os 20-30 comandos mais frequentes. Para um carro, são “navega para X”, “manda mensagem a Y”, “toca Z”, “aumenta volume”.
- Implementa um NLU determinístico local. Pode ser um classificador simples baseado em embeddings, ou até regex bem construído para os intents mais óbvios.
- Só usa o LLM como fallback. Quando o NLU local falha (confiança abaixo de um threshold), aí sim, chamas o modelo generativo.
- Cache agressivamente. “Manda mensagem à Maria” tem sempre a mesma estrutura sintática. Não precisas de perguntar ao modelo cada vez.
- Timeouts curtos e degradação graceful. Se o LLM não responde em 1.5s, executa a melhor interpretação do NLU local ou pede clarificação.
- Mostra sempre o estado no ecrã. O utilizador precisa de feedback visual de que algo está a acontecer — caso contrário, vai repetir o comando e piorar a situação.
Um exemplo simplificado em Python desta arquitetura híbrida:
import time
from typing import Optional

class VoiceAssistant:
    def __init__(self, nlu_local, llm_remote):
        self.nlu = nlu_local
        self.llm = llm_remote
        self.confidence_threshold = 0.85
        self.llm_timeout = 1.5  # seconds

    def process_command(self, audio_input: str) -> dict:
        start = time.time()

        # 1. Tenta NLU local primeiro (rápido e determinístico)
        intent, confidence = self.nlu.classify(audio_input)

        if confidence >= self.confidence_threshold:
            return {
                "action": intent,
                "source": "local_nlu",
                "latency_ms": int((time.time() - start) * 1000)
            }

        # 2. Fallback para LLM com timeout agressivo
        try:
            result = self.llm.interpret(
                audio_input,
                timeout=self.llm_timeout
            )
            return {
                "action": result["action"],
                "source": "llm",
                "latency_ms": int((time.time() - start) * 1000)
            }
        except TimeoutError:
            # 3. Degradação graceful: pede clarificação
            return {
                "action": "clarify",
                "source": "fallback",
                "message": "Não percebi. Pode repetir?",
                "latency_ms": int((time.time() - start) * 1000)
            }

# Uso real:
# assistant.process_command("navega para o trabalho")
# {'action': 'navigate', 'target': 'trabalho', 'source': 'local_nlu', 'latency_ms': 340}
Repara como o confidence_threshold e o llm_timeout são críticos. Estes dois parâmetros controlam o trade-off entre “compreensão correta” e “rapidez de resposta”. No contexto automotivo, eu recomendaria 0.75 para o threshold — aceitas mais falsos positivos do LLM local em troca de nunca teres de esperar pelo modelo generativo.
Erros Comuns que devs cometem ao integrar LLMs em sistemas de voz
Depois de ter trabalhado em projetos com integrações de voz, vejo estes deslizes uma e outra vez:
- Colocar o LLM como entrada primária. Tratar o modelo generativo como o primeiro ponto de contacto e não como último recurso. Resultado: latência desnecessária em 80% dos casos.
- Não ter feedback visual imediato. O utilizador ouve silêncio enquanto o LLM processa e assume que o sistema não ouviu. Repete. O LLM processa duas vezes. Caos.
- Confundir “linguagem natural” com “linguagem útil”. O Gemini responde com frases bonitas, mas o utilizador no carro quer um “ok” e a ação a ser executada, não uma dissertação.
- Esquecer o modelo de confiança. Sem um sistema que diga “tenho 95% de certeza que é isto”, não sabes quando deves confirmar com o utilizador ou executar diretamente.
- Não testar com utilizadores reais em contexto real. Testar no escritório com o carro parado dá-te métricas que nada valem. O stress da condução, o ruído ambiente, a pressa — tudo muda o comportamento do utilizador.
- Subestimar o custo cognitivo de esperar. 500ms parece pouco. Mas é a diferença entre “comando executado” e “utilizador a verificar se funcionou, olhos fora da estrada”.
O que isto significa para developers de IA
O caso do Gemini no Android Auto é, para mim, um case study perfeito do que acontece quando se deixa o hype do LLM ultrapassar o bom senso de engenharia. A Google tem um produto onde a maioria dos comandos são previsíveis e curtos — exatamente o cenário onde LLMs brilham menos e onde NLU tradicional brilha mais.
Se estás a trabalhar em qualquer sistema onde velocidade de resposta importa mais do que profundidade de raciocínio, lembra-te: o melhor modelo não é o mais inteligente, é o mais adequado ao contexto. E num carro, o contexto exige milissegundos, não criatividade linguística.
Há também uma lição mais ampla sobre product management: a Google está disposta a piorar a experiência de curto prazo para treinar os utilizadores (e o modelo) a usar linguagem mais natural. Pode funcionar a longo prazo. Mas, no caminho, arrisca-se a perder utilizadores para alternativas (CarPlay, sistemas nativos dos fabricantes) e a dar argumentos a quem diz que IA generativa é hype, não solução.
FAQ — Perguntas que devs realmente fazem sobre este tema
O Gemini Nano não deveria resolver o problema de latência ao rodar localmente?
Em teoria sim. Na prática, o Gemini Nano em dispositivos móveis ainda tem limitações de memória e o processamento de áudio para texto + inferência do modelo consome recursos que competem com a navegação, música e outras apps em execução. Além disso, modelos menores tendem a ser menos robustos na interpretação de linguagem natural ambígua.
Existe alguma forma de os developers forçarem o Google a reverter a decisão?
Não diretamente. Mas o feedback nos fóruns, as reviews negativas na Play Store e a pressão de fabricantes automóveis (que podem preferir soluções próprias como o CarPlay da Apple) são os mecanismos reais de influência. Historicamente, a Google já voltou atrás em decisões controversas quando a pressão foi suficiente.
Como posso testar a latência real do Gemini no Android Auto antes de comprar um carro compatível?
Podes testar o Gemini no telemóvel em condições similares (com conexão ao carro via Bluetooth, comandos de voz enquanto caminhas, etc.) para ter uma noção. Mas o teste definitivo só acontece em condução real, porque é onde a carga cognitiva muda.
Vale a pena construir o meu próprio sistema de voz para um produto IoT/embarcado?
Depende do volume de comandos previsíveis. Se 80% dos teus utilizadores usam 20 comandos fixos, sim — um NLU local bem feito supera qualquer LLM em latência e custo. Se os comandos são verdadeiramente variados e imprevisíveis, aí sim, o LLM faz sentido como camada primária.
Que ferramentas recomendas para construir a camada NLU local?
Para começar rápido, o Vosk (open-source, suporta várias línguas) para speech-to-text, combinado com um classificador leve (scikit-learn, ou um modelo pequeno de embeddings com cosine similarity). Para produção mais séria, considera o Picovoice ou o Rhino da mesma empresa, que são otimizados para on-device e têm modelos pré-treinados por vertical.
Conclusão: o futuro não é “tudo LLM”
O que o Sapo.pt reporta sobre o Gemini no Android Auto confirma algo que venho a dizer há anos: a próxima geração de interfaces inteligentes não vai ser dominada por LLMs puros, mas por arquiteturas híbridas que sabem quando usar um modelo generativo e quando não usar. A Google, ironicamente, está a ensinar-nos esta lição ao contrário — mostrando o que acontece quando se ignora esta sabedoria de engenharia.
Se estás a construir produtos de voz, a takeaway principal é esta: trata o LLM como uma ferramenta poderosa mas pesada, não como o motor padrão. Coloca-o onde a ambiguidade é alta e a latência tolerável. Mantém o caminho rápido e determinístico para os 80% de comandos que o utilizador realmente faz todos os dias.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.