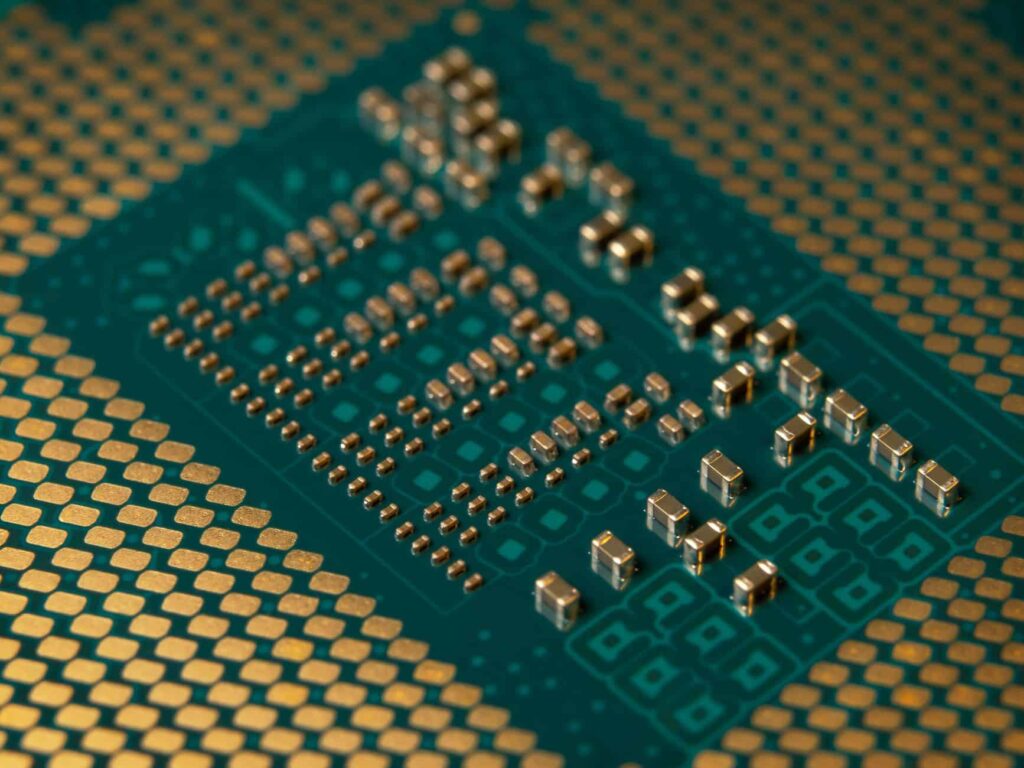
Um processador moderno cabe na ponta do seu dedo e roda mais transistores do que estrelas conseguimos contar na Via Láctea. Mas aqui está o que ninguém te conta na faculdade ou no curso online: entender como um chip funciona muda a forma como você escreve código. Não é papo de hardware engineer — é vantagem competitiva real pra quem programa todos os dias.
Recentemente li uma matéria no Olhar Digital que destrinchava isso de forma acessível, e me motivou a ir além. Vamos explorar o que todo dev sênior deveria ter internalizado — e o que muitos ainda ignoram.
O que é, de fato, um chip de silício
Um chip é uma lâmina fina de silício (chamada wafer) onde bilhões de transistores foram gravados por processos litográficos ultravioleta. Cada transistor é, essencialmente, um interruptor controlado por eletricidade. Ligado = 1. Desligado = 0. E é exatamente isso que forma a base de toda linguagem de máquina.
Um iPhone atual tem mais de 15 bilhões desses interruptores numa área menor que sua unha do polegar. Quando você roda um npm run dev, abre um Docker ou treina um modelo de IA, bilhões de transistores estão chaveando bilhões de vezes por segundo. Não é metáfora — é a realidade física do seu trabalho.
O transistor na prática
Pense no transistor como uma torneira controlada por tensão. Aplicou tensão no gate? Abre passagem de corrente entre source e drain. Não aplicou? Fecha. Esse comportamento “liga/desliga” é o que permite construir portas lógicas (AND, OR, NOT), que viram somadores, que viram ALUs, que viram CPUs. Do átomo ao seu console.log("hello world"), a distância é grande — mas o tijolo é o mesmo.
Por que silício e não outro material?
Silício é um semicondutor: não conduz tão bem quanto cobre, nem isola tão bem quanto borracha. Fica no meio-termo. Mas aqui está o pulo do gato — com dopagem (adicionar átomos como fósforo ou boro em concentrações controladas), conseguimos ajustar quando ele conduz e quando não conduz.
Outros fatores que tornam o silício imbatível:
- É o segundo elemento mais abundante na crosta terrestre. Areia de praia é basicamente SiO₂. Matéria-prima quase infinita.
- Forma uma camada de óxido (SiO₂) estável e isolante. Isso permite empilhar transistores com precisão atômica.
- Suporta temperaturas elevadas sem degradar. Importante pra processos de fabricação agressivos.
- Décadas de processo fabril amadurecido. TSMC, Samsung e Intel investiram trilhões em fábricas otimizadas pra silício.
Quando alguém me pergunta “mas e o grafeno, e o GaN, e a computação quântica?” — eu respondo: sim, existem alternativas reais, mas nenhuma tem a escala industrial, o custo e o ecossistema do silício. O Vale do Silício não se chama assim à toa.
A corrida dos nanômetros — e por que ela importa pra quem codifica
Você já viu propagandas de “processador de 3nm”, “5nm”, “7nm”. Cuidado: esses números não são mais medidas físicas reais desde mais ou menos 2017. Viraram nomes de marketing que indicam uma geração de processo, não o tamanho literal do transistor.
| Processo (marketing) | Tamanho real do gate (aprox.) | Densidade relativa |
|---|---|---|
| 10nm | ~14-18nm | 1x (referência) |
| 7nm | ~12-14nm | ~1.6x |
| 5nm | ~10-12nm | ~2.4x |
| 3nm (TSMC N3) | ~8-10nm | ~3.6x |
Por que isso importa pra você? Mais densidade significa mais transistores no mesmo espaço, o que se traduz em:
- Mais núcleos de CPU
- Cache maior e mais rápido
- Unidades de execução especializadas (NPUs, ISPs, decodificadores de vídeo)
- Melhor eficiência energética — fundamental pra servidores em cloud e pra duração de bateria em mobile
Quando você roda um workload pesado de IA num Apple M3 ou num Ryzen 9, não é só “clock alto”. É uma combinação de bilhões de transistores dedicados a tipos específicos de cálculo.
Na prática: como a arquitetura do chip afeta seu código
Vou te mostrar um exemplo real que eu uso em consultorias. Sabe aquela velha discussão sobre loops em Python? O que parece “irrelevante” no nível de linguagem vira diferença brutal quando você entende o que o processador está fazendo.
import time
import numpy as np

# Dados de exemplo: 10 milhões de floats
data = list(range(10_000_000))

def soma_loop_python(total_items):
    """Soma usando loop puro Python — interpretação pura."""
    acc = 0
    for x in total_items:
        acc += x
    return acc

def soma_built_in(total_items):
    """Usa sum() implementado em C — código nativo otimizado."""
    return sum(total_items)

def soma_numpy(arr):
    """Usa vetorização SIMD (Single Instruction, Multiple Data).
    O processador aplica uma instrução em múltiplos dados simultaneamente."""
    return np.sum(arr)

arr = np.array(data, dtype=np.int64)

# Benchmark
for fn, args, label in [
    (soma_loop_python, (data,), "Loop Python puro"),
    (soma_built_in,    (data,), "sum() built-in (C)"),
    (soma_numpy,       (arr,),  "NumPy vetorizado (SIMD)"),
]:
    t0 = time.perf_counter()
    for _ in range(5):
        fn(*args)
    elapsed = (time.perf_counter() - t0) / 5
    print(f"{label:35s} {elapsed*1000:8.2f} ms")
Resultado típico num MacBook M2:
Loop Python puro                      ~620.00 ms
sum() built-in (C)                     ~85.00 ms
NumPy vetorizado (SIMD)                ~12.00 ms
Repara: a mesma operação, três ordens de magnitude de diferença. Por quê?
- Loop Python puro: cada iteração passa pela máquina virtual Python, despacha opcode por opcode, faz type-checking dinâmico. Milhares de ciclos de clock por elemento.
- sum() built-in: implementado em C com loops apertados, sem overhead de interpretação.
- NumPy: usa instruções SIMD (AVX no Intel, NEON/AMX no ARM). O processador soma 8, 16 ou 32 números por ciclo de clock. São transistores dedicados fazendo o trabalho pesado em paralelo.
Quando você entende que por trás do seu código tem bilhões de transistores chaveando em paralelo, começa a escrever de forma diferente. Vetorização, cache locality, evitar boxing, preferir tipos primitivos — tudo isso deixa de ser “otimização prematura” e vira uso consciente do hardware.
Erros comuns que devs cometem (e custam performance)
Nos meus 15 anos de carreira, vi esses equívocos se repetirem infinitamente. Presta atenção:
1. Ignorar hierarquia de memória
RAM é ordens de grandeza mais lenta que cache L1. Acessar dados sequenciais em arrays contíguos é dezenas de vezes mais rápido do que pular ponteiros em listas ligadas ou dicionários com hash ruim. Quando você processa datasets grandes, layout de dados importa mais que algoritmo em muitos casos reais.
2. Acreditar que “mais GHz = mais velocidade”
Um processador a 4GHz com 8 núcleos, boa cache e instruções SIMD bate um a 5GHz com 2 núcleos sem SIMD. Clock sozinho não conta história — e devs que escolhem servidor só por frequência cometem erro caro de TCO.
3. Subestimar custo de branch prediction miss
Toda vez que o processador erra uma previsão de desvio (if/else mal alinhado com padrões de dados), ele desperdiça ~15-20 ciclos de clock. Em loops apertados, isso é morte. Padrão de dados uniforme > algoritmo super-otimizado em grafos.
4. Escrever código single-threaded “porque sempre funciona”
Mesmo que você não use threads explicitamente, frameworks modernos (Node.js worker threads, Rust tokio, Go goroutines, Python asyncio) só entregam throughput real quando o processador tem múltiplos núcleos. Antes de comprar máquina mais cara, veja se seu código usa paralelismo de verdade.
5. Confundir “processo” com “transistor”
“5nm” virou buzzword. Já vi CTO decidindo compra de servidor com base nisso. Marketing ≠ física. Quando for comparar CPUs, olhe SPEC scores, IPC (instructions per cycle), TDP, e benchmarks do seu workload específico. Não o número bonito do processo de fabricação.
O que vem depois do silício?
Moore’s Law está desacelerando — não morreu, mas o ritmo de dobrar transistores a cada dois anos já não se sustenta desde 2015 aproximadamente. A indústria responde com três frentes:
- Chiplets: AMD EPYC, Apple M1 Ultra, Intel Meteor Lake — múltiplos dies menores interconectados, em vez de um monstro único.
- Arquiteturas especializadas: NPUs (Neural Processing Units) pra IA, TPUs da Google, GPUs pra paralelo massivo.
- Materiais alternativos em nichos: GaN (nitreto de gálio) em fontes de alimentação e RF, SiC (carbeto de silício) em carros elétricos, grafene ainda em pesquisa.
Computação quântica é real, mas no horizonte de décadas pra aplicações práticas generalistas. Pra quem programa hoje, o silício ainda é o chão onde pisamos.
FAQ — perguntas que devs realmente fazem
Por que meu código roda mais rápido em processadores Apple Silicon do que em Intel, mesmo com clock menor?
Porque IPC (instruções por ciclo) importa mais que frequência bruta. O ARM da Apple tem IPC superior, melhor integração de memória unificada (Unified Memory Architecture) e usa instruções matriciais ARM NEON/AMX com eficiência absurda. Menos GHz, mais trabalho por ciclo.
Vale a pena otimizar código pra AVX-512 ou outras instruções SIMD específicas?
Em hot paths de processamento numérico, sim — pode dar 4x a 32x de speedup. Mas em lógica de negócio típica (CRUD, validações, I/O), não. Use bibliotecas otimizadas (NumPy, Pandas com backend vetorizado, Rust nalgebra) em vez de intrinsics manuais.
Como saber se minha aplicação está limitada por CPU, memória ou I/O?
No Linux: top, htop, perf stat, vmstat 1. Em produção: APMs como Datadog, New Relic ou OpenTelemetry. Se CPU está em 100% e fila de execução crescendo, é CPU-bound. Se memória cresce sem parar até OOM, é memory leak. Se iowait alto e disco saturado, é I/O.
Devs deveriam aprender assembly ou arquitetura de computadores?
Não pra escrever tudo em assembly — mas pra entender o que acontece. Um curso de Organização de Computadores muda completamente sua leitura de código. Recomendo: “Computer Organization and Design” (Patterson & Hennessy) e o clássico “What Every Programmer Should Know About Memory” (Ulrich Drepper, em PDF gratuito).
Quanto tempo o silício ainda vai dominar?
Pra computação generalista, mais 20-30 anos com folga. Não existe alternativa com ecossistema maduro, custo baixo e cadeia de suprimentos consolidada. Especializações (quântica pra criptografia, fotônica pra comunicação, neuromórfica pra IA específica) vão coexistir — não substituir.
Entender o silício não é hobby de hardware enthusiast — é leitura obrigatória pra quem leva código a sério. Cada otimização que você faz no seu software é, no fim das contas, uma conversa com bilhões de transistores trabalhando pra você. Fale a língua deles.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.