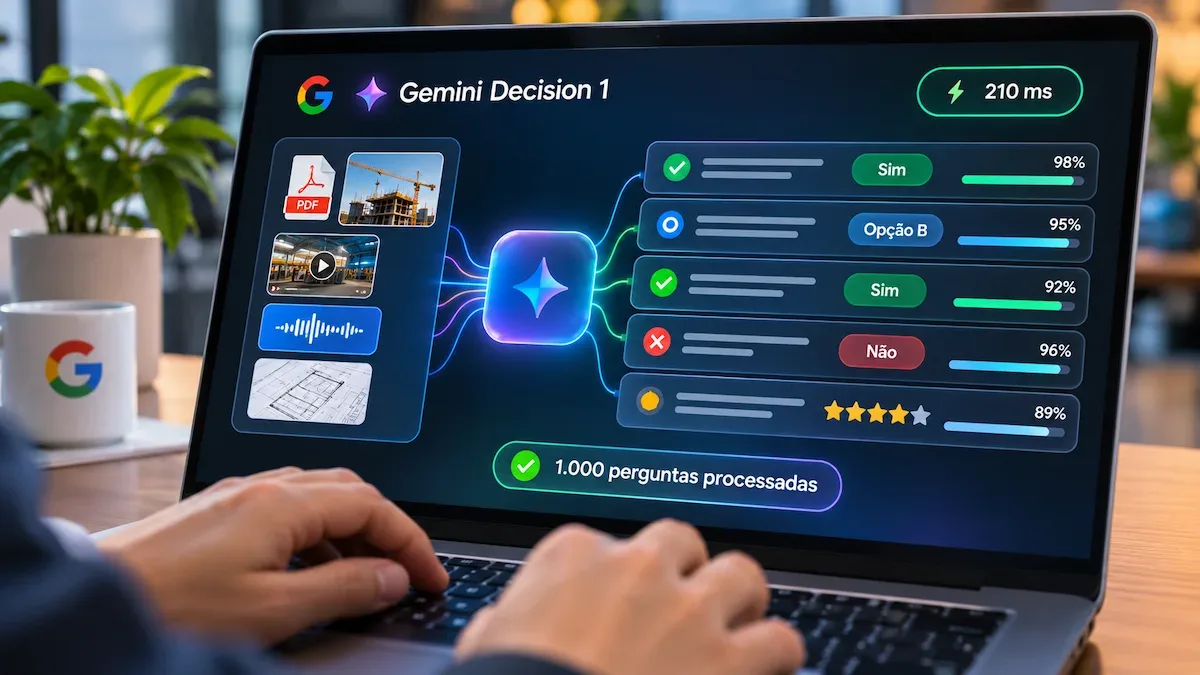
O ganho mais importante do Gemini Decision 1 não é escrever melhor: é evitar que um sistema gere um parágrafo inteiro quando precisa apenas escolher uma ação. Para quem constrói aplicações com IA, essa diferença pode reduzir latência, custo e complexidade — desde que o modelo seja usado no lugar certo e que a decisão continue sujeita a validações no código.
Segundo o Eurisko.com.br, o Google apresentou o Gemini Decision 1 em 11 de novembro de 2026, junto da Gemini Decisions API. A proposta é responder a perguntas fechadas e ajudar sistemas a selecionar o próximo passo. O material disponível, porém, não detalha endpoints, limites, preços, formatos de resposta ou garantias de latência. Eu não trataria nenhum desses pontos como confirmado sem consultar a documentação oficial.
O que é o Gemini Decision 1 e por que decisões rápidas importam
Modelos de linguagem generativa tradicionais produzem uma sequência de tokens. É uma abordagem flexível para conversar, resumir e programar, mas pode ser excessiva para tarefas como “a solicitação pode ser aprovada?”, “qual ferramenta deve ser chamada?” ou “qual categoria representa este caso?”.
Um modelo voltado a decisões promete concentrar o trabalho em uma saída estruturada: uma classe, uma opção ou uma ação entre alternativas. Em vez de pedir uma justificativa extensa, a aplicação pode solicitar uma escolha dentro de um conjunto permitido. Isso é especialmente útil em pipelines que precisam agir depois da inferência.
O benefício não é automático. Uma resposta mais curta não significa, por si só, menor latência total ou maior confiabilidade. O tempo de rede, a fila do serviço, o tamanho do contexto, as validações e as chamadas seguintes também contam. Eu mediria o sistema completo, não apenas o tempo informado pelo modelo.
Modelo de decisão, LLM generativo ou regras de negócio?
Eu escolheria a ferramenta pela natureza do problema, não pela novidade do produto. Há pelo menos três opções práticas, e elas não são intercambiáveis.
- Regras determinísticas: ideais quando a política é explícita e auditável. Se um usuário não tem permissão para acessar um recurso, uma regra no backend é mais previsível do que perguntar a um modelo.
- Classificador ou modelo de decisão: adequado quando a entrada é variável, mas a saída pertence a um conjunto limitado, como priorizar um ticket ou encaminhar uma solicitação.
- LLM generativo: indicado quando é preciso interpretar contexto amplo, produzir linguagem natural ou combinar informações sem uma lista pequena de respostas possíveis.
Na prática, uma aplicação pode combinar os três. O modelo classifica uma solicitação; regras verificam autorização e limites; um LLM maior só entra quando há ambiguidade ou necessidade de explicar o resultado. Esse desenho evita usar um modelo caro e flexível em toda requisição.
Onde uma API de decisões pode se encaixar
Vejo potencial em roteamento de ferramentas, triagem de suporte, classificação de documentos, priorização de filas e seleção entre fluxos de atendimento. Também pode ajudar um agente a escolher entre ações previamente definidas, desde que a aplicação controle o que cada ação realmente pode fazer.
O ponto crítico é separar decidir de executar. Um modelo pode recomendar “emitir reembolso”, mas não deve receber autoridade irrestrita para movimentar dinheiro. O backend precisa conferir identidade, valor, política vigente e idempotência antes de executar qualquer operação.
Na Prática: criando uma camada segura para decisões
Como os detalhes concretos da Gemini Decisions API não aparecem na referência, o exemplo abaixo não inventa um endpoint do Google. Ele mostra uma camada de aplicação funcional que chama um endpoint interno. Esse serviço interno pode ser conectado à API oficial depois que o formato real estiver confirmado na documentação.
A ideia é limitar as respostas aceitas, validar a saída no cliente e manter a autorização no servidor. O modelo não recebe permissão para executar a ação; ele apenas recomenda uma opção.
- Defina um conjunto pequeno de decisões válidas, como
billing,technicalehuman_review. - Envie apenas os dados necessários. Remova segredos e informações pessoais que não contribuam para a classificação.
- Valide a resposta recebida. Se vier um valor desconhecido, use um caminho seguro, como revisão humana.
- Meça latência, taxa de fallback e qualidade por categoria antes de ampliar o tráfego.
const ALLOWED_ROUTES = new Set([
  "billing",
  "technical",
  "human_review"
]);

async function chooseSupportRoute(message, requestId) {
  const response = await fetch("/api/decision", {
    method: "POST",
    headers: {
      "Content-Type": "application/json",
      "X-Request-Id": requestId
    },
    body: JSON.stringify({
      task: "classify_support_request",
      input: { message }
    }),
    signal: AbortSignal.timeout(1500)
  });

  if (!response.ok) {
    throw new Error(`Decision service returned ${response.status}`);
  }

  const result = await response.json();

  if (
    typeof result.route !== "string" ||
    !ALLOWED_ROUTES.has(result.route)
  ) {
    return {
      route: "human_review",
      reason: "invalid_or_unexpected_model_output"
    };
  }

  return {
    route: result.route,
    reason: "model_decision"
  };
}

async function handleSupportRequest(message, requestId) {
  try {
    const decision = await chooseSupportRoute(message, requestId);

    // A autorização e a execução continuam no backend.
    return await fetch("/api/support/route", {
      method: "POST",
      headers: {
        "Content-Type": "application/json",
        "X-Request-Id": requestId
      },
      body: JSON.stringify(decision)
    });
  } catch (error) {
    // Falha fechada: encaminha para revisão, em vez de inventar uma rota.
    return fetch("/api/support/route", {
      method: "POST",
      headers: {
        "Content-Type": "application/json",
        "X-Request-Id": requestId
      },
      body: JSON.stringify({
        route: "human_review",
        reason: "decision_service_unavailable"
      })
    });
  }
}
O timeout de 1,5 segundo é apenas um exemplo de política, não uma promessa de desempenho do Gemini Decision 1. Eu ajustaria esse limite com base no objetivo de latência do produto e em testes reais. Também instrumentaria a chamada com métricas, sem registrar o conteúdo sensível da mensagem por padrão.
Como avaliar latência, qualidade e custo
Antes de migrar um fluxo, eu montaria um conjunto de exemplos reais, anonimizados e rotulados por pessoas. A avaliação deve comparar o modelo atual, regras existentes e a nova abordagem. Acurácia geral pode esconder falhas graves: errar uma categoria rara de risco não equivale a errar uma categoria de baixo impacto.
Além da qualidade por classe, acompanharia percentis de latência, taxa de timeout, distribuição das decisões e proporção de encaminhamentos para revisão. Se a API retornar confiança ou metadados, só usaria esses sinais conforme a documentação e após verificar se são calibrados para o caso específico.
Para uma decisão de alto impacto, eu definiria limites conservadores e um fallback humano. Para uma tarefa reversível e de baixo risco, pode fazer sentido automatizar mais. O limiar adequado depende do custo de um falso positivo e de um falso negativo, não de uma preferência abstrata por automação.
Erros comuns ao adotar uma API de decisão
- Tratar o modelo como fonte de autorização: classificação não substitui controle de acesso, validação de política ou verificação de identidade.
- Esperar comportamento determinístico sem testar: respostas de modelos podem variar. Se a decisão precisa ser estritamente reproduzível, regras ou um classificador tradicional podem ser mais apropriados.
- Enviar contexto demais: dados irrelevantes aumentam custo, exposição de informações e, dependendo do sistema, podem confundir a decisão. Envie o mínimo necessário.
- Ignorar saídas inválidas e indisponibilidade: todo serviço externo precisa de timeout, tratamento de erro, fallback e limites de repetição. Retentar sem controle pode aumentar carga e duplicar operações.
- Medir apenas a média: a média pode parecer boa enquanto uma parcela de usuários enfrenta respostas lentas. Acompanhe p50, p95 e p99, além da latência ponta a ponta.
- Não versionar a tarefa: mudanças no prompt, nas classes ou no modelo podem alterar resultados. Registre versões e mantenha testes de regressão para casos representativos.
Eu também evitaria fazer uma cadeia de chamadas em que cada agente decide livremente qual ferramenta usar. Para fluxos críticos, enumere as ações possíveis, valide parâmetros em código e registre quem solicitou, qual decisão foi tomada e qual regra autorizou a execução.
O que muda para quem desenvolve agentes de IA
Uma API especializada em decisões pode tornar os agentes mais modulares. Um componente interpreta a solicitação, outro escolhe uma rota e um terceiro executa a ação após validação. Essa separação facilita testes e reduz o espaço de comportamento que cada parte precisa controlar.
Mas não assumiria que a API substitui function calling, classificadores convencionais ou orquestração. A comparação depende do formato de saída, das garantias, da integração com ferramentas e do custo real. Como a notícia não informa esses detalhes, a decisão de adoção deve esperar benchmarks e documentação oficiais.
Minha recomendação é começar com um fluxo estreito, reversível e mensurável. Faça uma execução em modo sombra: registre a recomendação do modelo, mas mantenha a decisão atual em produção. Compare os resultados e só então considere um rollout gradual, com botão de desligamento e monitoramento.
Perguntas frequentes sobre o Gemini Decision 1
O Gemini Decision 1 substitui modelos de linguagem generativos?
Não necessariamente. Pela proposta descrita pelo Eurisko.com.br, ele atende tarefas de decisão e respostas fechadas. Geração de texto, explicações e raciocínio apresentado em linguagem natural continuam sendo casos diferentes. A escolha depende do formato de saída necessário.
O Gemini Decision 1 garante respostas em milissegundos?
A manchete menciona decisões em milissegundos, mas a referência não apresenta medições, condições de teste ou percentis. Eu não usaria esse número como SLA sem consultar a documentação e medir a latência ponta a ponta na minha própria aplicação.
Posso usar o modelo para aprovar pagamentos ou permissões?
Eu não usaria uma recomendação do modelo como autorização final. O backend deve validar permissões, limites, política e integridade da operação. Para decisões de alto impacto, inclua revisão humana e mecanismos claros de auditoria e contestação.
Quando devo preferir regras tradicionais?
Quando a decisão pode ser descrita por condições explícitas, estáveis e auditáveis. Regras são mais simples de testar e reproduzir. Um modelo pode ajudar quando a entrada é linguagem variável ou ambígua, mas não deve substituir uma regra que já expressa corretamente a política do negócio.
Como começar a testar a Gemini Decisions API?
Confirme primeiro a documentação oficial: autenticação, esquema de requisição, limites, preços, disponibilidade regional e tratamento de dados. Depois, teste um caso de baixo risco com exemplos rotulados, fallback, métricas e comparação contra a solução existente.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.