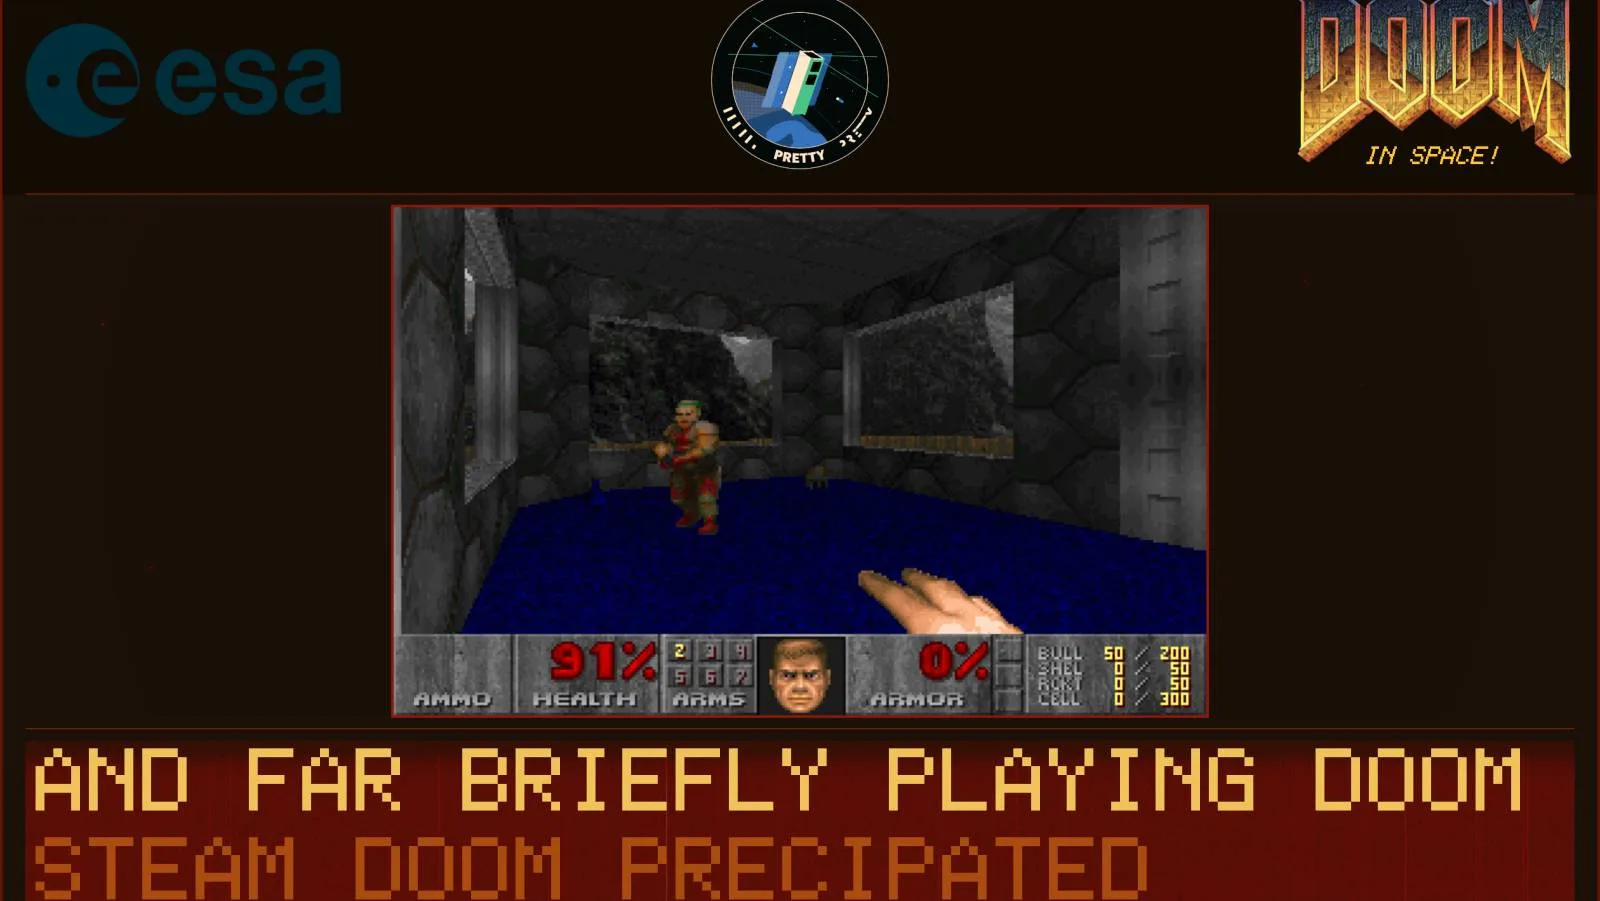
O feito mais interessante do satélite OPS-SAT PRETTY não é simplesmente rodar Doom: é transformar uma transmissão de voz em uma ação executada autonomamente em órbita, usando um modelo de reconhecimento de fala de apenas 27 MB. Para quem desenvolve sistemas embarcados, esse experimento expõe um desafio bem conhecido: como levar uma interface de linguagem natural para um dispositivo com pouca memória, conectividade limitada e tolerância quase zero a falhas?
Segundo o Hardware.com.br, a demonstração chamada PRETTY DOOMed aconteceu em 27 de julho de 2026 e envolveu a Tanagra Space e radioamadores. Durante uma passagem do satélite sobre Oslo, uma pessoa transmitiu por rádio uma instrução para iniciar Doom. O computador de bordo reconheceu o comando e acionou o jogo; depois, enviou imagens e registros técnicos à Terra.
Como o satélite reconheceu o comando de voz
O caminho técnico pode ser entendido como uma cadeia de processamento: recepção do sinal de rádio, extração do áudio, reconhecimento de fala, interpretação do texto e acionamento de uma ação local. O modelo de 27 MB cuidava do reconhecimento; ele não era responsável por executar Doom nem por compreender qualquer conversa de forma geral.
Essa distinção importa. Reconhecer fala é converter áudio em texto. Interpretar uma intenção é decidir o que aquele texto significa dentro da aplicação. São etapas diferentes, com riscos diferentes. Um sistema pode transcrever corretamente “play Doom” e ainda assim executar a ação errada se o código que trata o texto aceitar correspondências vagas.
A instrução transmitida incluía um prefixo de identificação em alfabeto fonético e a frase “PRETTY PLAY DOOM DOOM DOOM”. O prefixo ajuda a contextualizar a transmissão, mas não deve ser confundido com autenticação criptográfica. Ouvir um indicativo ou uma frase combinada não prova, por si só, quem está falando.
Por que usar um modelo de IA de 27 MB
Em um satélite, cada megabyte precisa justificar seu espaço. O computador de bordo tem limites de memória, processamento e energia, além de operar em um ambiente em que manutenção física não é uma opção. Um modelo pequeno reduz a pressão sobre esses recursos e pode funcionar sem depender de uma conexão contínua com um servidor na Terra.
Isso não significa que o sistema inteiro ocupe apenas 27 MB. Esse número se refere ao modelo de reconhecimento citado na cobertura. O runtime, os buffers de áudio, os filtros de sinal, o sistema operacional e o software de controle também consomem recursos. Na minha avaliação, tratar o tamanho do arquivo do modelo como uma medida completa de custo é um erro comum ao comparar soluções de IA embarcada.
Também vale separar três alternativas que às vezes aparecem misturadas:
- Reconhecimento de fala local: converte áudio em texto no próprio dispositivo. Dá flexibilidade para comandos variados, mas exige mais processamento e memória do que uma detecção simples.
- Detecção de palavras-chave: procura termos ou frases predefinidas, como “iniciar jogo”. Costuma ser mais leve, mas é menos flexível e ainda precisa lidar com ruído e falsos positivos.
- Reconhecimento em nuvem: envia o áudio a um serviço remoto. Pode oferecer modelos maiores, mas depende de conectividade, adiciona latência e cria questões de privacidade e disponibilidade.
Para um satélite, a nuvem não é uma substituição direta. A janela de comunicação com a estação terrestre é limitada, e o enlace pode não estar disponível no momento em que o sistema precisa decidir. Processar o áudio a bordo reduz essa dependência. Em contrapartida, obriga a equipe a escolher um modelo compatível com o hardware e a aceitar os limites de precisão dessa escolha.
O que o experimento ensina sobre IA embarcada
O reconhecimento teve dificuldades, e o resultado não veio de uma única tentativa. De acordo com o relato, foram feitas sete tentativas entre abril e julho. Na sexta, o comando funcionou com voz sintetizada; na sétima, a equipe repetiu o resultado com uma pessoa falando ao vivo.
Esse detalhe é mais útil do que uma demonstração perfeita em vídeo. Em produção, áudio muda com o microfone, o volume, o ruído de fundo, a pronúncia e a qualidade do canal. Uma voz sintetizada pode ser mais consistente, mas não representa necessariamente o comportamento de uma pessoa falando em condições reais. Repetir o teste com voz humana ajuda a verificar essa diferença, embora não prove que o sistema seja robusto para qualquer voz ou cenário.
Há ainda uma distinção importante entre “a IA executou Doom” e “a IA reconheceu uma instrução que acionou Doom”. Pelo que foi descrito, a segunda formulação é a mais precisa. O modelo interpretou áudio como texto; uma camada de software identificou o comando e chamou um programa que já estava disponível no satélite.
Na Prática: crie um interpretador seguro de comandos de voz
O princípio pode ser reproduzido em uma aplicação local sem instalar um modelo de fala: recebemos o texto produzido por um reconhecedor e passamos a transcrição por uma gramática restrita. O exemplo abaixo aceita a sequência “pretty play doom”, mesmo que haja um indicativo antes dela, e não dispara a ação apenas porque a palavra “doom” apareceu em qualquer lugar.
import re
import unicodedata

def normalizar(texto: str) -> list[str]:
    texto = unicodedata.normalize("NFKD", texto)
    texto = "".join(
        caractere for caractere in texto
        if not unicodedata.combining(caractere)
    )
    return re.findall(r"[a-z0-9]+", texto.lower())

def interpretar_comando(transcricao: str) -> str | None:
    tokens = normalizar(transcricao)
    comando = ["pretty", "play", "doom"]

    for inicio in range(len(tokens) - len(comando) + 1):
        if tokens[inicio:inicio + len(comando)] == comando:
            return "launch_doom"

    return None

def executar(transcricao: str) -> None:
    acao = interpretar_comando(transcricao)

    if acao == "launch_doom":
        print("Comando aceito: iniciar Doom")
        # Em um sistema real, chame uma função autorizada e isolada.
    else:
        print("Comando ignorado")

executar("LIMA ALFA FOUR OSCAR, PRETTY PLAY DOOM DOOM DOOM")
executar("Alguém comentou sobre Doom durante a transmissão")
O exemplo ilustra uma decisão deliberada: não usar uma busca simples como "doom" in transcricao. Essa regra dispararia o jogo ao ouvir qualquer conversa sobre o título. Uma gramática explícita reduz acionamentos acidentais, mas não substitui a validação da confiança do reconhecedor, a autorização da operação nem o controle de repetição.
- Defina um vocabulário pequeno. Comece com poucos comandos e evite tentar interpretar linguagem livre quando a tarefa só exige uma ação.
- Separe transcrição de execução. O componente de reconhecimento deve produzir um resultado; outro componente valida e autoriza a ação.
- Valide confiança e contexto. Se o modelo fornecer uma pontuação, estabeleça um limiar testado com dados reais. Não invente uma confiança quando o reconhecedor não a oferece.
- Registre o resultado. Guarde transcrição, decisão, horário e motivo da rejeição, respeitando as regras de privacidade aplicáveis.
- Tenha uma forma segura de falhar. Se o áudio estiver incompleto ou ambíguo, não execute a ação. Para funções críticas, exija uma confirmação adicional.
Erros comuns ao colocar reconhecimento de fala em produção
- Confundir tamanho do modelo com consumo total. Além dos pesos, conte runtime, memória temporária, entrada de áudio e custo de processamento. Faça medições no dispositivo-alvo, não apenas no computador de desenvolvimento.
- Tratar transcrição como autorização. Reconhecer uma frase não comprova identidade. Em aplicações sensíveis, use autenticação e autorização separadas; voz pode ser reproduzida ou sintetizada.
- Acionar por palavra isolada. Palavras podem aparecer em conversas, ruído interpretado como fala ou transcrições incorretas. Prefira uma intenção estruturada e uma sequência de confirmação adequada ao risco.
- Testar só com áudio limpo. Avalie sotaques, volume baixo, ruído, cortes no início da transmissão e variações do canal. O ambiente real quase nunca se parece com um conjunto de teste perfeito.
- Ignorar comportamento repetido. Um comando pode ser recebido mais de uma vez. Para ações que não devem duplicar, implemente idempotência, limite de frequência ou um estado que impeça a execução repetida.
- Escolher o modelo pela demonstração mais impressionante. A métrica relevante depende do uso. Para uma palavra-chave, falsos positivos podem ser mais perigosos do que uma pequena taxa de comandos não reconhecidos.
Essas recomendações se aplicam além de satélites. Em robôs offline, equipamentos industriais, dispositivos IoT e aplicações de acessibilidade, a arquitetura é parecida: captar um sinal imperfeito, extrair uma intenção limitada e executar uma ação com consequências. O cenário espacial apenas torna os custos de uma decisão ruim mais evidentes.
O que eu levaria desse teste para um projeto real
Eu começaria pela pergunta “qual é a menor interface que resolve o problema?”, não por “qual modelo de IA cabe no dispositivo?”. Se a aplicação precisa reconhecer duas ou três frases, uma solução de detecção de palavras-chave pode ser mais simples e previsível. Se precisa aceitar vocabulário variável, o reconhecimento de fala local pode fazer sentido, desde que o hardware sustente a latência e a precisão necessárias.
Também separaria a experiência demonstrativa da operação confiável. Iniciar um jogo é uma ação reversível e de baixo risco. Abrir uma válvula, alterar uma configuração ou comandar um veículo exige controles mais rigorosos: confirmação, permissões, limites de execução, logs e possibilidade de recuperação. A mesma técnica de reconhecimento não torna todas essas ações igualmente seguras.
O PRETTY DOOMed é interessante justamente por não precisar de uma IA gigantesca para mostrar uma ideia concreta. Um modelo compacto reconheceu um comando em um ambiente restrito, e um software local transformou essa saída em uma ação. Para quem programa, a lição não é colocar IA em tudo; é desenhar a menor cadeia de processamento que resolve o caso, medir suas falhas e impedir que uma interpretação incerta vire uma execução perigosa.
Perguntas frequentes
O satélite executou Doom usando inteligência artificial?
Não exatamente. Segundo as informações divulgadas, a IA reconheceu a fala e o software do satélite usou o comando identificado para iniciar o jogo. O modelo de 27 MB não foi descrito como responsável por executar Doom.
Por que o reconhecimento de fala foi feito a bordo?
O processamento local evita depender de uma conexão contínua com a Terra para interpretar o áudio. Isso é útil quando a comunicação ocorre em janelas limitadas, embora imponha restrições de memória, processamento e precisão.
Um modelo de 27 MB é suficiente para qualquer comando de voz?
Não. O tamanho do modelo não garante precisão nem define sozinho o que ele consegue reconhecer. O resultado depende do tipo de modelo, do vocabulário, do áudio, do hardware e dos testes realizados no cenário de uso.
Posso usar reconhecimento de voz como autenticação?
Não é recomendável tratar uma frase reconhecida como prova de identidade. Uma gravação ou voz sintetizada pode repetir o comando. Para operações sensíveis, autenticação, autorização e confirmação precisam ser projetadas separadamente.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.