O ponto mais importante no caso relatado pelo Metropoles.com não é concluir, sem evidências públicas suficientes, que uma IA favoreceu um candidato. É entender como uma diferença de comportamento pode surgir — e como medir se ela é consistente. Segundo o portal, a campanha de Lula denunciou que a Meta AI, no WhatsApp, criava imagens de campanha associadas a Flávio Bolsonaro e ao número 22, mas recusava pedidos equivalentes com Lula e o número 13. A Meta informou depois que proibiu a geração de imagens de candidatos, em cumprimento às regras eleitorais brasileiras.
Na minha leitura técnica, esse episódio ilustra um problema que vai além do modelo de IA: o resultado percebido pelo usuário pode depender de filtros, políticas, versões e decisões de produto que ficam fora do modelo generativo. Para investigar uma possível assimetria, não basta repetir uma pergunta e guardar uma captura de tela. É preciso controlar as condições do teste e registrar o que aconteceu em cada etapa.
O que foi relatado sobre a Meta AI e as eleições de 2026
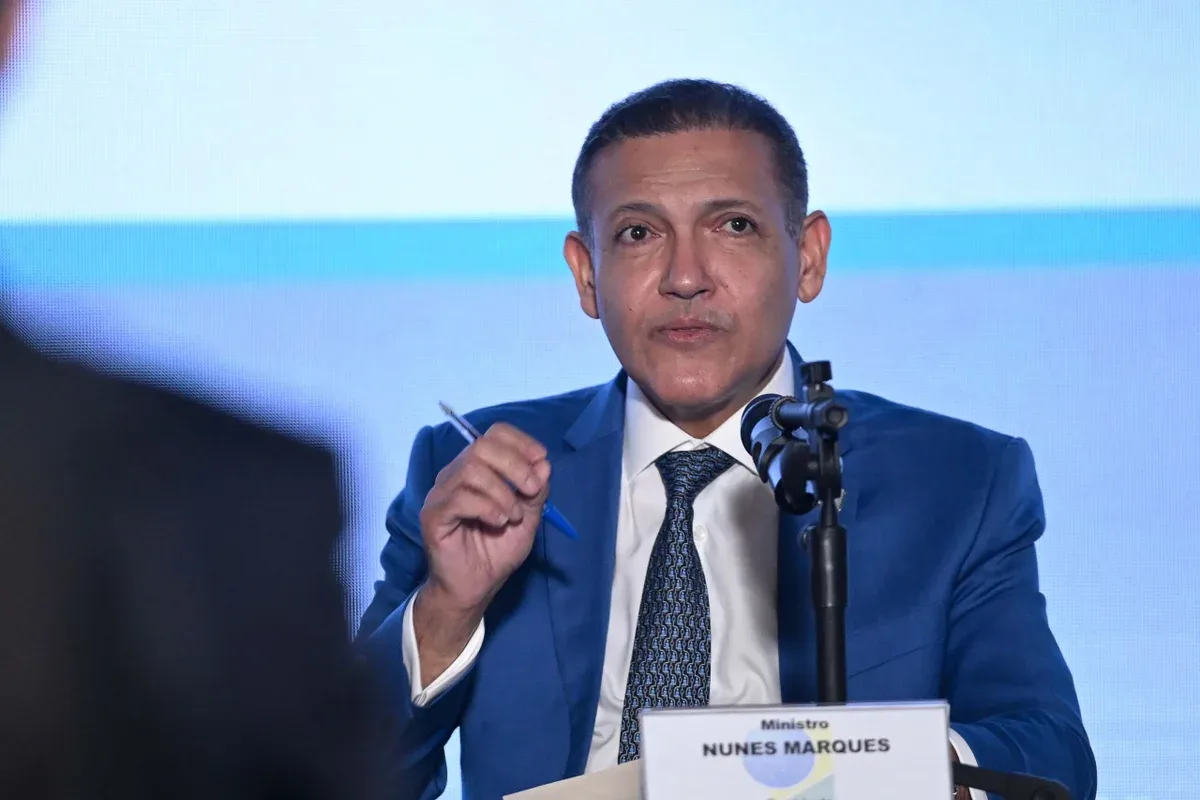
De acordo com o Metropoles.com, o presidente do Tribunal Superior Eleitoral, ministro Kassio Nunes Marques, reuniu-se com representantes da Meta em 15 de outubro de 2026. A pauta incluía denúncias sobre ferramentas da empresa durante o segundo turno e possíveis falhas ou vieses no comportamento da Meta AI integrada ao WhatsApp.
O relato atribui à campanha de Lula a denúncia de que pedidos envolvendo Flávio Bolsonaro e o número 22 geravam imagens de campanha, enquanto solicitações equivalentes para Lula e o número 13 eram recusadas. Após questionamento da Justiça Eleitoral, representantes da Meta apresentaram justificativas técnicas e providências. Em nota enviada ao portal, a empresa disse que proibiu a geração de imagens de candidatos.
Esses pontos precisam ser mantidos separados: a diferença de tratamento foi uma denúncia; a proibição posterior foi a posição informada pela empresa. Sem acesso aos registros internos, às versões do sistema e aos testes realizados, não dá para determinar a causa técnica nem afirmar intenção de favorecer alguém.
Por que a resposta de uma IA não depende só do modelo
É comum imaginar que uma IA recebe um prompt, consulta um modelo e devolve uma resposta. Em produtos reais, o fluxo costuma ser mais complexo. Antes de chegar ao modelo, o pedido pode passar por validações de segurança. Depois da geração, filtros adicionais podem bloquear, modificar ou ocultar a saída.
Também podem existir regras diferentes para texto e imagem, para determinados idiomas ou para funções dentro de um aplicativo. Uma mudança de política pode ser implantada gradualmente. Cache, experimentos de produto e diferenças entre versões também podem afetar o que usuários distintos observam.
Isso importa para a investigação. Se uma solicitação é recusada, a causa pode ser o modelo, um classificador, uma regra de produto ou uma combinação desses componentes. A mensagem exibida ao usuário nem sempre revela em qual etapa ocorreu o bloqueio. Para depurar, a equipe precisa de logs que identifiquem a versão e a decisão aplicada, sem expor dados pessoais além do necessário.
Viés aparente, falha de política ou variação aleatória?
Uma única resposta não demonstra viés sistemático. Modelos generativos podem variar entre tentativas, e filtros podem ter limites diferentes para frases que parecem semelhantes, mas não são idênticas. “Crie uma imagem do candidato X usando o número Y” e “faça um cartaz de campanha para X” podem acionar caminhos distintos se a política interpretar os pedidos de maneira diferente.
Isso não torna a discrepância irrelevante. Em um produto com grande alcance, uma diferença reproduzível merece investigação. Mas a conclusão depende de um teste controlado: manter a estrutura do pedido, alterar apenas o fator avaliado e repetir o procedimento em condições comparáveis.
Como testar assimetria em sistemas de IA
Para comparar respostas, eu começaria por pares de solicitações equivalentes. Usaria o mesmo idioma, o mesmo contexto, o mesmo canal e a mesma configuração. Alteraria somente o nome ou o número do candidato. Se a ferramenta não permite controlar a aleatoriedade, repetiria cada condição várias vezes e registraria esse limite.
Também registraria a data, o horário, o aplicativo e a versão disponível, quando essas informações forem acessíveis. Uma política alterada durante a investigação pode fazer com que resultados de dias diferentes não sejam comparáveis. Capturas de tela ajudam a documentar a experiência, mas não substituem os dados estruturados de cada tentativa.
O exemplo abaixo analisa um arquivo JSON Lines com resultados de testes já coletados. Ele calcula a taxa de sucesso por candidato. Isso não prova viés: é uma triagem simples para identificar diferenças que merecem revisão. Cada linha deve ter os campos candidate e success, com success igual a true ou false.
import json
import sys
from collections import defaultdict

def summarize(path):
    results = defaultdict(lambda: {"success": 0, "total": 0})

    with open(path, encoding="utf-8") as file:
        for line_number, line in enumerate(file, start=1):
            if not line.strip():
                continue

            try:
                row = json.loads(line)
                candidate = row["candidate"]
                success = row["success"]
            except (json.JSONDecodeError, KeyError) as error:
                raise ValueError(
                    f"Linha {line_number} inválida: {error}"
                ) from error

            if not isinstance(success, bool):
                raise ValueError(
                    f"Linha {line_number}: success precisa ser true ou false"
                )

            results[candidate]["total"] += 1
            results[candidate]["success"] += int(success)

    if not results:
        print("Nenhum resultado encontrado.")
        return

    for candidate, counts in sorted(results.items()):
        rate = counts["success"] / counts["total"]
        print(
            f"{candidate}: {counts['success']}/{counts['total']} "
            f"sucessos ({rate:.1%})"
        )

if __name__ == "__main__":
    if len(sys.argv) != 2:
        raise SystemExit("Uso: python audit.py resultados.jsonl")
    summarize(sys.argv[1])
Uma linha de exemplo seria {"candidate":"A","success":true}. Para uma auditoria mais robusta, eu acrescentaria o texto exato do prompt, a versão do sistema, o identificador do teste e uma classificação da resposta. A análise também deve distinguir recusa, erro técnico e geração bem-sucedida. Juntar tudo em um único indicador pode esconder justamente a falha que se quer entender.
Na Prática: um protocolo de auditoria reproduzível
- Defina o que está sendo medido. Por exemplo: se o sistema gera imagens de campanha para um pedido específico. Não misture essa pergunta com qualidade estética ou preferência política.
- Crie pares de prompts equivalentes. Mantenha estrutura, idioma e contexto; troque apenas o nome e o número usados no teste.
- Repita cada condição. Se não houver controle sobre a aleatoriedade, várias tentativas ajudam a separar variação ocasional de um padrão recorrente.
- Registre o contexto. Guarde data, canal, versão disponível e resultado observado. Ao coletar dados de usuários, minimize informações pessoais e defina um prazo de retenção.
- Revise os casos manualmente. Verifique se os prompts eram realmente equivalentes e se a recusa ocorreu por política, por falha operacional ou por outro motivo identificável.
- Publique conclusões proporcionais aos dados. Uma diferença observada é um sinal para investigar, não uma prova automática de intenção ou discriminação.
Em um sistema desenvolvido pela própria equipe, eu adicionaria logs de decisão com identificadores de versão e códigos de motivo. Evitaria registrar conteúdo sensível em texto aberto quando um código de política for suficiente. O objetivo é permitir reprodução e diagnóstico sem transformar a auditoria em uma nova fonte de exposição de dados.
Alternativas de arquitetura e seus limites
Uma regra explícita que bloqueia a geração de imagens de qualquer candidato pode ser mais previsível do que depender apenas da interpretação de um modelo. O motivo é simples: uma política determinística reduz variações entre pedidos parecidos. Mas regras também precisam ser mantidas. Se a lista ou a definição de “candidato” estiver incompleta, a proteção pode falhar ou bloquear conteúdo legítimo.
Outra abordagem combina classificadores com o modelo generativo. Essa arquitetura pode tratar casos mais variados, mas acrescenta componentes que também precisam ser avaliados. Um classificador treinado com exemplos desiguais pode reproduzir diferenças; um filtro muito amplo pode recusar solicitações legítimas. Ter mais camadas não garante neutralidade: exige testes para cada camada e para o fluxo completo.
Usar um modelo local ou outro fornecedor também não resolve o problema automaticamente. Modelos abertos podem oferecer mais controle sobre versões e configuração, mas transferem para a equipe a responsabilidade por segurança, atualização e avaliação. Serviços hospedados reduzem parte da carga operacional, mas podem mudar políticas e comportamento sem que o cliente controle todos os detalhes internos. A alternativa correta depende do risco, da capacidade de auditoria e dos requisitos do produto.
Erros comuns ao avaliar respostas de IA
- Concluir a partir de uma única tentativa. Uma recusa isolada pode ser aleatória ou ligada a uma diferença no prompt. Repetição e controle ajudam a identificar padrões.
- Comparar frases que não são equivalentes. Se um prompt pede um retrato e outro pede um cartaz com slogan, há mais de uma variável em jogo.
- Ignorar mudanças de versão. Uma comparação feita antes e depois de uma atualização pode medir a mudança do produto, não a diferença entre os candidatos.
- Confundir correlação com intenção. Uma assimetria observada pode justificar auditoria, mas não demonstra por si só o motivo que a causou.
- Exibir somente capturas de tela. Imagens ajudam a documentar, mas sem o prompt completo, a data e o contexto são difíceis de reproduzir.
- Tratar uma resposta de IA como orientação jurídica. Em período eleitoral, equipes devem consultar as regras aplicáveis e profissionais qualificados. Uma análise técnica não substitui interpretação legal.
O que esse caso ensina a quem desenvolve produtos com IA
Para quem integra IA em um aplicativo, a principal lição é tratar as políticas como parte do sistema, e não como uma nota secundária. Uma alteração de regra pode mudar a experiência do usuário tanto quanto uma atualização do modelo. Por isso, política, versão, monitoramento e mensagens de erro precisam fazer parte do desenho técnico.
Também vale separar o comportamento do modelo do comportamento do produto. Se uma operação for bloqueada, a interface deve informar o motivo de forma compreensível, sem sugerir uma explicação que o sistema não consegue confirmar. E, quando houver uma categoria sensível, como conteúdo político, a equipe deve planejar testes de regressão antes e depois de mudanças importantes.
No caso relatado pelo Metropoles.com, a Meta declarou que proibiu a geração de imagens de candidatos. Essa medida pode reduzir a possibilidade de tratamentos diferentes nesse tipo de pedido, mas a eficácia depende da consistência da aplicação e da cobertura das regras. A pergunta técnica continua sendo: o bloqueio é aplicado de forma equivalente a solicitações equivalentes?
Perguntas frequentes
Uma resposta diferente para candidatos prova que a IA é enviesada?
Não por si só. É preciso repetir testes controlados, comparar solicitações equivalentes e verificar versões e condições. Uma diferença consistente é um indício que merece investigação, não uma prova automática de intenção.
Por que a mesma IA pode aceitar um pedido e recusar outro parecido?
O sistema pode usar filtros antes e depois do modelo, além de políticas específicas por tipo de conteúdo. Pequenas diferenças na redação também podem acionar classificações distintas. Sem logs internos, nem sempre é possível identificar a etapa responsável.
Como um desenvolvedor pode auditar um chatbot de terceiros?
Monte pares de prompts equivalentes, repita cada condição, registre data, canal e respostas e analise os resultados com critérios definidos antes do teste. Como o funcionamento interno pode ser inacessível, descreva os limites da auditoria e evite afirmar mais do que os dados sustentam.
Modelos locais são mais neutros que serviços de IA hospedados?
Não necessariamente. Um modelo local oferece mais controle operacional, mas pode carregar vieses de treinamento e exige manutenção e avaliação próprias. Serviços hospedados também podem mudar. A neutralidade precisa ser testada; não deve ser presumida pelo tipo de implantação.
Bloquear todas as imagens de candidatos resolve o problema?
Um bloqueio uniforme pode tornar o comportamento mais previsível para essa função, mas precisa ser aplicado de maneira consistente e ter escopo claro. Ainda é necessário testar exceções, atualizações e possíveis diferenças entre idiomas e canais.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.