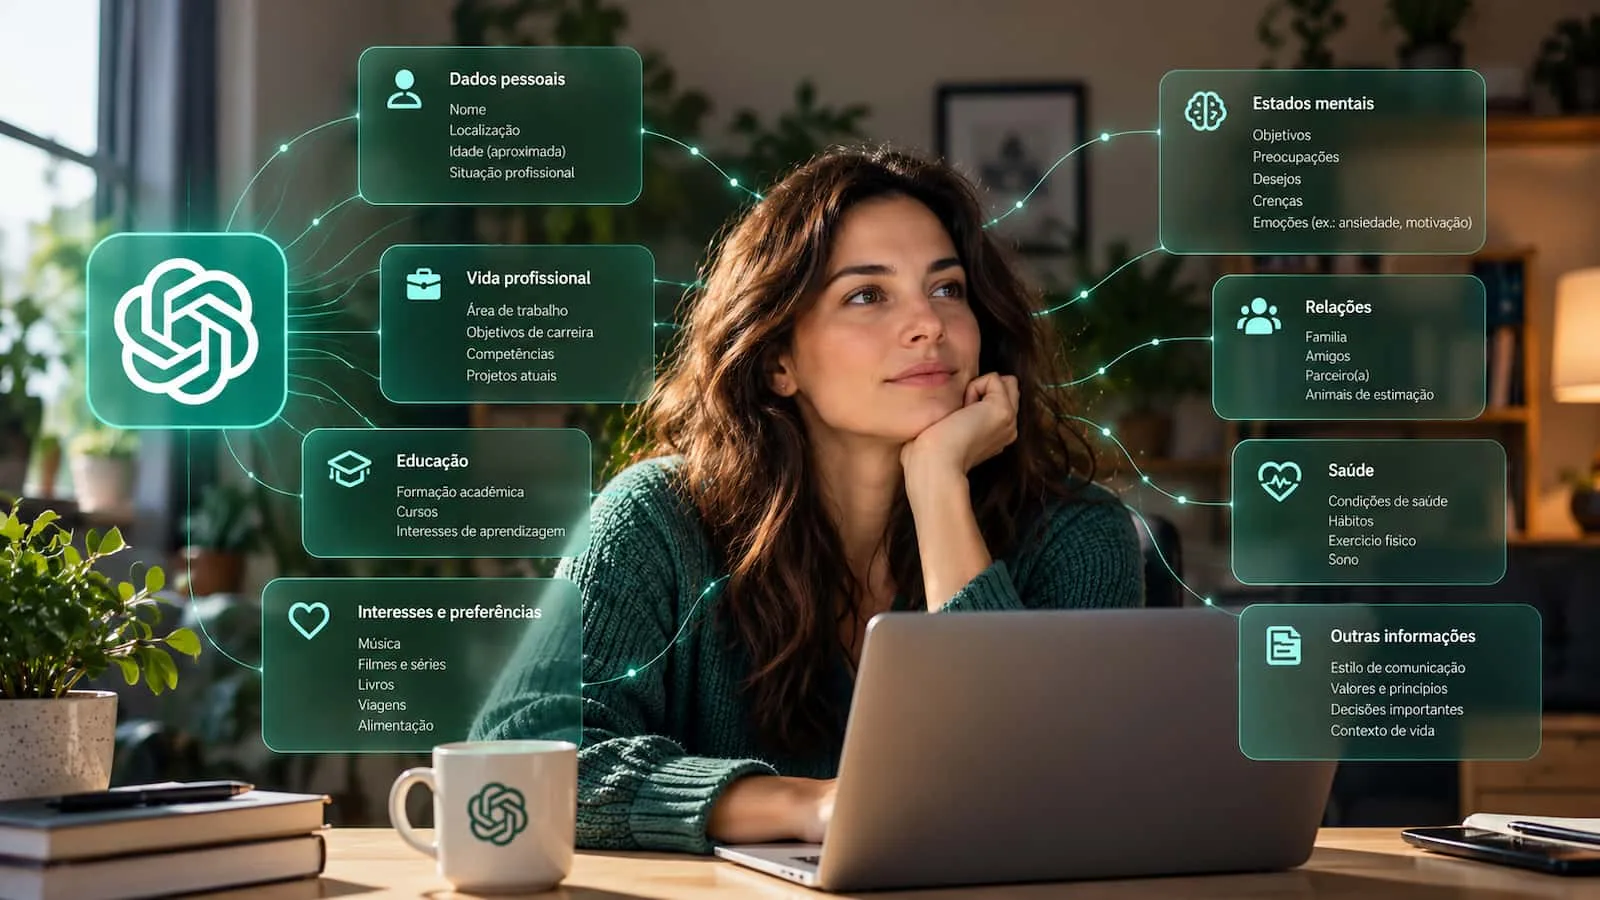
O ponto mais importante não é que o ChatGPT “leia a sua mente”, mas que conversas comuns podem acumular dados suficientes para formar um perfil útil — e, às vezes, surpreendentemente íntimo. Para quem programa, isso muda a forma de avaliar uma ferramenta de IA: além da qualidade da resposta, é preciso entender o que ela guarda, por quanto tempo e com que controles.
Segundo o Sapo.pt, um estudo apresentado na ACM Web Conference 2026 analisou memórias do ChatGPT e identificou informações pessoais e psicológicas entre os dados armazenados. O resultado merece atenção, mas também precisa ser interpretado com cuidado: memória do chatbot não é sinônimo de histórico completo, e a ausência de um pedido explícito para memorizar algo não prova que o utilizador desconhecia a funcionalidade.
O que o estudo sobre memória do ChatGPT encontrou
O trabalho, intitulado The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT, examinou históricos de 80 utilizadores obtidos por meio de pedidos de acesso a dados previstos no RGPD. Os investigadores identificaram 2.050 entradas de memória associadas a 65 participantes.
Segundo o resumo divulgado pelo Sapo.pt, em 96% dos casos os investigadores não encontraram nas mensagens uma instrução explícita para criar ou atualizar a memória. Isso indica que, na amostra analisada, a operação nem sempre vinha acompanhada de uma frase direta como “lembre-se disto”. Não permite concluir, por si só, que as pessoas não sabiam que a memória existia ou que não tinham ativado a funcionalidade.
O termo “autorretrato algorítmico” descreve o perfil que pode emergir dessas informações ao longo do uso. Uma conversa sobre uma linguagem de programação, uma preferência por respostas concisas e uma restrição alimentar podem parecer dados isolados. Reunidos, tornam-se sinais sobre hábitos, preferências e circunstâncias pessoais.
Memória, histórico e treinamento são coisas diferentes
Um erro comum é tratar toda forma de armazenamento como se fosse a mesma coisa. Na prática, vale separar pelo menos três conceitos: o conteúdo da conversa, as informações usadas para personalizar interações futuras e os dados que podem ser tratados conforme as configurações e políticas do serviço.
- Histórico de conversas: conversas que podem continuar visíveis na conta, conforme as opções disponíveis no produto.
- Memória: informações selecionadas para influenciar respostas futuras, como preferências ou contexto recorrente.
- Uso de dados para melhoria do serviço: tratamento que pode ter controles próprios, distintos das opções de memória.
Os nomes, comportamentos e opções variam conforme o produto, o plano e as atualizações. Por isso, não presumo que apagar uma conversa apague automaticamente uma memória relacionada, nem que desativar a memória altere todas as outras formas de tratamento de dados. A regra prática é conferir cada controle separadamente na interface e na documentação vigente.
Também não confundo memória com uma “base de dados secreta” que contém necessariamente tudo o que alguém escreveu. O estudo analisou entradas de memória específicas. Para entender o impacto, a pergunta correta é: que informação foi retida, como pode afetar respostas posteriores e quais meios existem para consultar ou remover esse registo?
Por que isso importa para desenvolvedores e equipes técnicas
Quando uso ferramentas de IA em tarefas de desenvolvimento, trato o contexto como parte da superfície de risco. Um prompt pode conter nomes de clientes, trechos de logs, URLs internas, detalhes de arquitetura, tokens acidentalmente copiados ou informações sobre incidentes. Mesmo quando a intenção é só depurar um erro, o material enviado pode revelar mais do que o necessário.
O risco não depende apenas de um dado isolado ser “sensível”. A combinação também importa. Uma sequência de conversas pode revelar stack tecnológico, rotinas de trabalho, projetos em andamento, preferências pessoais e problemas de saúde. Esse tipo de inferência é difícil de perceber quando cada mensagem parece inofensiva.
Em equipas, isso afeta também a governança. Um desenvolvedor pode usar uma conta pessoal para resumir um ticket; outro pode colar um log de produção; alguém da área de produto pode compartilhar feedback identificável. Sem uma regra clara, a ferramenta vira um canal informal para dados que deveriam permanecer em sistemas controlados.
Alternativas reais para reduzir a exposição
Não existe uma única opção ideal para todos os casos. Eu escolheria conforme a sensibilidade do trabalho e a necessidade de continuidade:
- Desativar ou revisar a memória: útil quando a personalização não compensa o risco. Confira também se há memórias já guardadas para gerir ou apagar.
- Usar uma conversa temporária, quando disponível: pode reduzir a persistência associada ao histórico ou à memória, mas não deve ser interpretada como garantia universal de ausência de retenção. Leia a descrição do recurso.
- Usar uma API sem estado de aplicação: a sua aplicação pode enviar apenas o contexto necessário em cada pedido. Isso ajuda a controlar o que entra no prompt, mas não significa automaticamente que o fornecedor não retenha dados; verifique os termos e as configurações aplicáveis.
- Executar um modelo local: oferece mais controle sobre o fluxo de dados, especialmente em ambientes isolados. Em contrapartida, exige capacidade de hardware, manutenção, atualização e avaliação de segurança.
- Aplicar uma camada de minimização: remover identificadores e dados desnecessários antes de enviar conteúdo, independentemente do fornecedor.
Na minha avaliação, a escolha não deve ser “nuvem ou local” como uma disputa ideológica. Para uma dúvida genérica de sintaxe, um serviço hospedado pode ser adequado. Para um incidente com dados de clientes ou código proprietário, eu reduziria o contexto, usaria um ambiente aprovado pela organização ou manteria o processamento dentro da infraestrutura controlada.
Na Prática: reduza dados antes de enviar um trecho
O exemplo abaixo mascara e-mails e números de telefone num texto antes de compartilhá-lo com uma ferramenta externa. É uma barreira simples para evitar vazamentos acidentais, não um mecanismo completo de anonimização: nomes, endereços, chaves, identificadores internos e dados sensíveis continuam a exigir tratamento específico.
import re

def reduzir_dados_pessoais(texto: str) -> str:
    # Substitui e-mails por um marcador genérico.
    texto = re.sub(
        r"\b[\w.+-]+@[\w.-]+\.[A-Za-z]{2,}\b",
        "[EMAIL]",
        texto
    )

    # Substitui sequências simples de telefone.
    # A expressão é deliberadamente conservadora e pode exigir ajustes
    # conforme os formatos usados no seu país ou sistema.
    texto = re.sub(
        r"(?
Eu não colocaria esse código em produção como única defesa. Expressões regulares não identificam todos os formatos e podem mascarar números que não são telefones. Para dados estruturados, prefiro validar campos na origem, remover o que não é necessário e manter uma lista explícita de elementos permitidos.
Um fluxo mais seguro para depuração é: reproduzir o erro com dados sintéticos, selecionar apenas as linhas relevantes, substituir identificadores por valores fictícios e revisar o prompt antes do envio. Se o erro depender de dados reais, a solução precisa passar pelas regras internas de segurança e privacidade da equipe.
Erros comuns ao usar IA com contexto pessoal ou código
- Colar logs completos: logs podem conter e-mails, IDs de sessão, endereços IP, tokens e payloads. Extraia só o trecho necessário.
- Assumir que “não pedi para guardar” significa “não ficou guardado”: o estudo mostra por que convém inspecionar as opções e os dados associados à conta, em vez de depender da memória do utilizador sobre cada conversa.
- Confundir apagar uma conversa com apagar todos os dados relacionados: confirme o efeito de cada ação na interface e na política do serviço.
- Enviar segredos para pedir uma revisão rápida: nunca compartilhe tokens, chaves privadas, credenciais ou dados de produção sem autorização e controles apropriados.
- Tratar uma regex como anonimização: mascarar e-mails não remove contexto identificável. Um nome de projeto ou uma combinação de detalhes pode continuar a identificar uma pessoa.
- Usar a mesma conta para tudo: separar ambientes pessoais e profissionais pode ajudar na gestão, mas não substitui uma política de dados nem a revisão das configurações.
Como avaliar a memória de um chatbot sem cair em conclusões precipitadas
Eu começaria por três perguntas. Primeiro: que tipos de informação o produto diz que pode guardar? Segundo: como consultar, corrigir ou apagar essas informações? Terceiro: que controles tratam separadamente o histórico, a memória e o uso de dados para melhoria do serviço?
Depois, testaria o comportamento com dados fictícios. Por exemplo, pediria que a ferramenta lembrasse uma preferência não sensível e verificaria se essa informação influencia outra conversa. Em seguida, analisaria os controles de gestão e exclusão. Esse teste ajuda a compreender a interface, mas não substitui a leitura das políticas nem permite inferir o tratamento de todos os dados da conta.
Para organizações, eu documentaria quais categorias de informação podem ser enviadas, quais ferramentas estão aprovadas e o que fazer em caso de exposição acidental. Essa orientação precisa ser concreta: “não envie dados pessoais de clientes” funciona melhor quando acompanhada de exemplos de logs, tickets, código e prompts que devem ser sanitizados.
FAQ sobre memória do ChatGPT e privacidade
O ChatGPT guarda tudo o que escrevo?
Não é correto concluir isso a partir do estudo. A pesquisa analisou entradas de memória, não demonstrou que cada conversa se transforma numa memória. Histórico, memória e outros tratamentos de dados são conceitos distintos; consulte as opções atuais do produto.
Se eu não pedir para memorizar algo, o sistema não pode guardar?
O estudo identificou que, em 96% dos casos analisados, os investigadores não encontraram um pedido explícito nas mensagens para criar ou atualizar a memória. Isso não esclarece, sozinho, o que cada participante sabia sobre a funcionalidade nem descreve todos os casos de uso.
Desativar a memória apaga as informações já guardadas?
Não presuma que desativar e apagar sejam a mesma ação. Verifique a área de gestão de memória e as instruções atuais do serviço para remover dados existentes e entender o efeito de cada controle.
Posso enviar código privado para uma IA?
Depende das regras da sua organização, do serviço usado e da sensibilidade do código. Antes de enviar, remova segredos e dados identificáveis. Para repositórios proprietários ou incidentes de produção, use apenas ferramentas e configurações aprovadas pela equipe.
Um modelo local elimina o risco de privacidade?
Reduz a dependência de um serviço externo, mas não elimina todos os riscos. Ainda é preciso proteger logs, dispositivos, acessos, backups e integrações, além de avaliar as condições de uso e a origem do modelo.
Para mim, a lição prática é simples: conveniência não deve substituir minimização de dados. A memória pode tornar um assistente mais útil, mas cada informação persistente precisa ter uma finalidade clara e controles compreensíveis. Se programamos sistemas para outras pessoas, devemos aplicar a mesma disciplina aos dados que fornecemos às ferramentas que usamos para programar.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.