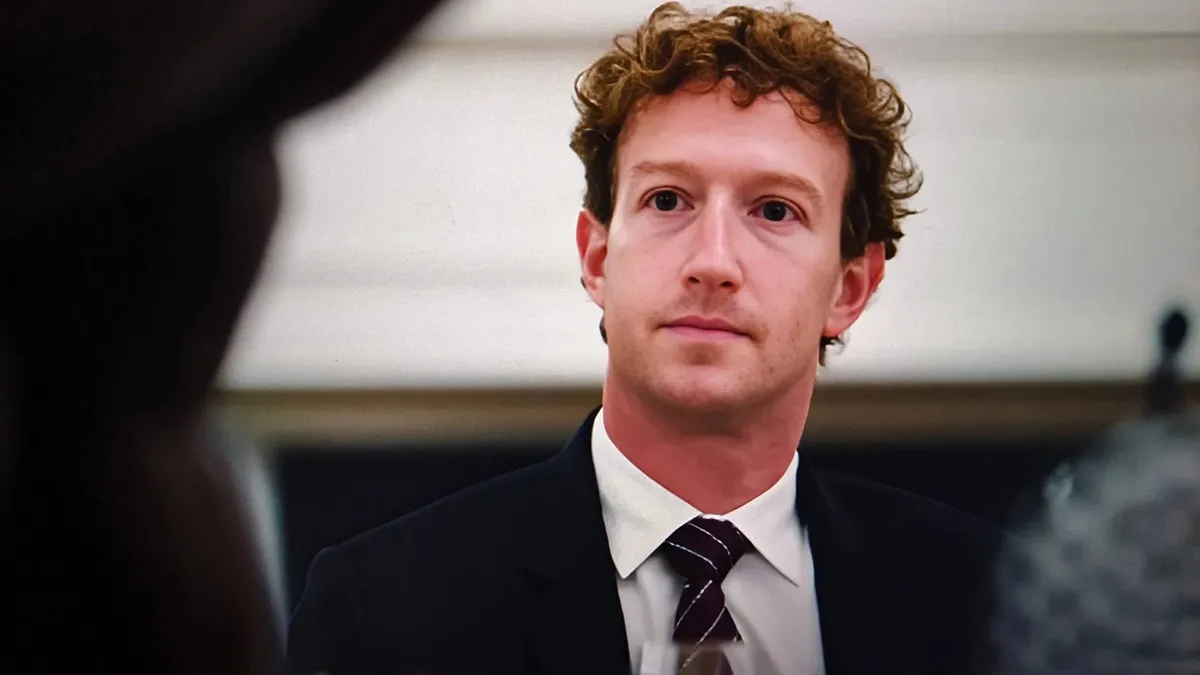
Uma reunião entre Trump e executivos de Meta, Anthropic, Google, Nvidia e OpenAI não muda, por si só, a forma como desenvolvemos software. Mas revela onde decisões sobre IA podem ser influenciadas: infraestrutura, energia, regulação e acesso a recursos públicos. Para quem constrói produtos com modelos de linguagem, o ponto prático é reduzir a dependência de um único fornecedor e acompanhar políticas que podem afetar custos e disponibilidade.
Segundo o Olhardigital.com.br, Mark Zuckerberg, Dario Amodei, Sundar Pichai, Jensen Huang e Greg Brockman estavam entre os nomes esperados no almoço com Donald Trump e o presidente da Câmara dos Representantes, Mike Johnson. O encontro fazia parte de um evento da Casa Branca com painéis sobre IA, energia e espaço, além da apresentação de um novo site para reunir recursos federais.
O que a reunião entre Trump e as big techs pode sinalizar
O grupo representa partes diferentes da cadeia de IA. A Nvidia fornece aceleradores usados para treinar e executar modelos; Google, Meta, Anthropic e OpenAI desenvolvem modelos, serviços ou plataformas; e a relação entre essas empresas inclui tanto competição quanto dependência de infraestrutura. Reunir esses executivos com autoridades não é apenas uma conversa sobre produtos: é também uma oportunidade para discutir condições de operação do setor.
Isso não significa que uma política específica tenha sido aprovada ou que o encontro tenha definido contratos. Os detalhes citados na reportagem se baseiam, em parte, em fontes ouvidas sob condição de anonimato. Eu separaria, portanto, o fato da reunião das interpretações sobre seus possíveis efeitos. O evento mostra acesso direto entre governo e empresas; não prova, sozinho, qual será o resultado regulatório.
Para desenvolvedores, essa distinção importa. Uma notícia sobre encontro político não deve ser tratada como anúncio de mudança imediata em APIs, preços ou regras. Mas é um sinal para acompanhar temas que podem chegar ao nosso trabalho por caminhos indiretos: exigências de segurança, regras para uso de dados, restrições de exportação de chips, incentivos a data centers e critérios de contratação pública.
Por que energia e chips também são assuntos de software
Executar modelos grandes exige mais do que bons algoritmos. A capacidade disponível depende de aceleradores, memória, rede, data centers e energia elétrica. Se a oferta de GPUs fica restrita ou o custo de operação aumenta, o efeito pode aparecer como filas maiores, limites de uso, mudança de preços ou dificuldade para escalar uma funcionalidade.
A Nvidia, liderada por Jensen Huang, ocupa uma posição importante nessa infraestrutura. Isso não quer dizer que todo produto de IA precise de uma GPU Nvidia própria. A maioria das equipes consome modelos por API ou por serviços de nuvem, nos quais o provedor administra o hardware. Ainda assim, o custo e a disponibilidade do hardware influenciam o preço e a capacidade desses serviços.
Também existem alternativas, mas cada uma traz compromissos. É possível usar APIs de diferentes fornecedores, executar modelos de pesos abertos em infraestrutura própria ou combinar as duas abordagens. APIs reduzem o trabalho operacional, mas criam dependência de preço, limites e formato de interface. Hospedar modelos dá mais controle sobre dados e configuração, mas exige capacidade técnica para avaliar hardware, segurança, latência e manutenção.
O impacto para quem integra modelos de IA
Na prática, a consequência mais útil dessa notícia não é apostar em qual empresa terá mais influência. É projetar sistemas que possam suportar mudanças. Quando um recurso central depende de uma API externa, o fornecedor se torna parte da arquitetura: uma alteração de preço, indisponibilidade ou regra de uso pode virar um incidente no produto.
Uma camada de abstração ajuda, desde que não seja apenas um nome genérico em volta de uma chamada específica. Provedores diferem em autenticação, formatos de mensagem, ferramentas, limites de contexto, comportamento de streaming e recursos multimodais. Esconder essas diferenças sem documentá-las costuma gerar uma integração difícil de depurar.
Eu prefiro definir uma interface interna pequena e explícita, medir o desempenho por tarefa e manter testes de compatibilidade. A aplicação pode encaminhar cada tipo de solicitação para uma configuração permitida, sem espalhar nomes de modelos pelo código de negócio. Isso não elimina o trabalho de adaptar provedores, mas reduz o custo de fazer a troca.
Exemplo: roteamento controlado por tarefa
O exemplo abaixo mostra uma estratégia simples em JavaScript. Ele seleciona configurações de um conjunto permitido e rejeita tarefas desconhecidas. A função não chama diretamente um fornecedor; ela entrega a decisão a uma camada de integração própria, que deve normalizar as APIs e tratar autenticação, erros e limites.
const modelRoutes = {
  "resumo-curto": {
    provider: "provider-a",
    model: "fast-model"
  },
  "analise-complexa": {
    provider: "provider-b",
    model: "reasoning-model"
  }
};

function selectModel(task) {
  const route = modelRoutes[task];

  if (!route) {
    throw new Error(`Tarefa não permitida: ${task}`);
  }

  return route;
}

async function generateText({ task, input }) {
  const route = selectModel(task);

  const response = await fetch("/api/ai/generate", {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({
      provider: route.provider,
      model: route.model,
      input
    })
  });

  if (!response.ok) {
    throw new Error(`Falha na geração: HTTP ${response.status}`);
  }

  return response.json();
}
O endpoint interno /api/ai/generate deve validar novamente os valores no servidor. Não confie em uma seleção feita apenas no navegador: o cliente pode ser alterado. No backend, mantenha credenciais fora do código-fonte, aplique limites por usuário e registre métricas como latência, custo estimado, taxa de erro e modelo usado.
O motivo para separar a seleção do acesso à API é operacional. Se um modelo ficar indisponível, a equipe pode alterar uma rota controlada e observar os resultados sem editar cada chamada espalhada pela aplicação. Mas uma troca não deve ser automática sem avaliação: respostas diferentes podem quebrar extração estruturada, classificações e fluxos que dependem de comportamento consistente.
Na Prática: como reduzir dependência de um único provedor
- Liste as funções de IA do produto. Separe, por exemplo, resumo, busca semântica, geração de código e análise de documentos. Cada tarefa tem requisitos diferentes de latência, precisão e custo.
- Defina métricas antes de comparar modelos. Meça qualidade com exemplos representativos, tempo de resposta, taxa de falha e custo por solicitação. Uma resposta convincente em uma demonstração não garante bom desempenho no seu conjunto de dados.
- Implemente um adaptador no servidor. Centralize autenticação, conversão de formatos, tratamento de erros e limites. Evite chamadas diretas ao fornecedor em componentes de interface.
- Crie uma rota alternativa testada. Mantenha pelo menos uma opção compatível com os requisitos essenciais. Faça testes periódicos; uma alternativa nunca exercitada não é um plano de contingência confiável.
- Revise dados e contratos. Verifique retenção, uso para treinamento, localização de processamento e obrigações aplicáveis ao seu setor. A política do provedor pode mudar, e sua equipe precisa saber quais dados pode enviar.
Erros comuns ao acompanhar a disputa por IA
- Tratar proximidade política como garantia comercial. Uma reunião não confirma parceria, subsídio, contrato ou mudança regulatória. Espere documentos e anúncios verificáveis antes de alterar um plano técnico.
- Escolher modelo apenas por benchmark público. Resultados gerais podem não refletir seus idiomas, formatos de entrada ou casos extremos. Teste com dados que representem o uso real, sem expor informações sensíveis.
- Confundir compatibilidade de API com equivalência. Dois provedores podem aceitar estruturas parecidas e ainda produzir resultados, erros e custos diferentes. Use testes de contrato e validação de saída.
- Ignorar custo de operação indireto. O preço por token não inclui necessariamente tentativas, chamadas de ferramentas, armazenamento, observabilidade e revisão humana. Calcule o custo por tarefa concluída.
- Fazer fallback sem preservar o contexto. Uma alternativa pode ter limites menores ou suporte distinto a ferramentas. Se a troca ocorrer durante uma solicitação, valide o tamanho do contexto e o formato antes de reenviar dados.
Anthropic, Meta, Google, OpenAI e Nvidia: papéis diferentes
Os nomes no encontro não são intercambiáveis. Anthropic e OpenAI são associadas ao desenvolvimento de modelos e serviços de IA; Google combina pesquisa, modelos, nuvem e produtos; Meta desenvolve modelos e os integra ao seu ecossistema; Nvidia fornece hardware e software para computação acelerada. Comparar essas empresas exige olhar para a tarefa concreta, não apenas para anúncios ou rankings.
A reportagem também destaca a presença de Tom Brown, cofundador da Anthropic e diretor de computação da empresa. A participação de Amodei ganhou atenção porque ele ficou fora do jantar de Estado da semana anterior, durante a visita do presidente chinês Xi Jinping, mas teve um jantar privado com Trump no domingo. Segundo uma pessoa familiarizada com a visita, foi o primeiro encontro individual entre os dois.
Para mim, o aspecto técnico mais relevante é a interseção entre computação e política industrial. Decisões sobre fornecimento de chips, construção de data centers e acesso a energia podem afetar a infraestrutura na qual os serviços de IA são executados. Isso pode chegar ao desenvolvedor como alteração de preço, região disponível, limite de requisições ou requisitos de conformidade, sem que seja necessário mudar imediatamente uma linha de código.
O que acompanhar depois do evento
Eu acompanharia anúncios oficiais sobre o site federal mencionado, a programação de IA e energia e qualquer documento que detalhe medidas concretas. Também observaria mudanças publicadas pelos fornecedores: termos de uso, regiões atendidas, limites de API, preços e políticas de retenção. São esses registros que permitem distinguir uma consequência real de uma leitura especulativa do encontro.
Para equipes de engenharia, a resposta sensata é preparar opções sem reescrever a arquitetura por causa de uma manchete. Uma interface interna bem definida, testes de avaliação próprios, telemetria e controle de custos melhoram a resiliência independentemente de qual empresa ganhe espaço político ou comercial.
FAQ: reunião de Trump com executivos de tecnologia
A reunião muda imediatamente o acesso às APIs de IA?
Não há indicação disso na reportagem. O encontro, por si só, não anuncia mudanças de API. Para confirmar alterações, consulte a documentação e os comunicados oficiais de cada fornecedor.
Por que desenvolvedores deveriam acompanhar reuniões sobre energia e chips?
Modelos de IA dependem de data centers, aceleradores e energia. Mudanças nesses custos ou na disponibilidade de infraestrutura podem afetar preços, capacidade e regiões atendidas pelos serviços que sua aplicação consome.
Vale a pena integrar vários provedores de modelos?
Depende do risco e do valor da aplicação. Para uma função crítica, uma alternativa testada pode reduzir dependência. Para um protótipo simples, manter vários fornecedores pode adicionar complexidade sem benefício proporcional.
Usar um modelo de pesos abertos elimina dependência de empresas?
Não completamente. Pode reduzir a dependência de uma API específica, mas ainda exige infraestrutura, manutenção, atualizações, segurança e avaliação. A equipe troca parte da dependência comercial por responsabilidade operacional.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.