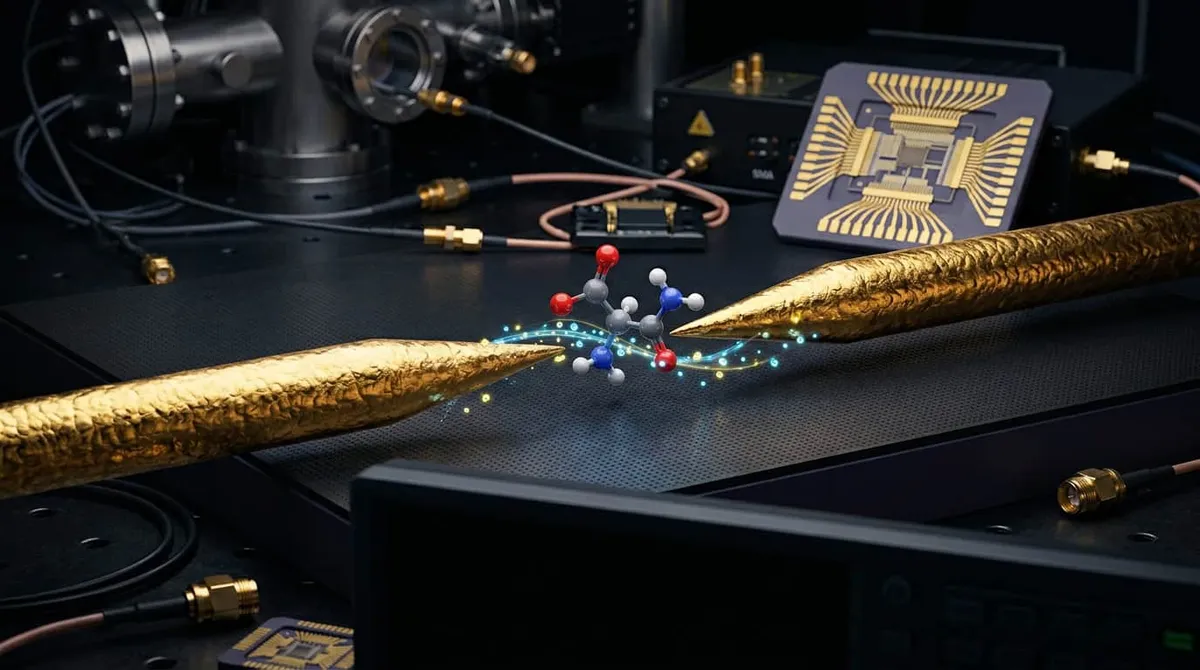
Detectar vida fora da Terra não depende apenas de encontrar água ou moléculas orgânicas: também é preciso descobrir se essas moléculas surgiram por processos biológicos. Um estudo da Universidade de Osaka, divulgado pelo Olhardigital.com.br, explora uma forma de fazer essa distinção medindo sinais elétricos de moléculas individuais e usando inteligência artificial para interpretar os dados.
O ponto técnico que me chama atenção é a combinação de duas escalas: um sensor nanométrico transforma a passagem de uma molécula em uma corrente minúscula, e um modelo computacional procura padrões nessa corrente. A ideia é promissora, mas há uma diferença importante entre classificar um sinal em laboratório e demonstrar que ele é uma biossinatura confiável em uma missão espacial.
Quiralidade dos aminoácidos: por que a forma L pode ser uma pista de vida
Aminoácidos são moléculas que participam da formação das proteínas. Muitos existem em duas configurações espaciais espelhadas, chamadas L e D. Elas têm os mesmos átomos e ligações, mas não são sobreponíveis — uma comparação simples é a relação entre a mão direita e a esquerda.
Na vida terrestre, quase todos os aminoácidos usados na construção de proteínas estão na forma L. Em contrapartida, reações químicas sem influência biológica tendem a produzir as duas formas em proporções mais equilibradas. Por isso, um excesso de L ou D pode ser um indício interessante de atividade biológica.
“Indício” é a palavra central. Uma proporção desigual não prova, por si só, que houve vida. Processos não biológicos também podem gerar assimetrias, e uma amostra pode sofrer alterações depois de formada. A quiralidade é uma possível biossinatura, não um veredito automático.
Como a corrente de tunelamento pode identificar moléculas
Segundo o Olhardigital.com.br, a técnica usa dois nanofios de ouro separados por um espaço muito pequeno. Os fios não precisam encostar: em determinadas condições, elétrons atravessam a abertura por tunelamento quântico e produzem uma corrente elétrica extremamente baixa.
Quando uma molécula passa pela região entre os eletrodos, ela pode alterar características do sinal, como sua intensidade e variação ao longo do tempo. A equipe analisa esses sinais com inteligência artificial para distinguir padrões associados às formas L e D. Em vez de observar somente uma mistura inteira, a abordagem procura extrair informação de eventos moleculares individuais.
Essa mudança de escala é relevante. Uma medição convencional pode fornecer a composição média de uma amostra. Um sensor que registra eventos individuais tem potencial para revelar distribuições mais detalhadas, desde que consiga separar o sinal molecular de ruído, interferências e variações do próprio instrumento.
O artigo de referência informa que a equipe testou a abordagem com material do meteorito Murchison e solo do deserto do Atacama, no Chile, e obteve resultados comparáveis aos de métodos tradicionais. Isso é um passo experimental importante, mas não significa que o sistema já esteja pronto para procurar vida em outro planeta. Desempenho em amostras de laboratório e operação autônoma em uma missão são desafios diferentes.
IA em sensores moleculares: o que o modelo realmente aprende
Um modelo de aprendizado de máquina não “reconhece vida” em sentido amplo. Ele aprende a relacionar dados de entrada a categorias definidas durante o treinamento. Neste caso, a tarefa descrita é mais específica: encontrar padrões elétricos que ajudem a distinguir formas de moléculas ou características associadas a elas.
Esse detalhe muda a forma de avaliar o resultado. Se o modelo foi treinado com amostras preparadas em condições controladas, ele pode aprender diferenças que não se repetem em uma amostra desconhecida. A validação precisa testar cenários variados, como diferentes concentrações, temperaturas, níveis de contaminação e lotes de fabricação do sensor.
Também é essencial separar os dados corretamente. Se medições quase idênticas da mesma amostra aparecerem tanto no treino quanto no teste, a métrica pode parecer ótima sem provar que o modelo generaliza. Em projetos científicos, dividir os dados por amostra, lote ou sessão experimental costuma ser mais informativo do que embaralhar registros individuais.
Comparação com métodos tradicionais de análise
| Método | O que oferece | Principal cuidado |
|---|---|---|
| Cromatografia e espectrometria de massa | Separação e identificação de componentes químicos; técnicas acopladas podem analisar quiralidade. | Instrumentação, preparo da amostra e interpretação podem ser complexos. |
| Espectroscopia de dicroísmo circular | Investiga diferenças de absorção associadas a estruturas quirais. | Misturas complexas e baixas concentrações podem dificultar a leitura. |
| Sensor de tunelamento | Busca converter interações moleculares em sinais elétricos de eventos individuais. | Exige controle rigoroso do sensor e validação robusta do classificador. |
Não existe um vencedor universal nessa comparação. Métodos tradicionais têm décadas de desenvolvimento e são úteis como referência independente. Sensores elétricos podem oferecer uma estratégia complementar, possivelmente compacta e sensível, mas precisam demonstrar reprodutibilidade e resistência a interferências antes de substituir qualquer técnica consolidada.
Na Prática: como eu estruturaria um classificador para sinais moleculares
O código abaixo é um exemplo didático de organização de um pipeline de classificação. Ele cria dados artificiais para demonstrar o fluxo: separar treino e teste, normalizar as variáveis e medir o desempenho. Os valores não vêm do estudo de Osaka, não representam medições reais e não servem para identificar aminoácidos.
- Defina as entradas: use características extraídas de sinais reais, com documentação de como cada uma foi calculada.
- Separe por amostra ou lote: evite que registros da mesma origem vazem entre treino e teste.
- Compare com uma referência: avalie o modelo contra métodos químicos independentes, não apenas contra outro classificador.
- Relate incerteza: acurácia isolada esconde falsos positivos e o efeito de classes desbalanceadas.
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

# Demonstração com dados artificiais, não são medições experimentais.
rng = np.random.default_rng(42)
n = 1000

# Cada linha representa um evento; as colunas são atributos simulados
# de um sinal elétrico. A relação com o rótulo foi inventada para o exemplo.
y = rng.integers(0, 2, size=n)  # 0 = classe L; 1 = classe D
X = rng.normal(size=(n, 4))
X[:, 0] += y * 0.8
X[:, 1] -= y * 0.4

X_treino, X_teste, y_treino, y_teste = train_test_split(
    X, y, test_size=0.25, random_state=42, stratify=y
)

modelo = make_pipeline(
    StandardScaler(),
    LogisticRegression(max_iter=1000, class_weight="balanced")
)
modelo.fit(X_treino, y_treino)

previsoes = modelo.predict(X_teste)
print(classification_report(y_teste, previsoes, target_names=["L", "D"]))
Na prática, eu não aceitaria esse resultado como evidência de biossinatura. Para começar, os dados precisam vir de experimentos rotulados com método independente. Depois, eu avaliaria sensibilidade, especificidade, matriz de confusão e calibração das probabilidades. Se a aplicação priorizar evitar falsos positivos — um requisito razoável ao alegar possível vida extraterrestre — o limiar de decisão precisa refletir esse custo.
Erros comuns ao aplicar IA à detecção de biossinaturas
- Confundir correlação com origem biológica: o modelo pode separar duas condições de laboratório sem identificar a causa química da diferença.
- Usar acurácia como única métrica: em conjuntos desbalanceados, um classificador pode parecer eficiente enquanto falha justamente na classe rara.
- Ignorar deriva do sensor: mudanças no eletrodo, temperatura ou protocolo podem alterar o sinal e degradar o modelo depois do treinamento.
- Fazer divisão aleatória inadequada: separar eventos do mesmo lote entre treino e teste pode inflar o desempenho reportado.
- Tratar o resultado como prova: uma classificação indica semelhança com padrões aprendidos; a interpretação científica exige controles e confirmação independente.
Para quem desenvolve sistemas de análise científica, a lição prática é separar claramente três camadas: aquisição do sinal, extração de atributos e decisão do modelo. Essa arquitetura facilita auditoria, comparação de algoritmos e atualização do classificador sem esconder problemas de hardware dentro de uma única caixa-preta.
O que ainda falta para levar esse sensor ao espaço
Um instrumento destinado a uma missão espacial precisa operar com energia limitada, suportar vibração e variações térmicas e analisar amostras sem a infraestrutura de um laboratório terrestre. Também precisa lidar com contaminação: moléculas terrestres podem comprometer a interpretação de uma amostra extraterrestre antes mesmo de o algoritmo entrar em ação.
Além disso, uma missão teria de demonstrar que o sensor responde de forma consistente a concentrações baixas e a misturas desconhecidas. O sistema também precisaria registrar controles, parâmetros e incertezas para que cientistas pudessem revisar a conclusão depois. A compactação do hardware é importante, mas não substitui a validação científica.
Perguntas frequentes sobre corrente elétrica e busca por vida
A técnica já encontrou vida extraterrestre?
Não. O trabalho descrito desenvolve e testa um método de análise molecular. Os testes citados com meteorito e solo terrestre não são uma detecção de vida fora da Terra.
Por que a proporção entre aminoácidos L e D importa?
Na vida terrestre, os aminoácidos usados nas proteínas são predominantemente da forma L, enquanto processos não biológicos tendem a produzir proporções mais equilibradas. Essa assimetria pode ser uma pista, mas não é prova isolada de vida.
A inteligência artificial decide se uma amostra está viva?
Não por conta própria. O modelo classifica padrões nos dados para os quais foi treinado. A interpretação depende de controles experimentais, validação e confirmação por métodos independentes.
Esse método substitui cromatografia ou espectrometria de massa?
Com as informações disponíveis, é mais prudente tratá-lo como uma abordagem complementar. Métodos tradicionais continuam importantes para confirmar a composição e comparar resultados.
O que desenvolvedores podem aprender com esse estudo?
Que a qualidade do dado e o desenho da validação são tão importantes quanto o algoritmo. Em aplicações científicas, separar amostras corretamente e explicitar incertezas evita conclusões fortes demais a partir de métricas frágeis.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.