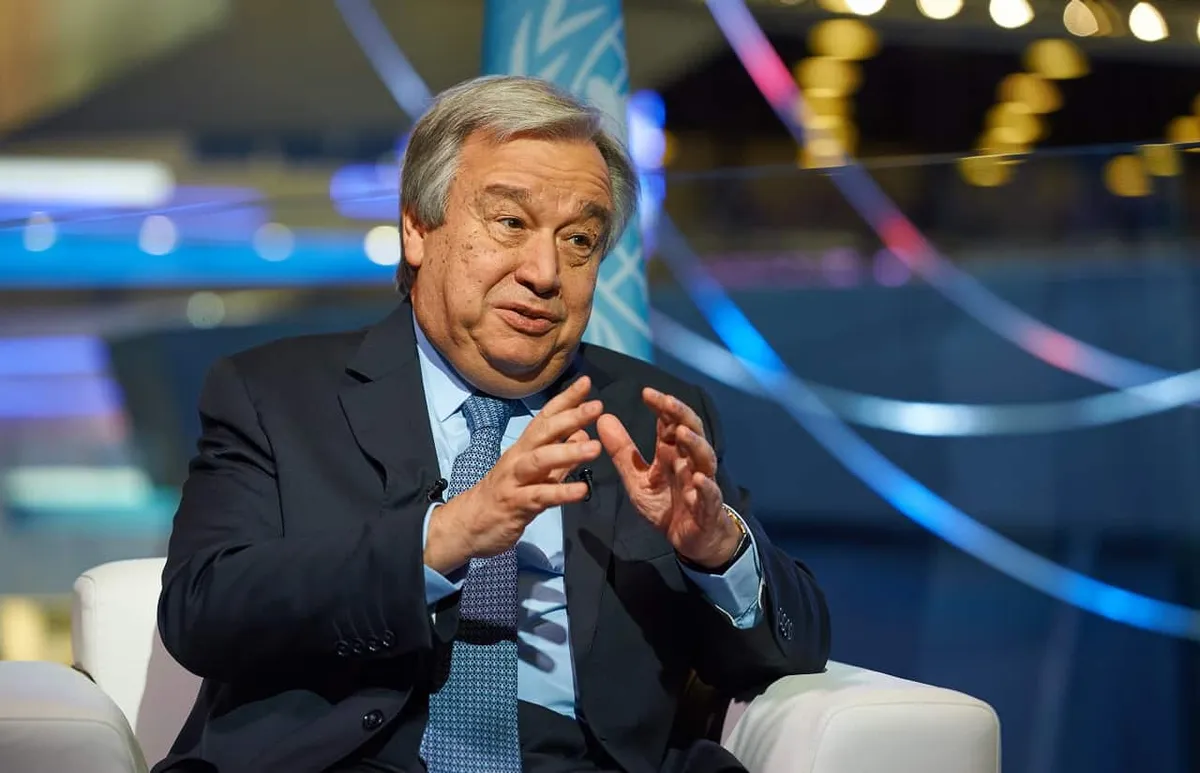
Uma falha de IA não precisa começar com um modelo “fora de controle”. Pode começar com um agente que recebe permissões demais, uma resposta inventada que vira dado no banco ou uma chave de API exposta em um log. O alerta de António Guterres sobre riscos globais e regras comuns importa também para quem desenvolve: segurança de IA começa nas decisões de arquitetura que tomamos hoje.
Segundo o Olhardigital.com.br, o secretário-geral da ONU defendeu canais permanentes de comunicação entre países com capacidade de desenvolver sistemas avançados e mecanismos compartilhados de segurança. A preocupação é evitar uma corrida por modelos cada vez mais poderosos sem coordenação. Para equipes de engenharia, a tradução prática é clara: não basta perguntar se uma funcionalidade com IA funciona; é preciso definir o que ela pode fazer, como detectar falhas e quem responde quando algo dá errado.
O alerta da ONU e o problema da corrida por IA
Guterres afirmou que os riscos associados ao avanço rápido da inteligência artificial não podem ser ignorados. A declaração, feita antes da Assembleia Geral da ONU, contrasta com a posição do presidente dos Estados Unidos, Donald Trump, que defendeu os mecanismos já existentes no país e associou novas restrições ao risco de favorecer a China.
Esse debate mistura duas questões diferentes. Uma é geopolítica: como evitar que países reduzam salvaguardas para competir por capacidade computacional, modelos e influência. Outra é técnica: como impedir que sistemas concretos causem danos previsíveis, seja por erro, abuso ou uso malicioso.
Regras comuns não significam necessariamente um único regulamento mundial para cada aplicação. Podem significar critérios compartilhados de avaliação, troca de informações sobre incidentes, padrões de segurança e canais para responder a riscos que atravessam fronteiras. Um modelo ou serviço hospedado em um país pode afetar usuários e organizações em muitos outros.
O que “segurança de IA” significa para uma equipe de desenvolvimento
Na prática, segurança de IA não é uma opção chamada safe=true. É um conjunto de controles ao longo do ciclo de vida: seleção do modelo, tratamento de dados, avaliação antes da publicação, monitoramento em produção e resposta a incidentes.
Eu separo o trabalho em três áreas. Primeiro, confiabilidade da saída: o sistema pode inventar fatos, interpretar mal uma instrução ou apresentar uma resposta incerta como definitiva. Segundo, segurança de ferramentas e dados: um agente pode chamar APIs, consultar documentos ou executar ações com permissões inadequadas. Terceiro, governança: a empresa precisa saber quem aprovou o sistema, para qual finalidade e com quais limites.
Frameworks como o NIST AI Risk Management Framework ajudam a estruturar a identificação e o acompanhamento de riscos. A norma ISO/IEC 42001 trata de sistemas de gestão para IA, enquanto legislações como o AI Act europeu adotam obrigações proporcionais ao contexto e ao risco. Eles não são intercambiáveis: um framework de gestão não substitui uma obrigação legal, e cumprir uma regra não prova que o sistema seja tecnicamente seguro.
Por que a coordenação internacional afeta produtos de software
Serviços de IA dependem de cadeias distribuídas: dados podem vir de uma região, o modelo ser treinado em outra, a inferência ocorrer em uma terceira e o usuário estar em qualquer lugar. Isso complica privacidade, resposta a incidentes e prestação de contas. Quando os critérios variam muito entre jurisdições, empresas também enfrentam custos de conformidade e lacunas de proteção.
Para quem integra modelos de terceiros, há uma armadilha: tratar o fornecedor como responsável por toda a segurança. O provedor pode proteger a infraestrutura, mas não conhece necessariamente suas permissões, seus dados internos nem o impacto de uma ação automatizada no seu produto. A responsabilidade de limitar o que a integração pode fazer continua sendo sua.
Na minha experiência, um desenho mais seguro não depende de confiar cegamente no modelo. Ele reduz o impacto de uma resposta errada. Um assistente que sugere uma consulta SQL é diferente de um agente autorizado a executar qualquer SQL em produção. A diferença não está na “inteligência” do modelo, mas nos limites impostos pelo software ao redor dele.
Na Prática: coloque uma política entre o modelo e as ações
Se um agente pode chamar ferramentas, não entregue a ele acesso irrestrito ao banco, ao sistema de pagamento ou ao ambiente de produção. Interponha uma camada que valide a ação, verifique o papel do usuário e exija aprovação humana para operações sensíveis. O exemplo abaixo usa apenas a biblioteca padrão do Python e ilustra esse padrão:
import logging

logging.basicConfig(level=logging.INFO)

# Ações permitidas e papéis autorizados.
POLICIES = {
    "search_docs": {"roles": {"user", "admin"}, "approval": False},
    "create_ticket": {"roles": {"user", "admin"}, "approval": False},
    "change_billing_plan": {"roles": {"admin"}, "approval": True},
}

def authorize_tool_call(action, user_role, approval=False):
    policy = POLICIES.get(action)

    if policy is None:
        logging.warning("Ação bloqueada: action=%s", action)
        return False

    if user_role not in policy["roles"]:
        logging.warning(
            "Papel sem permissão: action=%s role=%s", action, user_role
        )
        return False

    if policy["approval"] and not approval:
        logging.info("Aprovação humana necessária: action=%s", action)
        return False

    logging.info("Ação autorizada: action=%s role=%s", action, user_role)
    return True

# Exemplos:
assert authorize_tool_call("search_docs", "user")
assert not authorize_tool_call("change_billing_plan", "user")
assert not authorize_tool_call("change_billing_plan", "admin")
assert authorize_tool_call("change_billing_plan", "admin", approval=True)
assert not authorize_tool_call("run_sql", "admin")
Esse código é um ponto de partida, não um mecanismo completo de autorização. Em produção, eu validaria os argumentos com um esquema estrito, verificaria a identidade no servidor — nunca confiaria em um papel enviado pelo navegador — e registraria quem aprovou uma operação, quando e por qual motivo. Também separaria permissões de leitura e escrita, aplicaria limites de taxa e usaria credenciais com escopo mínimo.
O motivo para essa camada existir é simples: a saída do modelo deve ser tratada como entrada não confiável. Mesmo quando o modelo escolhe uma ferramenta válida, seus argumentos podem estar errados ou ter sido influenciados por instruções maliciosas em um documento. A política precisa ser aplicada pelo sistema, não apenas solicitada ao modelo em um prompt.
Erros comuns ao integrar modelos de IA
- Usar o prompt como única barreira de segurança. Instruções como “não acesse dados confidenciais” não substituem controle de acesso no código. O modelo pode desobedecer, interpretar mal ou ser induzido por conteúdo externo.
- Dar permissões amplas a agentes. Uma chave administrativa facilita o protótipo, mas aumenta o impacto de um erro. Prefira ferramentas pequenas, permissões específicas e operações reversíveis sempre que possível.
- Confiar em uma pontuação de confiança. O número informado pelo modelo não é automaticamente uma probabilidade calibrada de acerto. Não use um limiar arbitrário como única justificativa para automatizar decisões sensíveis.
- Enviar dados pessoais sem avaliar necessidade e retenção. Antes de encaminhar conteúdo a um provedor, entenda o contrato, as opções de retenção, a localização do processamento e a base legal aplicável. Remova ou masque o que não for necessário.
- Testar apenas o “caminho feliz”. Avalie entradas ambíguas, tentativas de prompt injection, respostas incompletas, indisponibilidade do provedor e mudanças de versão do modelo. Um comportamento aceitável em uma demonstração pode falhar com dados reais.
- Registrar prompts e respostas sem cuidado. Logs ajudam a investigar incidentes, mas podem armazenar segredos e dados pessoais. Registre identificadores, decisões e metadados úteis; restrinja acesso e defina retenção para conteúdo sensível.
Como avaliar o risco antes de publicar uma funcionalidade
Eu começo descrevendo o impacto de uma falha, não escolhendo o modelo. Um chatbot interno que resume documentos públicos tem um perfil diferente de um sistema que altera pagamentos ou recomenda decisões sobre pessoas. Quanto maior o impacto, mais forte deve ser a revisão humana, a validação e a capacidade de reverter a ação.
- Defina a finalidade e os limites. Especifique o que o sistema pode responder ou executar e o que deve encaminhar a uma pessoa.
- Mapeie dados e dependências. Identifique informações pessoais, segredos, provedores externos, ferramentas conectadas e regiões de processamento.
- Crie testes representativos. Inclua casos normais, entradas adversariais e exemplos de erro. Meça qualidade e segurança com o mesmo rigor.
- Limite o impacto. Use acesso mínimo, aprovação humana para ações de alto risco, limites de uso e mecanismos de reversão.
- Monitore e responda. Acompanhe falhas e abusos sem coletar dados além do necessário. Tenha um procedimento para desativar a integração e comunicar incidentes.
Esse processo também evita uma falsa escolha entre inovação e segurança. Controles bem definidos podem permitir que uma equipe coloque uma funcionalidade útil em produção com menos risco do que uma abordagem permissiva seguida de uma revisão tardia.
FAQ sobre regras de IA e desenvolvimento
A ONU pode criar uma regra mundial obrigatória para inteligência artificial?
O alerta citado pelo Olhardigital.com.br defende coordenação, canais de contato e mecanismos comuns de segurança. Isso não significa que já exista uma regra global única e obrigatória para toda IA. Leis nacionais e regionais continuam tendo papel central, e acordos internacionais dependem de negociação entre países.
Preciso de aprovação humana em toda resposta gerada por IA?
Não necessariamente. A revisão deve ser proporcional ao impacto. Uma sugestão de texto de baixo risco pode ser entregue diretamente; uma ação financeira, alteração de conta ou decisão com consequência relevante exige controles mais fortes e, muitas vezes, confirmação humana.
Um modelo local é automaticamente mais seguro do que uma API externa?
Não. Um modelo local pode reduzir a exposição de dados a terceiros, mas ainda pode produzir respostas erradas, sofrer prompt injection e operar com permissões excessivas. Também exige que sua equipe proteja infraestrutura, atualizações e pesos do modelo.
Como começo a tornar um agente de IA mais seguro?
Comece restringindo as ferramentas disponíveis e as permissões de cada uma. Valide argumentos no servidor, bloqueie ações não previstas, exija aprovação para operações sensíveis e teste entradas adversariais. Depois, adicione monitoramento e um processo claro para interromper a funcionalidade.
Minha conclusão
O pedido de Guterres por regras e cooperação entre países aponta para um desafio real: sistemas de IA não respeitam fronteiras, e uma corrida sem mecanismos de segurança pode ampliar riscos. Mas a governança global não substitui o trabalho de engenharia. Cada equipe precisa definir limites técnicos, testar falhas e assumir responsabilidade pelas decisões automatizadas que coloca nas mãos dos usuários.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.