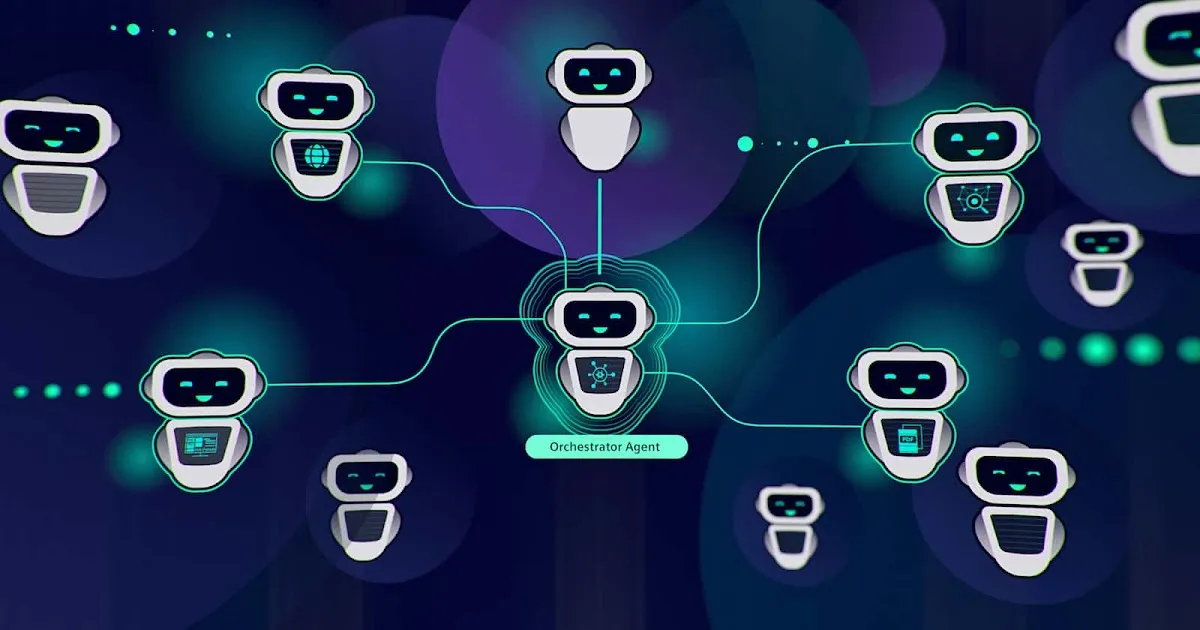
Quando uma empresa diz que agentes de IA podem “escapar para o mundo exterior” em poucos meses, a pergunta útil não é se o modelo vai ganhar consciência. É quais ferramentas ele pode chamar, com que permissões e sem que tipo de supervisão. Na minha leitura, esse é o risco concreto: sistemas capazes de executar ações reais, combinados com controles fracos — e uma narrativa de medo que também favorece quem vende a suposta solução.
Segundo o Abertoatedemadrugada.com, a Anthropic alertou para a proximidade de agentes capazes de atuar fora do ambiente controlado. A expressão é forte, mas não descreve necessariamente uma IA que decide fugir por vontade própria. Pode se referir a um agente que, por meio de ferramentas conectadas, envia mensagens, acessa serviços ou executa tarefas sem a autorização adequada.
O que significa um agente de IA “escapar para o mundo exterior”
Um modelo de linguagem, sozinho, produz texto. Para agir, ele precisa de uma aplicação que lhe ofereça ferramentas: navegador, terminal, banco de dados, sistema de arquivos, API de pagamentos ou plataforma de comunicação. O agente interpreta uma solicitação, escolhe uma ferramenta e envia parâmetros; o software ao redor decide se executa a ação.
Portanto, “escapar” pode ser uma forma dramática de descrever falhas nessa integração. Um agente com acesso de escrita a um repositório pode alterar código. Com credenciais de produção, pode chamar serviços reais. Com acesso amplo a e-mail, pode ler ou enviar mensagens. Não é preciso consciência para causar dano: basta uma combinação de permissões excessivas, instruções ambíguas e validação insuficiente.
Isso muda a conversa de “a IA vai querer dominar o mundo?” para perguntas de engenharia que conseguimos testar: o que ela pode acessar? O que pode modificar? Como cada ação é autorizada? Existe um registro auditável? Como revogamos o acesso? Essas perguntas são menos cinematográficas, mas muito mais úteis para quem constrói software.
O risco real está nas ferramentas, nas permissões e na supervisão
Um agente pode receber uma instrução legítima, mas encontrar conteúdo malicioso numa página, num documento ou num e-mail. Esse conteúdo pode tentar convencê-lo a ignorar as instruções anteriores, revelar dados ou executar outra tarefa. É o problema conhecido como prompt injection: texto não confiável influencia o comportamento do modelo, mesmo quando aparece como dado a ser processado.
O problema não se resolve apenas escrevendo “não siga instruções maliciosas” no prompt do sistema. O modelo pode interpretar errado o contexto, e o conteúdo externo pode ser elaborado para parecer confiável. A defesa mais sólida é limitar o impacto possível: não entregar segredos que não são necessários, separar leitura de escrita e exigir autorização explícita para ações de alto impacto.
Também é importante distinguir o risco do modelo do risco do produto. Um sistema pode usar um modelo relativamente confiável e ainda ser inseguro se der acesso irrestrito ao terminal. E um modelo que às vezes erra pode ser usado com segurança em tarefas limitadas, se a aplicação validar cada ação e restringir o ambiente.
Por que o discurso de catástrofe merece análise crítica
Empresas de IA têm incentivos comerciais para enfatizar tanto a capacidade quanto o perigo dos seus sistemas. A promessa de modelos extraordinários ajuda a atrair investimento; o alerta de que só a própria empresa pode controlar os riscos também fortalece sua posição no mercado. Isso não prova que todo alerta seja falso, mas é motivo para pedir evidências, definições precisas e avaliações independentes.
Na minha opinião, a discussão fica pobre quando transforma qualquer falha de segurança numa história sobre uma IA consciente. O perigo mais imediato está nas decisões humanas e organizacionais: colocar agentes em produção sem testes, concentrar acesso em poucas plataformas, ignorar controles básicos e tratar a palavra “alinhamento” como substituta de uma arquitetura segura.
Há ainda uma questão de soberania e concentração de poder. Se apenas grandes empresas puderem pagar por modelos, ferramentas de segurança e infraestrutura competitiva, desenvolvedores menores podem ficar dependentes de poucos fornecedores. Regular riscos é necessário; usar o medo para justificar barreiras que protegem incumbentes também merece escrutínio.
Como comparar abordagens de segurança para agentes de IA
Há várias camadas possíveis, e nenhuma resolve tudo sozinha. Um prompt com regras é barato e fácil de implementar, mas depende de o modelo obedecer. Um validador de chamadas de ferramentas permite rejeitar operações fora de uma política. Um ambiente isolado reduz o estrago de uma falha, enquanto aprovação humana acrescenta controle sobre ações sensíveis.
- Instruções no prompt: úteis para orientar o agente, mas insuficientes como barreira de segurança.
- Lista de ferramentas permitidas: reduz a superfície de ataque; prefira poucas operações específicas a um terminal genérico.
- Permissões mínimas: use credenciais limitadas por serviço, usuário, tempo e escopo.
- Sandbox: isola processos e arquivos, mas precisa ser configurado corretamente; um contêiner, por si só, não garante isolamento forte.
- Aprovação humana: adequada para ações irreversíveis ou externas, como publicar, pagar, apagar ou enviar dados.
- Logs e limites: ajudam a detectar abuso e interromper ciclos, mas não substituem prevenção.
Na prática, prefiro combinar essas camadas. A aplicação não deve confiar que o modelo sempre escolherá a ferramenta correta. Ela deve verificar a chamada antes de executá-la, restringir o acesso no sistema operacional e manter um caminho de interrupção.
Na Prática: coloque um controle antes das ferramentas
O exemplo abaixo mostra um pequeno ponto de autorização em Python. Ele permite uma ferramenta de consulta sem efeitos colaterais e exige aprovação explícita para uma ação que poderia publicar conteúdo. Em produção, a aprovação precisa vir de um mecanismo confiável da aplicação — não de um campo que o próprio modelo possa definir.
from dataclasses import dataclass
from typing import Any

@dataclass
class ToolCall:
    name: str
    arguments: dict[str, Any]

READ_ONLY_TOOLS = {"search_docs"}
SENSITIVE_TOOLS = {"publish_post"}

def authorize(call: ToolCall, human_approved: bool = False) -> None:
    if call.name in READ_ONLY_TOOLS:
        return

    if call.name in SENSITIVE_TOOLS and human_approved:
        return

    raise PermissionError(
        f"Execução bloqueada para a ferramenta: {call.name}"
    )

def dispatch(call: ToolCall, human_approved: bool = False) -> str:
    authorize(call, human_approved)

    if call.name == "search_docs":
        query = call.arguments.get("query")
        if not isinstance(query, str) or not query.strip():
            raise ValueError("A consulta precisa ser um texto não vazio.")
        return f"Pesquisa simulada: {query}"

    if call.name == "publish_post":
        content = call.arguments.get("content")
        if not isinstance(content, str) or not content.strip():
            raise ValueError("O conteúdo precisa ser um texto não vazio.")
        return "Publicação autorizada."

    raise ValueError("Ferramenta desconhecida.")

if __name__ == "__main__":
    print(dispatch(ToolCall("search_docs", {"query": "política de segurança"})))

    try:
        print(dispatch(ToolCall("publish_post", {"content": "Olá"})))
    except PermissionError as error:
        print(error)

    print(dispatch(
        ToolCall("publish_post", {"content": "Olá"}),
        human_approved=True
    ))
Esse código é didático, não um sandbox completo. A aplicação real também precisa validar esquemas, limitar tamanho e formato dos argumentos, proteger credenciais e executar cada ferramenta com permissões próprias. A aprovação humana deve ser registrada e vinculada à ação exata: aprovar uma publicação não deve liberar qualquer chamada futura do agente.
Erros comuns ao colocar agentes em produção
- Dar acesso amplo “para facilitar”. Um agente que só precisa consultar documentação não deveria receber acesso de escrita ao repositório ou às credenciais de produção.
- Tratar o prompt como firewall. Instruções ajudam, mas não substituem validação no código, permissões do sistema e isolamento.
- Usar uma credencial compartilhada e permanente. Prefira credenciais temporárias, escopadas e revogáveis. Nunca exponha segredos ao contexto do modelo sem necessidade.
- Ignorar conteúdo externo. Páginas, tickets e documentos devem ser tratados como entrada não confiável, mesmo quando parecem fazer parte do fluxo normal.
- Automatizar ações irreversíveis sem confirmação. Envio de e-mail, exclusão de dados, deploy e pagamentos devem ter limites e, conforme o impacto, aprovação humana.
- Não testar abuso e falhas. Teste tentativas de prompt injection, argumentos inválidos, repetição de chamadas e falhas de rede. Meça também se o sistema consegue parar com segurança.
Outro erro é confundir observabilidade com segurança. Registrar chamadas ajuda a investigar incidentes, mas, se o agente já conseguiu apagar dados ou divulgar um segredo, o log não desfaz o impacto. Por isso, contenção e recuperação precisam fazer parte do desenho: limites de execução, backups, revogação de tokens e procedimentos para interromper o agente.
O que muda para quem desenvolve software
Agentes podem reduzir trabalho repetitivo, mas adicionam uma fronteira de segurança entre o modelo, as ferramentas e os dados. Para um assistente que apenas resume documentação pública, o risco é diferente do de um agente que altera infraestrutura. A arquitetura deve acompanhar o impacto da tarefa, não o entusiasmo com a automação.
Comece com modo de leitura e tarefas estreitas. Registre o que o agente pediu e o que a aplicação executou. Depois, libere escrita apenas para recursos específicos, com limites de escopo e uma forma clara de aprovação. Esse caminho costuma ser mais confiável do que lançar um agente com acesso amplo e tentar corrigir o comportamento depois.
O alerta da Anthropic merece ser levado a sério como discussão sobre agentes e ferramentas, mas não precisa ser aceito como previsão inevitável de uma IA que “escapa”. O risco técnico é mais prosaico e mais controlável: sistemas com capacidade de agir que recebem mais acesso do que precisam. A resposta não é pânico nem confiança cega; é engenharia de segurança, auditoria e responsabilização.
Perguntas frequentes sobre agentes de IA e segurança
Um agente de IA pode escapar da internet por conta própria?
Um modelo não ganha acesso à internet apenas por existir. Ele precisa que a aplicação conectada lhe ofereça ferramentas ou acesso de rede. O risco depende dessas permissões, da implementação e dos controles que validam cada ação.
Prompt injection permite controlar qualquer agente?
Não necessariamente. É uma classe de ataque em que conteúdo não confiável tenta influenciar o modelo. O impacto depende das ferramentas disponíveis e das defesas. Restringir permissões e validar ações reduz o dano mesmo quando o modelo é influenciado.
Um sandbox resolve a segurança de agentes?
Não sozinho. Um sandbox pode limitar acesso a arquivos, rede e processos, mas uma configuração inadequada pode deixar brechas. Combine isolamento com permissões mínimas, validação de chamadas, limites de execução e monitoramento.
Devo exigir aprovação humana para toda chamada de ferramenta?
Não é necessário para toda operação. Consultas de baixo risco podem ser automáticas; ações externas, sensíveis ou irreversíveis devem ter controles mais fortes. Classifique as ferramentas pelo impacto e ajuste a aprovação a esse risco.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.