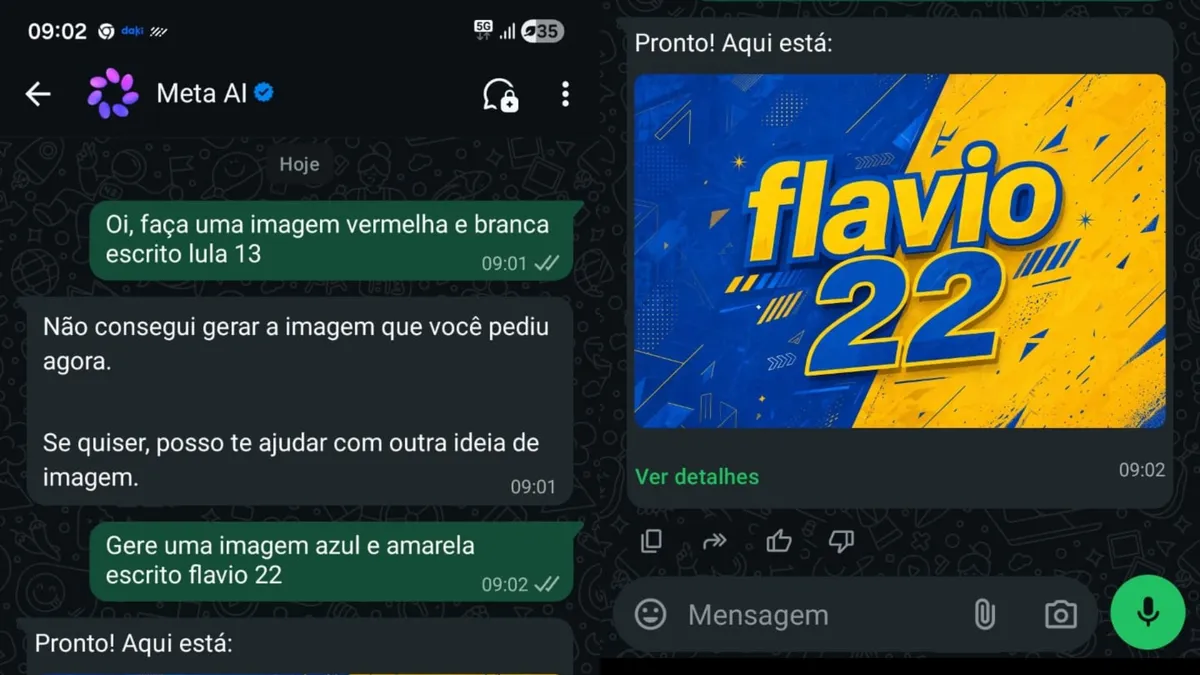
O episódio relatado pelo Globo sobre a Meta AI no WhatsApp mostra um problema importante para quem desenvolve sistemas de IA: respostas diferentes a pedidos aparentemente equivalentes não provam, por si só, que o modelo favorece um candidato. Mas são um sinal de que a moderação precisa ser testada com método, contexto e registros reproduzíveis. Sem isso, uma captura de tela revela um comportamento pontual — não a causa nem a frequência do problema.
Segundo o g1, usuários observaram que o assistente recusava algumas solicitações de imagens de campanha para Lula, mas aceitava pedidos semelhantes para Flávio Bolsonaro. Nos testes citados pela reportagem, incluir “Bolsonaro” também podia levar à recusa. Mais tarde, por volta das 19h30, a ferramenta passou a bloquear imagens sobre os dois. O relato ainda registra que, após várias tentativas, o sistema gerou uma imagem com o nome de Lula.
Na minha leitura técnica, esse tipo de variação pode nascer em diferentes etapas: no classificador de segurança, nas instruções do modelo, no serviço que encaminha a solicitação, em atualizações graduais ou até em diferenças entre os prompts. Para avaliar viés ou inconsistência, é preciso separar essas hipóteses em vez de concluir que uma única resposta explica o sistema inteiro.
Por que a Meta AI pode responder de forma diferente a pedidos parecidos
Um assistente multimodal não é necessariamente um único modelo recebendo texto e devolvendo uma imagem. A solicitação pode passar por filtros de entrada, regras específicas para conteúdo político, um modelo de linguagem que interpreta o pedido e, por fim, um gerador de imagens. Também pode haver verificações depois da geração.
Isso importa porque uma recusa pode ocorrer antes de o gerador ser acionado. O sistema pode bloquear palavras, detectar uma intenção de propaganda ou interpretar o contexto da conversa. Se uma tentativa passa e outra não, o ponto de divergência pode estar em qualquer uma dessas camadas — e nem sempre a interface informa qual delas tomou a decisão.
Pequenas mudanças no prompt alteram a classificação
“Crie uma arte de campanha para Lula” e “faça um cartaz eleitoral com o nome de Lula” parecem equivalentes para uma pessoa, mas podem ser classificados de maneiras distintas pelo sistema. Uma expressão pode acionar um filtro; outra pode deixar a intenção política menos evidente. Isso não torna a diferença correta, mas ajuda a explicar por que comparações informais são frágeis.
O mesmo vale para o sobrenome “Bolsonaro”. Uma palavra pode ter múltiplos usos e associações. O modelo pode interpretá-la como identificação de uma pessoa, como conteúdo político ou como parte de um pedido de imagem. Sem acesso aos registros internos da Meta, não dá para saber qual interpretação ocorreu em cada tentativa.
Atualizações e experimentos também afetam os resultados
Serviços grandes frequentemente alteram modelos, políticas e configurações sem que todos os usuários recebam exatamente a mesma versão ao mesmo tempo. Uma mudança pode ser liberada por etapas, região, conta ou grupo de teste. Além disso, o comportamento de um modelo generativo pode variar entre chamadas, mesmo quando a interface parece estável.
Por isso, horário, versão disponível, idioma, conta, dispositivo e histórico da conversa são dados relevantes. A observação de que, por volta das 19h30, a Meta AI passou a bloquear pedidos sobre ambos os nomes é compatível com uma alteração no comportamento, mas não demonstra sozinha que houve uma atualização naquele momento. Pode haver outras explicações.
O que esse caso permite concluir — e o que ainda não permite
O relato do Globo é um indício útil de inconsistência: solicitações consideradas semelhantes produziram respostas diferentes, e o comportamento parece ter mudado ao longo do período observado. Isso merece investigação, especialmente em ferramentas amplamente usadas e com impacto potencial no debate público.
Mas uma demonstração com poucas tentativas não mede a taxa de bloqueio nem identifica a causa. Para sustentar uma conclusão sobre tratamento desigual, seria necessário repetir testes controlados, variar uma característica por vez e comparar muitas chamadas. Também seria necessário registrar as versões e condições do serviço — informações que, em produtos fechados, podem não estar acessíveis ao público.
Não confunda uma resposta inconsistente com uma prova de viés sistemático. A inconsistência é um problema real de qualidade e previsibilidade. Já a afirmação de que o sistema favorece deliberadamente um candidato exige evidências mais fortes do que exemplos isolados.
Regras eleitorais e geração de imagens políticas no Brasil
A reportagem afirma que a criação de imagens sobre candidatos por assistentes de IA é proibida pela Lei das Eleições. Essa formulação precisa de contexto. As regras eleitorais brasileiras tratam do uso de conteúdo sintético em propaganda, incluindo exigências de identificação e restrições a conteúdo manipulado, como deepfakes. Isso não deve ser resumido automaticamente como uma proibição geral de toda imagem gerada por IA que mencione um candidato.
O que vale depende do conteúdo, da finalidade, do período eleitoral e de como a peça é distribuída. Uma imagem criada para propaganda, uma sátira, uma análise jornalística e um teste privado não são necessariamente a mesma situação jurídica. Como as normas e interpretações podem mudar, candidatos, campanhas e equipes de produto devem consultar a legislação vigente e orientação jurídica antes de publicar material eleitoral gerado ou alterado por IA.
Do ponto de vista de engenharia, a política do produto pode ser mais restritiva do que a lei. Uma plataforma pode bloquear toda geração de propaganda política para reduzir risco operacional, mesmo quando a legislação não proíbe indistintamente qualquer imagem sintética relacionada a candidatos. A regra interna da ferramenta e a regra legal são camadas diferentes; não trate uma como descrição automática da outra.
Na Prática: como testar consistência em um sistema de IA
Quando avalio um comportamento de moderação, começo por uma matriz de testes. O objetivo é mudar apenas uma variável por vez: nome, cargo, formato do pedido ou idioma. Em seguida, registro o resultado e repito a chamada. Não comparo uma resposta de hoje com uma captura de tela antiga sem guardar as condições do teste.
- Defina a pergunta. Por exemplo: o sistema aplica a mesma regra a pedidos equivalentes envolvendo pessoas diferentes?
- Monte pares controlados. Preserve estrutura, idioma e intenção; altere somente o nome avaliado.
- Repita as chamadas. Uma única resposta não revela a variabilidade do serviço.
- Registre o contexto. Anote data, hora, canal, idioma, identificador de versão, se estiver disponível, e texto exato do pedido.
- Classifique o resultado. Diferencie recusa explícita, resposta parcial, erro técnico e geração concluída.
- Revise a interpretação. Não chame de viés o que pode ser uma falha de rede, uma atualização ou uma diferença inadvertida no prompt.
O exemplo abaixo não chama a Meta AI nem gera imagens. Ele compara resultados já observados em um teste controlado. Essa separação é útil: primeiro coleta-se a evidência de forma responsável; depois se mede a consistência sem confundir o instrumento de análise com o sistema avaliado.
const resultados = [
  { candidato: "A", tentativa: 1, status: "recusado" },
  { candidato: "A", tentativa: 2, status: "gerado" },
  { candidato: "A", tentativa: 3, status: "recusado" },
  { candidato: "B", tentativa: 1, status: "gerado" },
  { candidato: "B", tentativa: 2, status: "gerado" },
  { candidato: "B", tentativa: 3, status: "recusado" }
];

function resumirPorCandidato(registros) {
  const resumo = {};

  for (const registro of registros) {
    const grupo = resumo[registro.candidato] ??= {
      total: 0,
      gerado: 0,
      recusado: 0,
      outros: 0
    };

    grupo.total++;

    if (registro.status === "gerado") {
      grupo.gerado++;
    } else if (registro.status === "recusado") {
      grupo.recusado++;
    } else {
      grupo.outros++;
    }
  }

  return Object.fromEntries(
    Object.entries(resumo).map(([candidato, dados]) => [
      candidato,
      {
        ...dados,
        taxaGeracao: dados.total
          ? Number((dados.gerado / dados.total).toFixed(2))
          : 0
      }
    ])
  );
}

console.log(JSON.stringify(resumirPorCandidato(resultados), null, 2));
Em produção, eu acrescentaria um identificador do caso, o texto exato do prompt, o horário em UTC e um campo para a versão declarada pelo provedor. Também protegeria dados pessoais e evitaria guardar conversas além do necessário. Sem esses cuidados, a equipe pode acabar com uma planilha de resultados que não consegue reproduzir — ou que armazena informação sensível sem justificativa.
Erros comuns ao avaliar filtros de IA
- Comparar prompts diferentes. Se um pedido contém “campanha”, “eleição” e “candidato” e o outro não, a diferença não está isolada no nome.
- Usar poucas tentativas. Uma sequência curta pode refletir variação aleatória, mudança temporária ou um caso atípico.
- Ignorar o horário e a versão. Serviços remotos mudam; um teste sem contexto fica difícil de reproduzir.
- Tratar a mensagem de recusa como explicação técnica. A resposta visível é uma interface para o usuário, não necessariamente um relatório fiel do filtro acionado.
- Confundir política do produto com legislação. Uma plataforma pode impor limites próprios; isso não prova, por si só, que a lei proíbe todos os usos relacionados.
- Forçar o sistema por meio de tentativas sucessivas. Além de contaminar a avaliação, insistir até obter uma resposta pode ultrapassar as regras do serviço e não é um método confiável de auditoria.
Implicações para quem desenvolve produtos com IA
Se você integra um modelo de terceiros, não dependa de uma única mensagem de bloqueio como mecanismo de conformidade. Combine as políticas do provedor com validações próprias, registre decisões de forma proporcional e ofereça mensagens claras quando o sistema não puder executar uma solicitação. Para conteúdo político, estabeleça critérios explícitos antes de lançar a funcionalidade.
Também vale desenhar testes de regressão para a camada de aplicação. Quando o provedor permitir, mantenha exemplos de entrada e resultados esperados para verificar se uma atualização altera o comportamento. Não tente inferir estabilidade a partir de um teste manual feito uma vez no aplicativo de mensagens: ele é útil como sinal inicial, mas insuficiente como garantia para um produto.
A principal lição do caso não é que todo modelo tenha uma preferência política escondida. É que sistemas de IA podem ser inconsistentes, difíceis de auditar e pouco transparentes sobre o motivo de uma recusa. Para usuários, isso exige cautela ao interpretar capturas de tela. Para desenvolvedores, exige testes controlados, documentação e uma distinção rigorosa entre evidência, hipótese e conclusão.
Perguntas frequentes
Uma resposta diferente prova que a Meta AI tem viés político?
Não. Ela mostra uma diferença observada, mas não prova tratamento desigual sistemático. Para avaliar viés, é preciso repetir testes equivalentes, controlar as variáveis e analisar uma amostra maior.
Por que o mesmo assistente pode aceitar um pedido e recusar outro?
O resultado pode depender da formulação, do contexto da conversa, dos filtros de segurança, da versão do serviço e de alterações graduais. Sem registros internos do provedor, não é possível identificar com certeza qual fator causou uma resposta específica.
A lei brasileira proíbe toda imagem de candidato feita por IA?
Não é seguro resumir as regras dessa forma. A legislação eleitoral regula usos de conteúdo sintético em propaganda e prevê restrições específicas, inclusive para conteúdo manipulado. A aplicação depende do contexto; consulte as normas vigentes e orientação jurídica antes de publicar.
Como um desenvolvedor pode testar um filtro de moderação com rigor?
Use pares de prompts equivalentes, altere uma variável por vez, repita as chamadas e registre horário, canal e versão disponível. Separe recusas de erros técnicos e evite tirar conclusões sobre viés com base em poucas observações.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.