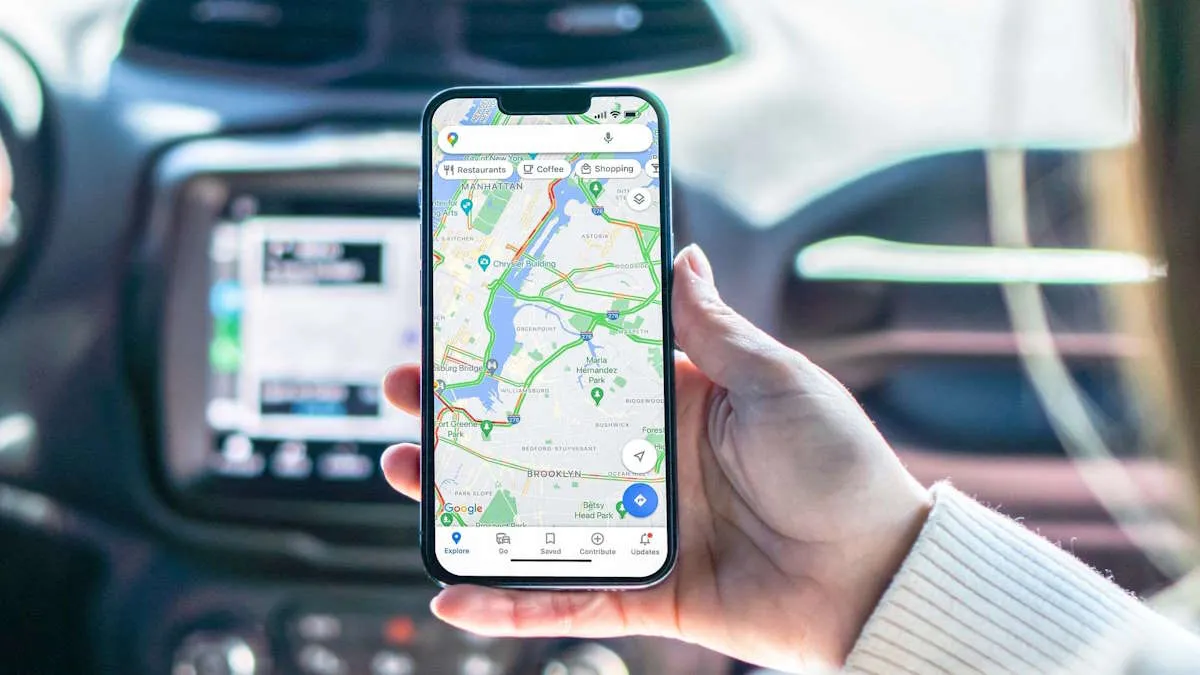
O Google Maps exibiu acidentes que não existiam porque uma camada de alertas comunitários aparentemente deixou de expirar ocorrências antigas. Segundo o Sapo.pt, os ícones falsos permaneceram no mapa por mais de 17 horas e cobriram áreas inteiras de algumas cidades, como Chicago, enquanto outros locais, como Seattle, não apresentaram o problema. Para quem desenvolve sistemas baseados em eventos e dados em tempo real, o episódio é um lembrete importante: receber um alerta é fácil; garantir que ele continue confiável depois de publicado exige regras de expiração, consistência e recuperação.
A falha não parece ter sido apenas alguém a marcar acidentes falsos. O tempo de permanência e a distribuição desigual dos ícones apontam, conforme o relato, para uma anomalia interna na plataforma. Sem uma explicação técnica oficial no material de referência, não dá para afirmar qual componente falhou. Mas dá para analisar os riscos que esse tipo de sistema precisa controlar — e o que eu faria para evitar que um evento expirado continue a influenciar uma decisão real.
Como os alertas comunitários do Google Maps podem falhar
A lógica descrita é familiar para quem usa aplicações colaborativas: uma pessoa reporta um incidente; outros condutores confirmam ou contestam; e o sistema usa esses sinais para decidir se mantém o aviso. Esse modelo distribui a recolha de dados entre os utilizadores, reduzindo a dependência de uma equipa central que teria de verificar cada ocorrência.
O problema é que uma confirmação da comunidade não deve transformar um alerta temporário num dado permanente. Um acidente pode ser removido da via, uma avaria pode ser resolvida e uma fila pode desaparecer. Por isso, o evento precisa de um prazo de validade independente das confirmações recebidas.
Segundo o Sapo.pt, os avisos fantasma permaneceram ativos durante mais de 17 horas, embora o sistema devesse eliminar ocorrências que deixassem de ser relevantes. Isso sugere uma falha na expiração, na limpeza dos dados ou na forma como o estado do alerta foi propagado até ao mapa. São hipóteses técnicas plausíveis, não uma confirmação da causa exata.
O mapa é uma projeção de vários sistemas
Em aplicações desse tipo, o ícone que aparece no ecrã não precisa de vir diretamente da base de dados principal. Pode passar por uma API, por serviços de agregação, por caches regionais e por componentes responsáveis por desenhar os elementos no mapa. Se uma camada continua a servir dados antigos, apagar o registo original pode não remover imediatamente o alerta em todos os dispositivos.
Esse desenho melhora o desempenho e reduz o custo de consultas, mas cria um desafio: manter o estado coerente. Uma mudança tem de ser reconhecida pela base de dados, refletida nos caches e distribuída aos clientes. Se um desses passos falhar, o utilizador pode continuar a ver uma informação que já não corresponde ao mundo real.
Por que um alerta falso é um problema de confiabilidade
Um ícone incorreto não é apenas um defeito visual. O condutor pode mudar de rota, atrasar uma viagem ou ignorar um alerta legítimo depois de encontrar vários avisos falsos. Em interfaces de navegação, a confiança é cumulativa: cada informação errada torna a próxima menos convincente.
Esse efeito também aparece em sistemas de monitoramento, ferramentas de segurança e painéis de operações. Se uma equipa recebe notificações repetidas que não correspondem a incidentes reais, começa a ignorá-las. É a chamada fadiga de alertas. O custo não está só na ocorrência falsa, mas na possibilidade de uma ocorrência verdadeira passar despercebida.
Na minha experiência, qualquer funcionalidade que influencia uma decisão precisa de comunicar a incerteza. Um aviso comunitário não é uma confirmação oficial. A interface e o modelo de dados devem distinguir, por exemplo, um relato recente ainda não confirmado de um incidente corroborado por várias fontes independentes.
Como eu desenharia a expiração de eventos temporários
Eu não trataria a expiração como uma tarefa de limpeza opcional executada quando o sistema está tranquilo. O prazo de validade deve fazer parte do próprio modelo do evento. Cada ocorrência teria, no mínimo, um horário de criação, um horário de expiração e um estado explícito, como ativo, resolvido ou removido.
O servidor também deve validar a validade no momento de entregar os dados. Assim, mesmo que um processo de limpeza atrase ou falhe, a API não devolve um evento vencido como se ainda estivesse ativo. A limpeza física continua útil para controlar o volume de dados, mas não pode ser a única barreira contra informação obsoleta.
CREATE TABLE traffic_events (
  id BIGSERIAL PRIMARY KEY,
  event_type TEXT NOT NULL,
  status TEXT NOT NULL DEFAULT 'active',
  created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
  expires_at TIMESTAMPTZ NOT NULL,
  report_count INTEGER NOT NULL DEFAULT 1
);

CREATE INDEX traffic_events_active_expiry_idx
  ON traffic_events (expires_at)
  WHERE status = 'active';

-- A API deve filtrar eventos vencidos mesmo que
-- a rotina de limpeza ainda não tenha executado.
SELECT id, event_type, created_at, expires_at
FROM traffic_events
WHERE status = 'active'
  AND expires_at > now();

-- A limpeza é uma tarefa complementar, não a única proteção.
UPDATE traffic_events
SET status = 'expired'
WHERE status = 'active'
  AND expires_at <= now();
Nesse exemplo, a consulta da API exclui alertas vencidos imediatamente, mesmo que a rotina de atualização ainda não tenha alterado o estado. O índice parcial ajuda a localizar eventos ativos por prazo sem indexar todos os registos. Em produção, eu também definiria uma política de retenção para histórico e analisaria se a atualização em lotes é necessária para evitar sobrecarregar a base de dados.
Para eventos sensíveis ao tempo, eu ainda mediria o atraso entre a expiração e o desaparecimento do mapa. Não basta saber que o banco marcou o item como vencido. É preciso observar o caminho completo: processamento, cache, API e atualização do cliente.
Na Prática: cinco verificações para alertas em tempo real
- Defina uma validade explícita. Todo alerta temporário deve receber um prazo coerente com o tipo de ocorrência. Um acidente e uma obra planeada não precisam necessariamente da mesma duração.
- Filtre também na leitura. A API deve ignorar eventos cujo prazo já terminou. Não dependa apenas de um processo agendado para os remover.
- Propague remoções até ao cliente. Se houver cache, invalide ou atualize a entrada correspondente. Um registo removido na origem não desaparece automaticamente de todas as cópias.
- Monitore eventos anormais. Alertas antigos, concentrações improváveis numa região ou crescimento súbito de relatos devem gerar métricas e verificações, não ser tratados como tráfego normal.
- Tenha um mecanismo de contenção. Uma opção de desativar temporariamente uma categoria de alertas pode ser mais segura do que continuar a apresentar dados suspeitos enquanto se investiga a falha.
Também usaria testes que simulam a passagem do tempo. Um teste automatizado pode criar um alerta com validade curta, avançar o relógio controlado do teste e confirmar que a API deixa de o devolver. Isso evita depender de esperas reais e torna o comportamento previsível na integração contínua.
Erros comuns ao implementar sistemas colaborativos
- Tratar a limpeza periódica como garantia de validade. Tarefas agendadas podem atrasar, falhar ou ficar sem execução. A validação precisa ocorrer na consulta também.
- Usar apenas o número de confirmações. Dez confirmações antigas não provam que um acidente continua na via. Recência e independência das fontes importam.
- Não testar a invalidação de cache. A equipa verifica a base de dados e conclui que o problema foi resolvido, mas os utilizadores continuam a receber uma resposta antiga.
- Apagar dados sem preservar evidências. Para investigar incidentes, é útil manter um histórico controlado de mudanças, sem expor dados pessoais desnecessários.
- Assumir que toda anomalia é abuso de utilizador. Moderação ajuda contra spam, mas não corrige um defeito de servidor, de expiração ou de distribuição.
Uma armadilha adicional é tentar resolver uma inconsistência apenas aumentando o número de confirmações exigidas. Isso pode reduzir alguns falsos positivos, mas também atrasar avisos reais. A resposta melhor costuma combinar sinais: idade do relato, localização, confirmação de fontes distintas, histórico de confiabilidade e prazo máximo para o evento.
Google Maps, Waze, Apple Maps e alternativas
O Google Maps e o Waze oferecem recursos comunitários que ajudam a identificar condições de trânsito, mas a experiência e a forma como cada alerta é apresentado podem variar. O Waze tem uma forte tradição de colaboração entre condutores; o Google Maps combina navegação com um conjunto mais amplo de informações sobre lugares e trajetos. O Apple Maps é uma alternativa integrada ao ecossistema Apple, enquanto serviços como HERE WeGo podem ser úteis em cenários específicos, incluindo navegação com mapas descarregados.
Não trataria nenhuma dessas opções como imune a dados incorretos. Uma plataforma diferente pode servir como segunda referência quando a informação parece implausível, mas não é uma garantia de que o outro serviço esteja atualizado. Para uma decisão importante, compare a rota, procure sinais no local e considere as condições reais de condução — sem interagir com o telemóvel enquanto dirige.
Para quem desenvolve aplicações, a comparação também ensina algo: recursos parecidos não significam a mesma arquitetura, cobertura ou política de moderação. Antes de escolher uma API ou serviço de mapas, avalie os dados disponíveis, os limites de uso, a atualização das informações, os custos e o comportamento em regiões com pouca participação de utilizadores.
O que o caso ensina a quem programa
O relato do Sapo.pt mostra como um detalhe aparentemente simples — um ícone que deveria desaparecer — depende de várias garantias técnicas. Validade no banco, lógica da API, invalidação de cache, atualização do cliente e monitoramento precisam funcionar em conjunto. Se uma camada falha, a interface pode continuar a apresentar uma versão falsa da realidade.
Quando desenho sistemas distribuídos, parto do princípio de que processos em segundo plano podem atrasar e caches podem ficar desatualizados. Por isso, protejo a leitura com regras de validade, acompanho o tempo de propagação das mudanças e planeio uma forma rápida de reduzir o impacto. Essa abordagem não elimina falhas, mas limita quanto tempo uma informação incorreta permanece útil para o sistema.
Perguntas frequentes sobre acidentes falsos no Google Maps
Por que apareceram acidentes falsos no Google Maps?
O Sapo.pt relata uma anomalia que deixou alertas comunitários visíveis por mais de 17 horas. O padrão descrito sugere um problema interno de dados ou de expiração, mas o material de referência não identifica a causa técnica confirmada.
Os alertas comunitários do Google Maps expiram?
O funcionamento descrito depende da confirmação ou contestação dos alertas e da remoção de ocorrências que deixam de ser relevantes. O episódio indica que, nessa situação, a expiração esperada não ocorreu normalmente.
Como um alerta pode continuar no mapa depois de ser removido?
Uma cópia em cache, um atraso na propagação entre serviços ou uma falha na rotina que atualiza o estado podem manter dados antigos disponíveis. É por isso que sistemas robustos filtram eventos vencidos na leitura e monitoram a distribuição até ao cliente.
O que devo fazer se encontrar um acidente suspeito no mapa?
Não presuma que o ícone está correto. Se for seguro, compare com outra fonte e observe as condições reais. Não use o telemóvel enquanto conduz; pare num local seguro antes de consultar ou reportar qualquer informação.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.