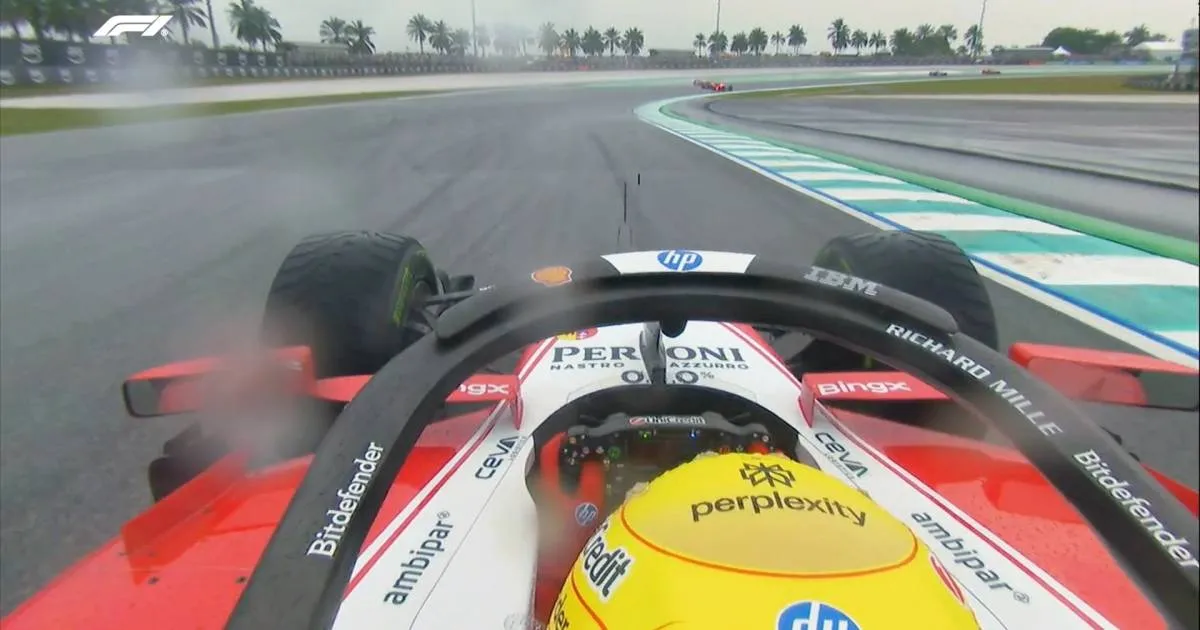
Uma falha de software em condições de chuva pode tirar vários carros da pista antes mesmo da largada — e, na Fórmula 1, isso significa transformar uma configuração eletrônica em risco operacional. Foi o que aconteceu em Sepang: problemas de potência em dez carros atrasaram o início da prova e levaram a FIA a rever o software usado em condições molhadas.
Segundo o Abril.com.br, a investigação apontou um erro nesse software como causa dos problemas durante a volta de apresentação. A resposta foi dividir a correção em etapas: restabelecer para Singapura uma configuração já usada em Sepang e lançar uma atualização específica para o GP dos Estados Unidos. Essa estratégia de contenção tem muito a ensinar a quem desenvolve sistemas críticos — mesmo fora do automobilismo.
O que aconteceu em Sepang e por que a falha importa
A chuva de monção já havia provocado dois adiamentos da largada. Quando a direção de prova anunciou uma nova previsão, vários carros apresentaram problemas eletrônicos e voltaram aos boxes. A segunda largada ocorreu às 16h33 no horário local, com parte dos competidores saindo dos boxes e usando pneus diferentes.
A sequência é relevante: o software não falhou num ambiente controlado, mas durante uma operação real, sob chuva intensa e com uma janela curta para colocar a corrida em andamento. O efeito não foi apenas um alerta no painel. Houve carros sem a resposta de potência esperada, uma largada atrasada e equipes obrigadas a reagir em tempo real.
Vale separar o que foi divulgado do que seria especulação. A FIA atribuiu o incidente a um erro no software para condições de chuva. A notícia não detalha a linha de código, o componente exato nem o mecanismo interno que produziu a falha. Portanto, não dá para afirmar que foi um bug de sensor, uma condição de corrida específica ou um defeito de hardware.
Também há uma imprecisão na referência original: ela menciona o “Grande Prêmio do Bahrein” ao descrever a prova no circuito de Sepang, na Malásia. Como o restante do relato identifica Sepang e o evento malaio, uso aqui “GP da Malásia” para evitar reproduzir essa inconsistência.
Software de unidade de potência: mais do que um mapa de motor
Uma unidade de potência de F1 combina componentes mecânicos, eletrônicos e sistemas de controle. O software participa da coordenação desses elementos e precisa operar dentro de limites definidos pela equipe e pelo regulamento. Em termos gerais, ele pode influenciar como o sistema responde a entradas do piloto e a condições detectadas pelo carro.
“Modo de chuva” não significa necessariamente um único botão ou uma função isolada. Uma configuração para pista molhada pode envolver parâmetros e estratégias diferentes das usadas no seco. O ponto de engenharia é que uma condição ambiental pode mudar a forma como o sistema interpreta entradas, decide o comportamento esperado e aplica uma configuração.
Isso aumenta a complexidade de testes. Um programa pode passar por verificações em pista seca e ainda falhar quando vários fatores aparecem juntos: chuva forte, baixa aderência, mudanças rápidas de condição e procedimentos específicos da volta de apresentação. É o equivalente automotivo a um serviço web que funciona bem em testes unitários, mas degrada quando recebe tráfego real com dados inesperados.
O cenário também lembra sistemas distribuídos: carros diferentes, equipes e configurações distintas precisam operar segundo regras compatíveis. Uma alteração de software pode ter efeitos que não aparecem em uma execução simples. Por isso, em sistemas críticos, “compilou e passou no teste” não é evidência suficiente de prontidão operacional.
Por que a FIA optou por uma mudança em etapas
De acordo com o Abril.com.br, a configuração estabelecida para Sepang seria restabelecida em Singapura se condições climáticas semelhantes fossem esperadas. Uma nova atualização de software para chuva ficaria para o GP dos Estados Unidos, marcado para 25 de outubro. A investigação também recomendou medidas para permitir que o software fosse testado e se tornasse mais robusto.
Essa abordagem evita tratar toda correção como um “patch urgente” que precisa entrar imediatamente em produção. Primeiro, reduz-se o risco conhecido com uma configuração previamente estabelecida. Depois, prepara-se uma versão nova e cria-se um caminho para testá-la antes de depender dela numa situação crítica.
Na minha avaliação, a decisão demonstra uma regra útil de engenharia: quando não há confiança suficiente numa mudança, não se deve confundir velocidade de entrega com segurança. Uma solução nova pode corrigir o defeito identificado e, ao mesmo tempo, introduzir outro. Em sistemas de alto impacto, voltar temporariamente para um estado conhecido pode ser mais seguro do que instalar uma correção não validada.
Esse retorno, porém, não é automaticamente seguro. É preciso confirmar que a configuração anterior continua adequada para o ambiente atual, que a versão pode ser identificada sem ambiguidade e que a equipe sabe quais carros ou operações estão usando cada configuração. “Fazer rollback” sem controle de versão pode apenas trocar um risco conhecido por uma confusão operacional.
O que esse incidente ensina sobre confiabilidade de software
Testar combinações, não apenas recursos isolados
Testar uma função de chuva separadamente não garante que ela funcione junto com os demais componentes do sistema. Uma estratégia sólida inclui testes de integração, cenários de borda e combinações plausíveis de condições. Para um sistema web, isso pode significar testar autenticação, cache e limites de requisição simultaneamente — não só cada módulo em isolamento.
Ter um modo degradado seguro
Quando uma função avançada falha, o sistema precisa ter um comportamento alternativo previsível. Isso é chamado de fail-safe ou operação degradada, dependendo do contexto. A alternativa não deve simplesmente manter o último estado sem avaliação: esse estado pode ser inadequado para a situação atual.
Num serviço digital, por exemplo, se uma recomendação baseada em IA falha, o produto pode apresentar uma resposta padrão revisada, em vez de bloquear o fluxo inteiro ou exibir dados inconsistentes. A mesma lógica se aplica a sistemas embarcados: a fallback precisa ser planejada, testada e documentada.
Separar configuração de código e controlar versões
Uma configuração específica para chuva deveria ser rastreável como qualquer outra mudança relevante: versão, responsável, motivo, data e critérios de ativação. Isso facilita auditoria e reversão. Em aplicações web, feature flags e configurações versionadas cumprem parte desse papel, desde que não virem uma coleção de chaves sem dono nem prazo de remoção.
Observar o sistema antes e depois da mudança
Uma implantação segura precisa de sinais que indiquem se a versão está saudável. Em software embarcado, isso pode exigir telemetria e procedimentos de diagnóstico próprios. Em sistemas web, usamos métricas como taxa de erro, latência e volume de requisições. Sem observabilidade, a equipe pode até implantar uma correção, mas não saber se ela resolveu o problema ou apenas mudou o sintoma.
Na Prática: estratégia de configuração com validação e fallback
O exemplo abaixo é uma demonstração didática em Python. Ele não representa o software usado pela FIA nem reproduz a lógica real de uma unidade de potência. Mostra apenas como selecionar uma configuração por condição, validar a versão e evitar ativar uma configuração experimental sem aprovação.
from dataclasses import dataclass

@dataclass(frozen=True)
class Configuracao:
    versao: str
    modo_chuva: bool
    aprovada: bool

CONFIG_SEPANG = Configuracao(
    versao="sepang-estavel",
    modo_chuva=True,
    aprovada=True,
)

CONFIG_NOVA = Configuracao(
    versao="chuva-candidata-2",
    modo_chuva=True,
    aprovada=False,
)

def escolher_configuracao(chuva_prevista: bool,
                          candidata: Configuracao) -> Configuracao:
    if chuva_prevista and candidata.aprovada:
        return candidata

    # Mantém uma configuração conhecida até a candidata ser aprovada.
    return CONFIG_SEPANG

def validar_configuracao(config: Configuracao) -> None:
    if not config.versao:
        raise ValueError("A configuração precisa ter uma versão.")

    if config.modo_chuva and not config.aprovada:
        raise ValueError("Modo de chuva experimental não aprovado.")

if __name__ == "__main__":
    ativa = escolher_configuracao(
        chuva_prevista=True,
        candidata=CONFIG_NOVA,
    )
    validar_configuracao(ativa)
    print(f"Configuração ativa: {ativa.versao}")
O detalhe importante não é a linguagem, mas a política explícita: a previsão de chuva, sozinha, não autoriza ativar uma versão candidata. A configuração precisa estar aprovada. Num projeto real, eu também registraria a decisão, validaria compatibilidade com o hardware e definiria como retornar à versão anterior.
Outro cuidado: uma previsão meteorológica é uma entrada incerta, não uma verdade absoluta. Sistemas robustos não devem depender de um único sinal sem definir o que acontece quando ele está ausente, atrasado ou contraditório. Em aplicações comuns, o equivalente é não deixar uma resposta incompleta de API decidir sozinha uma migração de dados ou uma operação irreversível.
Erros comuns ao corrigir falhas em produção
- Aplicar uma correção sem reproduzir o cenário. Corrigir o sintoma observado pode deixar intacta a condição que causou o problema. Reproduzir o contexto ajuda a testar a causa, não apenas o resultado visível.
- Testar só o caminho feliz. Se a função é usada em chuva, testes apenas em condições normais não cobrem o comportamento crítico. Inclua estados intermediários, entradas ausentes e transições rápidas.
- Fazer rollback sem saber qual versão está ativa. Sem inventário e rastreabilidade, a reversão vira uma operação manual sujeita a erro. Registre a versão e confirme o estado após a mudança.
- Confundir “passou nos testes” com “está pronto”. Testes são evidência, não garantia absoluta. Em sistemas críticos, combine testes automatizados, revisão, simulação, validação operacional e monitoramento.
- Deixar a configuração experimental chegar ao usuário por padrão. Uma flag esquecida ou com valor ambíguo pode ativar um comportamento ainda não aprovado. Defina valores padrão seguros e critérios objetivos de liberação.
- Não planejar o comportamento degradado. Se a nova lógica falha, o sistema precisa saber como continuar sem improviso. Uma alternativa segura deve fazer parte do projeto desde o início.
FAQ: software, chuva e confiabilidade na F1
O que causou os problemas de potência no GP da Malásia?
Segundo a investigação divulgada pela FIA e relatada pelo Abril.com.br, um erro no software usado para condições de chuva provocou os problemas observados em dez carros durante a volta de apresentação. A notícia não informa o defeito técnico específico.
Por que não instalaram a atualização imediatamente?
Uma atualização ainda precisa ser validada. A FIA planejou restabelecer uma configuração estabelecida para Sepang em Singapura, caso houvesse previsão de condições semelhantes, e lançar uma nova versão para o GP dos Estados Unidos. A lógica é reduzir o risco imediato sem tratar uma versão não validada como solução garantida.
Como testar software que depende de condições climáticas?
É preciso combinar testes unitários e de integração com simulações de cenários e testes de transição entre condições. Também convém definir critérios de aprovação, validar entradas incompletas e registrar quais versões foram testadas em cada configuração relevante.
Esse tipo de problema também pode ocorrer em aplicações web?
Sim. O domínio muda, mas o padrão é conhecido: uma combinação de condições pouco testada expõe uma falha em produção. Feature flags, testes de integração, monitoramento, versões rastreáveis e rollback planejado ajudam a reduzir impacto — sem substituir testes e análise da causa raiz.
Conclusão
O caso de Sepang mostra que software crítico exige mais do que uma correção rápida. É necessário entender a causa, conter o risco, validar uma nova versão e garantir que exista um caminho seguro caso algo falhe. Essa disciplina vale tanto para uma unidade de potência quanto para uma API que sustenta um produto inteiro.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.