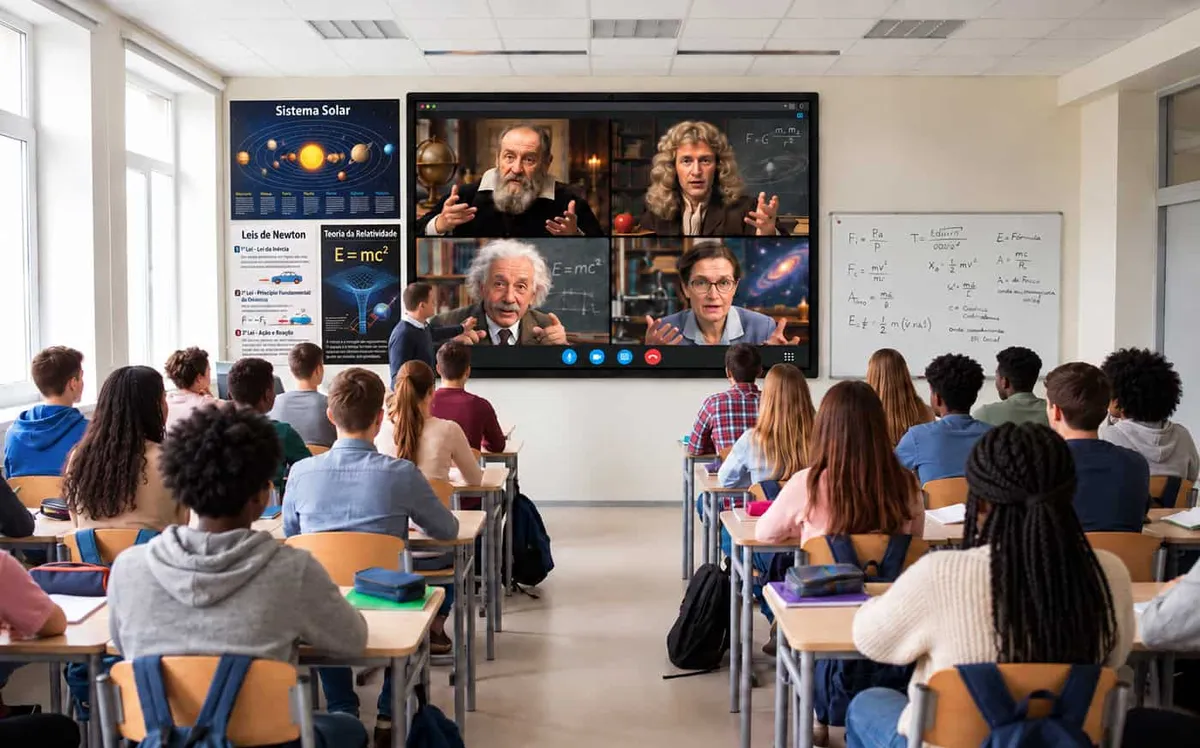
Simular uma conversa com cientistas do passado pode tornar uma aula mais envolvente, mas só funciona como recurso educacional quando a experiência deixa claro o que é fato histórico e o que foi gerado pelo modelo. Segundo o Olhar Digital, uma iniciativa brasileira usa IA generativa para dar “vida” a personalidades da ciência em uma experiência de ensino. O trecho disponível não informa quais modelos, fontes ou mecanismos de validação foram usados; por isso, analiso aqui como eu projetaria uma solução desse tipo sem confundir uma simulação convincente com uma fonte histórica confiável.
IA para educação: o que significa simular uma personalidade histórica
Um modelo de linguagem não recupera a consciência, as memórias nem a forma exata de pensar de uma pessoa que morreu há séculos. Ele prevê sequências de texto com base em padrões aprendidos durante o treinamento e nas instruções e informações fornecidas durante a conversa.
Na prática, a experiência combina uma persona — por exemplo, “responda como uma cientista do século XIX” — com contexto, documentos e regras de comportamento. Isso pode criar uma conversa útil para explorar ideias, desde que a interface não sugira que as respostas sejam citações autênticas ou reproduções fiéis do pensamento original.
Essa distinção importa para quem desenvolve o produto. Uma resposta fluente pode incluir um erro com a mesma segurança aparente de uma informação bem documentada. Em educação, o risco não é apenas uma resposta incorreta: é o estudante aprender a confiar no tom convincente em vez de verificar a evidência.
Como projetar uma experiência educacional com IA generativa
Persona não é fonte histórica
Um prompt com biografia e características de personalidade pode orientar o estilo, mas não garante precisão. Dizer ao modelo “você é Marie Curie” pode produzir uma conversa imersiva; não prova que cada afirmação corresponda ao que ela escreveu, disse ou acreditava.
Eu trataria a persona como uma camada de apresentação, não como o mecanismo de conhecimento. Para responder perguntas factuais, o sistema deveria recuperar trechos de fontes selecionadas — livros, cartas, artigos, arquivos e materiais didáticos — e indicar quando uma resposta é interpretação, não registro histórico.
RAG ajuda, mas não resolve tudo
Uma arquitetura comum é a geração aumentada por recuperação, ou RAG. O sistema busca passagens relevantes em um conjunto de documentos e as envia ao modelo como contexto. Isso tende a ser mais controlável do que depender apenas do conhecimento adquirido durante o treinamento.
Mas RAG não é um selo de verdade. Uma busca ruim pode encontrar um trecho irrelevante; um documento de baixa qualidade pode contaminar a resposta; e o modelo ainda pode extrapolar além das fontes. É preciso testar a recuperação, registrar a origem dos documentos e instruir o modelo a admitir quando não há evidência suficiente.
Uma arquitetura que eu usaria
- Interface: identifica claramente que o estudante conversa com uma simulação gerada por IA.
- Recuperação: busca passagens em um acervo curado e adequado à faixa etária.
- Geração: produz uma resposta ancorada nessas passagens, com linguagem apropriada.
- Verificação: confere se as referências citadas existem e se pertencem ao acervo recuperado.
- Avaliação: mede precisão, qualidade pedagógica, segurança e comportamento diante de perguntas sem resposta documentada.
Eu também separaria as métricas. “O estudante gostou” mede experiência, não precisão. “A resposta citou uma fonte” não prova que a fonte sustente a afirmação. Para uma ferramenta educacional, é melhor avaliar essas dimensões de forma independente.
Na Prática: um prompt com evidências e limite de resposta
O exemplo abaixo mostra uma chamada simples com a API da OpenAI. Ele recebe trechos de fontes previamente selecionadas e pede que o modelo responda usando apenas esse material. O código não implementa a busca RAG nem valida a qualidade das fontes; essas etapas pertencem ao sistema que fornece a lista fontes.
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])

def responder_com_fontes(pergunta, fontes):
    contexto = "\n\n".join(
        f"[{fonte['id']}] {fonte['titulo']}\n{fonte['trecho']}"
        for fonte in fontes
    )

    resposta = client.responses.create(
        model="gpt-4.1-mini",
        instructions=(
            "Você é uma simulação educacional de uma personalidade histórica. "
            "Não afirme ser a pessoa real. Responda em português usando somente "
            "as fontes fornecidas. Cite cada afirmação factual com o ID da fonte, "
            "no formato [S1]. Se as fontes não responderem à pergunta, diga isso "
            "claramente. Diferencie fatos documentados de interpretações."
        ),
        input=(
            f"Fontes disponíveis:\n{contexto}\n\n"
            f"Pergunta do estudante: {pergunta}"
        )
    )

    return resposta.output_text

fontes = [
    {
        "id": "S1",
        "titulo": "Documento histórico selecionado pelo professor",
        "trecho": "Insira aqui um trecho real, revisado e referenciado."
    }
]

print(responder_com_fontes(
    "O que as fontes permitem afirmar sobre este tema?",
    fontes
))
Para rodar, instale o pacote openai e configure a variável de ambiente OPENAI_API_KEY. Em produção, eu não deixaria qualquer usuário inserir documentos sem controle: incluiria revisão editorial, metadados, permissões e um processo para atualizar ou retirar conteúdo.
Também validaria as referências após a geração. Se o modelo citar [S9], mas só recebeu [S1], a aplicação deve sinalizar ou bloquear a resposta, em vez de exibir uma citação inventada. Esse tipo de validação não resolve todos os erros, mas evita uma categoria simples e detectável de alucinação.
Comparação com outras abordagens de ensino
Um chatbot de propósito geral é rápido de prototipar, mas oferece pouco controle sobre as fontes e o comportamento. Pode ser útil para exploração livre, desde que o estudante saiba que está interagindo com um modelo e que respostas precisam de verificação.
Um sistema RAG com acervo curado custa mais para construir e manter, mas permite limitar o conteúdo, apresentar referências e atualizar documentos sem retreinar o modelo. Para uma experiência sobre história da ciência, essa costuma ser uma troca mais defensável do que tentar resolver tudo com um prompt longo.
Há ainda a alternativa de um roteiro interativo com respostas escritas e revisadas por especialistas. Ele é menos flexível, mas previsível e fácil de auditar. Se o objetivo pedagógico cabe em um conjunto pequeno de perguntas, talvez essa solução seja melhor do que introduzir um modelo generativo apenas porque a tecnologia está disponível.
Erros comuns ao criar personagens históricos com IA
- Apresentar a simulação como se fosse a pessoa real: prejudica a compreensão do estudante sobre o que a IA faz e pode atribuir opiniões inexistentes a figuras históricas.
- Usar um prompt como substituto de curadoria: instruções bem escritas orientam o modelo, mas não verificam fatos nem corrigem fontes enviesadas.
- Confundir citação com comprovação: exibir uma referência só ajuda quando o trecho citado realmente sustenta a afirmação.
- Não testar perguntas fora do escopo: o sistema precisa saber dizer “não encontrei evidência”, em vez de improvisar uma resposta convincente.
- Ignorar privacidade e idade: conversas de estudantes podem conter dados pessoais. Colete apenas o necessário, defina retenção e revise as regras de proteção aplicáveis.
- Avaliar apenas pela fluidez: uma resposta simpática não é necessariamente correta, apropriada à idade ou útil para aprender.
Eu incluiria testes com perguntas ambíguas, erros factuais deliberados e tentativas de fazer o personagem abandonar as regras. Também registraria, com cuidado para não expor dados pessoais, quais documentos foram recuperados e qual versão do prompt gerou cada resposta. Sem rastreabilidade, investigar uma falha depois do lançamento fica muito mais difícil.
O que essa iniciativa pode ensinar a quem desenvolve
O caso descrito pelo Olhar Digital é interessante porque desloca a discussão de “IA substitui professor?” para uma questão de design: como construir uma interação que desperte curiosidade sem disfarçar os limites do modelo. A resposta depende menos de criar uma persona convincente e mais de desenhar boas fronteiras entre evidência, interpretação e ficção.
Para desenvolvedores, a lição é prática. Antes de escolher o modelo, defina quais perguntas a ferramenta deve responder, quais fontes são aceitáveis e como ela deve se comportar quando não souber. Depois, compare modelos e alternativas com os mesmos testes, em vez de confiar em uma demonstração impressionante.
Eu também não trataria a IA como substituta do professor ou do material didático. O melhor uso é como interface exploratória: o estudante pergunta, recebe uma resposta contextualizada e é convidado a conferir as fontes e discutir interpretações. Isso transforma a conversa em ponto de partida, não em autoridade final.
FAQ: IA generativa e simulação de cientistas históricos
A IA consegue reproduzir exatamente o pensamento de uma personalidade histórica?
Não. Ela pode imitar um estilo ou simular uma conversa com base em instruções e documentos, mas não reproduz a consciência nem garante fidelidade completa às ideias da pessoa. A interface deve apresentar a interação como simulação.
RAG impede alucinações em chatbots educacionais?
Não impede. RAG fornece contexto recuperado de documentos, mas a busca pode falhar e o modelo pode extrapolar. Curadoria, instruções, validação de citações e testes continuam necessários.
É melhor usar um modelo generativo ou respostas pré-escritas?
Depende do objetivo. Respostas revisadas são mais previsíveis; modelos generativos lidam melhor com perguntas variadas, mas exigem controles e avaliação. Para um conteúdo limitado, um roteiro pode ser a escolha mais segura.
Como testar se um chatbot histórico é confiável?
Monte um conjunto de perguntas com respostas verificadas por especialistas, inclua casos sem evidência e teste se o sistema admite incerteza. Confira também se cada citação existe e sustenta a afirmação associada.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.