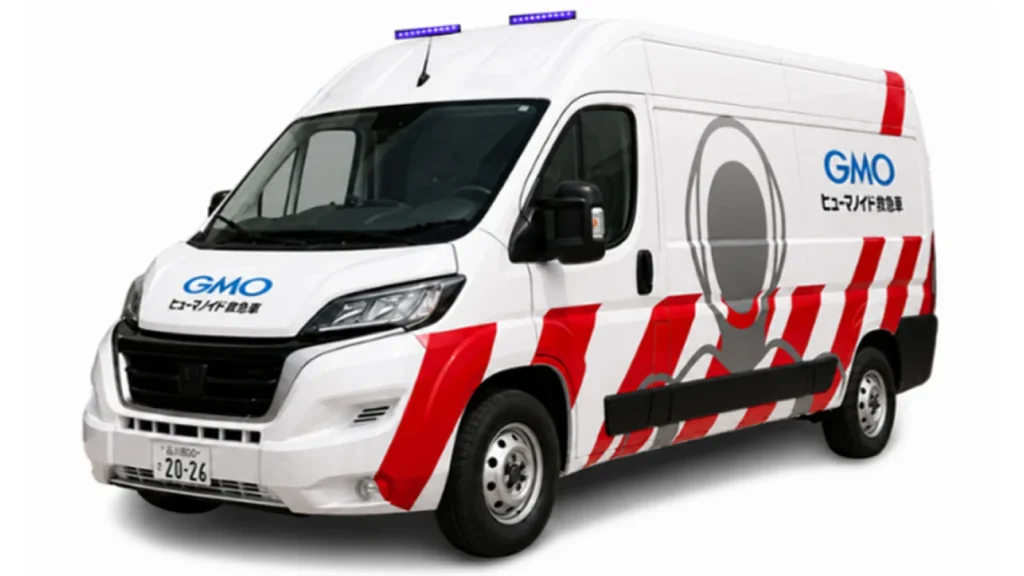
Quando o robô quebra: o Japão acabou de criar o “SAMU” para humanoides
Robôs humanoides em operação 24/7 são o sonho de qualquer CTO. Mas ninguém fala no pesadelo: o que acontece quando um deles trava em horário de pico? Segundo o Sapo.pt, a GMO AI & Robotics acaba de lançar a primeira “ambulância para robôs humanoides” do Japão — um veículo equipado com engenheiro, peças e diagnóstico de campo. Na minha experiência lidando com sistemas críticos, isso é menos ficção científica e mais uma confissão de que o ecossistema de robôs humanoides ainda não tem a observabilidade que o software corporativo já tem há anos.
Vou explicar o que está por trás dessa notícia, o que devs e engenheiros de IA podem aprender com isso e onde está o gap técnico que ainda não foi resolvido.
O que a GMO AIR realmente fez (e o que isso significa)
A “GMO Humanoid Ambulance” não é uma van com uma chave de fenda. Pelo que a reportagem descreve, é um veículo com:
- Ferramentas de diagnóstico específicas para plataformas humanoides
- Componentes para substituição em campo (atuadores, sensores, placas)
- Espaço para transporte do robô avariado, se necessário
- Um engenheiro de robótica humanoide a bordo — não um mecânico genérico
O detalhe mais revelador é o último. Não dá para fazer manutenção de humanoides como se faz com um servidor quebrado. Cada modelo tem cinemática própria, firmware proprietário e modos de falha que só quem opera a máquina entende. É literalmente a mesma diferença entre um sysadmin e um DBA — mas com hardware de 1,80m no meio.
Por que isso interessa para quem programa
Porque toda vez que vejo um vídeo de humanoid em fábrica, faço a mesma pergunta que faria em produção: onde está a telemetria?
Quando eu rodo um cluster de microsserviços, eu tenho logs estruturados, métricas, traces e alertas. Quando um nó trava, o sistema abre um ticket, um runbook é executado e a maioria das falhas é resolvida sem intervenção humana presencial. Com humanoides atuais, a coisa é mais primitiva:
- Monitoramento é, na melhor das hipóteses, um dashboard que mostra se o robô está “online”
- Logs internos raramente são expostos em formato acessível
- Não há padrão aberto para telemetria de atuadores e juntas (cada fabricante reinventa a roda)
- O ciclo de feedback entre falha e fix depende de alguém perceber visualmente que algo está errado
A ambulância da GMO é, na prática, uma admissão pública de que o software de gestão de frota humanoides ainda não amadureceu. É como se, em 2024, a única forma de diagnosticar um servidor fora do ar fosse enviar um técnico ao datacenter com um multímetro.
O paralelo com DevOps e SRE — o que devs já sabem e robótica ainda precisa aprender
Quem trabalha com SRE conhece os conceitos de MTTR (Mean Time To Repair) e MTTD (Mean Time To Detect). A ambulância humanoides ataca o MTTR, mas o MTTD continua sendo péssimo. Vou ser direto: o problema não é a ambulância, é a falta de observabilidade que torna a ambulância necessária.
Três pilares que robótica humanoide precisa copiar do software
- Health checks ativos: em vez de esperar o robô parar, pingar endpoints internos de diagnóstico a cada N segundos
- Logs estruturados com correlação: toda falha mecânica deveria ter um ID de incidente linkado ao log de firmware
- Modo degradado automático: se uma junta falha, o robô deveria operar com cinemática reduzida e emitir alerta antes de travar completamente
Se você já trabalhou com Kubernetes, sabe que um pod com falha é recriado automaticamente. O equivalente em robótica seria um humanoide detectar que um atuador está com torque anômalo e se deslocar para uma zona de descanso antes de colapsar. Isso existe em alguns protótipos, mas não é padrão.
Na Prática: prototipando um “health endpoint” para robôs humanoides
Imagine que você está integrando um humanoide à sua stack. O mínimo viável seria expor um endpoint HTTP simples para telemetria. Aqui vai um exemplo funcional em Python que simula o que um agente de monitoramento rodando no robô poderia reportar:
# humanoid_health.py
# Agente de telemetria para robô humanoide — MVP funcional

import time
import json
import random
from dataclasses import dataclass, asdict
from datetime import datetime, timezone

@dataclass
class JointStatus:
 name: str
 temperature_c: float
 torque_nm: float
 position_deg: float
 error_code: int

class HumanoidHealthAgent:
 """
 Simula um agente de monitoramento embarcado.
 Em produção, isso rodaria como systemd unit no
 computador de bordo do robô (geralmente NVIDIA Jetson
 ou similar) e exporia um endpoint HTTP.
 """

 def __init__(self, robot_id: str):
 self.robot_id = robot_id
 self.joints = [
 JointStatus("shoulder_l", 35.0, 12.0, 0.0, 0),
 JointStatus("shoulder_r", 36.1, 11.8, 0.0, 0),
 JointStatus("elbow_l", 34.5, 9.2, 45.0, 0),
 JointStatus("elbow_r", 35.0, 9.5, 45.0, 0),
 JointStatus("hip_l", 37.0, 25.0, 0.0, 0),
 JointStatus("hip_r", 37.5, 25.5, 0.0, 0),
 JointStatus("knee_l", 38.0, 30.0, 90.0, 0),
 JointStatus("knee_r", 38.2, 30.1, 90.0, 0),
 ]

 def collect_telemetry(self) -> dict:
 """Coleta snapshot do estado atual."""
 # Simula desgaste progressivo em uma junta específica
 for joint in self.joints:
 jitter = random.uniform(-0.5, 0.5)
 joint.temperature_c += jitter
 joint.torque_nm += random.uniform(-0.2, 0.2)
 if joint.temperature_c > 75:
 joint.error_code = 1 # THERMAL_WARN
 if joint.temperature_c > 85:
 joint.error_code = 2 # THERMAL_CRIT
 return {
 "robot_id": self.robot_id,
 "ts": datetime.now(timezone.utc).isoformat(),
 "joints": [asdict(j) for j in self.joints],
 "overall_status": self._compute_status(),
 }

 def _compute_status(self) -> str:
 if any(j.error_code == 2 for j in self.joints):
 return "CRITICAL"
 if any(j.error_code == 1 for j in self.joints):
 return "DEGRADED"
 return "OK"

if __name__ == "__main__":
 agent = HumanoidHealthAgent(robot_id="GMO-AIR-0042")
 for _ in range(3):
 snapshot = agent.collect_telemetry()
 print(json.dumps(snapshot, indent=2))
 time.sleep(1)
Em produção, esse mesmo agente alimentaria um Prometheus exporter ou um webhook que dispararia um alerta no PagerDuty quando overall_status == "CRITICAL". O engenheiro na ambulância da GMO receberia o ticket com o snapshot exato da junta problemática antes mesmo de sair da base. Esse é o caminho.
Erros comuns que devs cometem quando integram robótica na stack
Já vi gente tratar robô como se fosse API REST e se queimar feio. Anota essas armadilhas:
- Confiar em status “online/offline” como health check. Um humanoide pode estar online e com 3 juntas travadas. Métrica inútil.
- Ignorar a latência da rede. Wi-Fi de fábrica é hostil. Telemetria crítica precisa de buffer local e envio assíncrono — não pode bloquear o loop de controle do robô.
- Não versionar firmware junto com software. Se o robô atualiza o firmware e a sua API quebra, você só descobre quando o braço está segurando uma peça de avião. Use semver e mantenha contrato de telemetria estável.
- Tratar logs do robô como logs de aplicação. Logs de robótica misturam cinemática, visão computacional e controle de motores. Sem correlação, é inútil para debugging.
- Esquecer do modo degradado. Se seu software depende 100% do humanoide, e o humanoide entra em safe mode, sua operação para. Implemente fallback.
O que isso muda para o ecossistema de IA
A longo prazo, a tendência é clara: humanoides vão operar em frotas, e frotas precisam de gestão. Já existem empresas de logística fazendo isso com AGVs (veículos autônomos) há anos. A diferença é que humanoides são mecanicamente mais complexos e menos padronizados.
Quando os modelos de fundação de robótica (tipo os que a Figure, Tesla e 1X estão treinando) amadurecerem, a tendência é que cada unidade carregue um agente de IA local capaz de auto-diagnosticar e até negociar tarefas com outros robôs. A ambulância física pode se tornar redundante — substituída por uma API de “repair request” e um drone entregando a peça.
Mas até lá, alguém tem que colocar a mão na massa. E, aparentemente, no Japão, esse alguém vai de ambulância.
FAQ — Perguntas que devs realmente fazem
1. Qual o principal risco de colocar humanoides em produção hoje?
A falta de observabilidade. Você não tem como prever nem diagnosticar falhas com precisão. É como rodar microsserviços sem Prometheus.
2. Existem padrões abertos para telemetria de robôs?
Parcialmente. O ROS 2 tem padrões de mensagens para sensores, mas telemetria de saúde (vibração, temperatura, torque) ainda é fragmentada por fabricante. O ROS 2 Diagnostics seria o ponto de partida.
3. Como simular um humanoide sem hardware?
Use o Gazebo ou o NVIDIA Isaac Sim. Ambos permitem emular juntas, sensores e falhas. Para treinar agentes de manutenção, é o caminho padrão.
4. Vale a pena estudar cinemática de robôs se sou dev de software?
Se você quer trabalhar com embodied AI, sim. Sem entender forward/inverse kinematics, você não consegue debugar problemas de trajetória nem otimizar consumo de energia. Se você só quer integrar APIs, dá para passar longe — por enquanto.
5. A ambulância da GMO é mais marketing do que tecnologia?
Na minha leitura, é marketing com fundamento. A empresa está vendendo a ideia de que humanoides são confiáveis o suficiente para justificar uma operação de manutenção dedicada. Isso é um sinal de mercado, não só de engenharia.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.