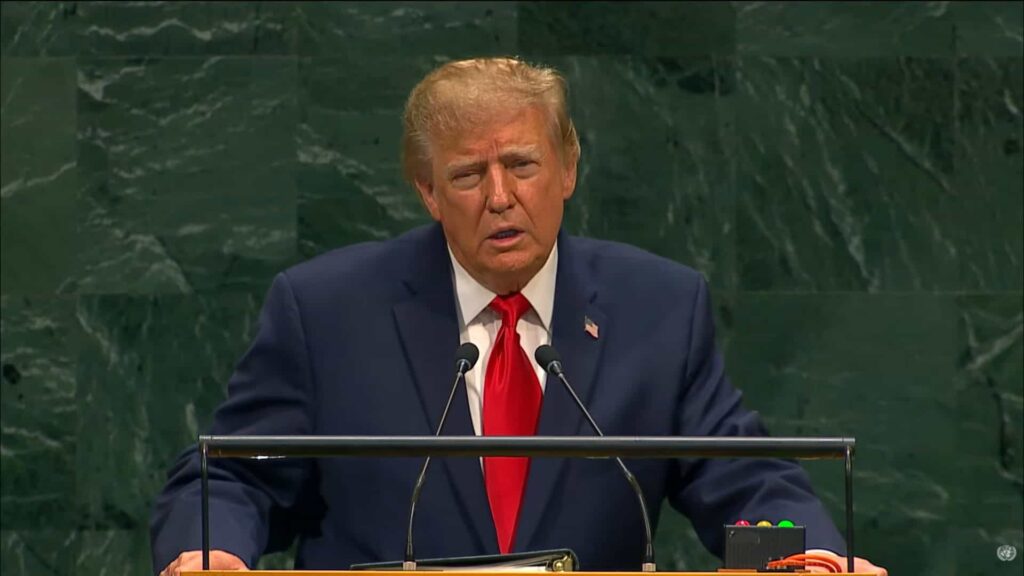
Trump quer aposentar “inteligência artificial” e adotar “superinteligência” como termo oficial do governo dos EUA. Segundo o Olhardigital.com.br, o anúncio aconteceu na 81ª Assembleia Geral da ONU, com a justificativa de que “artificial” faz a tecnologia parecer falsa. Politicamente é um movimento esperto. Tecnicamente, é puro teatro. A IA que você usa no Cursor, no Copilot ou no seu modelo local rodando num Ollama continua sendo o que sempre foi: narrow AI com branding novo.
Mas ignorar isso seria burrice. Rebranding muda orçamento, muda narrativa, muda quem financia o quê. E quem programa precisa entender o jogo, porque ele afeta diretamente os rumos da tecnologia que você consome todo dia.
O “porquê” técnico: por que “superinteligência” é mais marketing do que engenharia
Vamos separar o que existe do que é wishful thinking.
Quando você chama uma API da OpenAI, Anthropic ou Google, você está consumindo o que tecnicamente chamamos de IA fraca ou narrow AI — sistemas especializados em uma tarefa específica (gerar texto, classificar imagens, transcrever áudio). O modelo é grande, custou milhões pra treinar, mas continua burro em muitas outras coisas. Ele não aprende em tempo real. Não tem memória persistente entre chamadas (a menos que você implemente). Não raciocina no sentido humano.
Superinteligência, no sentido que Nick Bostrom definiu em 2014, é algo completamente diferente: um sistema que supera a capacidade cognitiva humana em todas as áreas relevantes — ciência, estratégia, criatividade, interação social. Não é “uma IA melhor”. É uma categoria diferente. Não existe nada parecido hoje. E nenhum lab sério afirma que estamos perto disso em horizonte de 5 anos.
Então quando o governo dos EUA troca o rótulo, ele não está descrevendo uma realidade técnica. Está criando uma frame narrativa. “Superinteligência” soa grandioso, inevitável, competitivo. “Inteligência artificial” soa… ameaçador, controlável, regulável. É disputa semântica com implicações reais em legislação e orçamento.
O que muda (e o que não muda) para quem programa
Na minha rotina como dev, três coisas vão mudar — e uma vai piorar.
O que não muda
- Seus modelos continuam sendo LLMs baseados em Transformer (ou arquiteturas derivadas como Mamba/SSM).
- As APIs que você consome continuam cobrando por token, com as mesmas limitações de contexto.
- A matemática por trás (atenção, embedding, gradient descent) segue a mesma.
O que vai mudar
- Orçamento público: verba federal dos EUA vai migrar de “AI safety” pra “SI leadership”. Projetos de pesquisa aplicada podem receber mais grana, especialmente em compute e infraestrutura.
- Export controls: restrições de chips (H100, B200) vão apertar. Se você roda workloads pesados fora dos EUA, prepare-se pra pagar mais ou aceitar performance menor.
- Narrativa de mercado: o hype em torno de “AI agents” e “AGI imminent” vai continuar inflado. Ignore o ruído e foque no que resolve seu problema hoje.
O que vai piorar
A declaração do Trump — “rejeitamos totalmente qualquer tentativa de construir um sistema global para controlar a inteligência artificial” — significa que o cenário regulatório internacional vai continuar fragmentado. Pra quem trabalha com compliance, LGPD, EU AI Act, vai ser mais um patchwork pra navegar. Na prática, isso significa que você precisa implementar guardrails no seu código, não esperar salvação de uma agência reguladora.
Na Prática: comparando o que temos com o que vendem
Deixa eu mostrar um caso real. Imagine que você precisa implementar uma feature que “entende” o contexto de uma conversa longa. Hoje, a abordagem realista é RAG (Retrieval-Augmented Generation) com um LLM. Uma “superinteligência” faria isso nativamente, sem gambiarra. Veja a diferença entre a promessa e o código real:
# Abordagem realista hoje: RAG com LLM
# Você compensa a falta de "verdadeira" memória/contextualização
# com engenharia. Muito engenharia.

from openai import OpenAI
from langchain.vectorstores import Chroma
from langchain.embeddings import OpenAIEmbeddings

client = OpenAI()
vectorstore = Chroma(
    persist_directory="./db",
    embedding_function=OpenAIEmbeddings()
)

def ask_with_context(question: str, history: list) -> str:
    # 1. Recupera contexto de uma base vetorial
    relevant_docs = vectorstore.similarity_search(question, k=3)
    context = "\n".join([doc.page_content for doc in relevant_docs])

    # 2. Monta prompt com histórico + contexto recuperado
    messages = [
        {"role": "system", "content": f"Use o contexto a seguir:\n{context}"},
        *history[-10:],  # limita nas últimas 10 mensagens
        {"role": "user", "content": question}
    ]

    # 3. Chama o LLM e reza pra ele não alucinar
    response = client.chat.completions.create(
        model="gpt-4o",
        messages=messages,
        temperature=0.3  # 0.7+ pra tarefas criativas
    )
    return response.choices[0].message.content

# Limitações reais:
# - Contexto finito (mesmo com 128k tokens, tem limite)
# - Alucina quando não sabe
# - Não aprende nada entre chamadas
# - Depende de vector store, embeddings, retrieval...
# - Tudo isso é gambiarra elegante pra simular "inteligência"
Isso é narrow AI. Resolve problemas reais? Sim, muitos. É “superinteligência”? Não. É um modelo estatístico de previsão de tokens que você orquestrou pra parecer mais inteligente do que é. A distância entre isso e uma SI é a mesma distância entre um carro a combustão e um teletransporte. Mesma categoria? Não.
Erros Comuns que devs cometem quando o hype de IA/SI sobe
Já vi gente repetir os mesmos erros toda vez que aparece um novo hype cycle. Anota esses, porque o rebranding de Trump só vai intensificar o barulho:
1. Confundir demo com produção
Aquele vídeo do agente fazendo X em 4 minutos? Rodou uma vez, com prompt selecionado a mão, sem edge cases. Em produção, a taxa de falha vai ser de 20% a 60%, dependendo da complexidade. Planeje fallback, monitore saída, e nunca, nunca, confie cego no output sem validação.
2. Subestimar custo de token
Na pressa, devs metem modelo grande pra tudo. Não faça isso. Pra classificar sentimento de um tweet, um modelo pequeno (Llama 3.1 8B, Phi-3, até um BERT fine-tunado) resolve por 1/100 do custo. Use o modelo certo pro tamanho do problema — essa é regra de ouro que pouca gente segue.
3. Ignorar latência de retrieval
Num pipeline RAG, o gargalo quase nunca é o LLM em si — é o embedding + vector search. Já otimizei sistema onde 80% do tempo de resposta vinha da busca vetorial, não da geração. Profile antes de otimizar, sempre.
3. Não versionar prompts
Prompt é código. Versione. Teste. Avalie. Trate como qualquer artefato de software. O OpenAI Evals é um bom ponto de partida pra quem não sabe por onde começar.
5. Acreditar que “superinteligência” vai resolver seu bug legado
Não vai. Sua dívida técnica, sua falta de testes, sua arquitetura mal desenhada — tudo isso continua existindo. IA/SI é ferramenta, não substituto pra engenharia de software de verdade.
O tabuleiro geopolítico que devs precisam enxergar
Trump disse: “Quem vencer a SI, vence.” É retórica de Guerra Fria adaptada pra tech. O que muda na vida do dev na prática:
- Restrições de hardware: NVIDIA H100/H200/B200 viraram ativos estratégicos. Se você precisa rodar fine-tuning pesado, o acesso ficou mais difícil e mais caro fora dos EUA. Cloud GPU spot virou luxo.
- Open source vs closed: o discurso anti-regulação favorece labs fechados (OpenAI, Anthropic) que ficam fora do lucro, e desfavorece o ecossistema open source. Llama, Mistral, Qwen continuam existindo, mas o ecossistema fica cada vez mais polarizado entre “os poucos com compute” e “o resto”.
- Talento: cientistas e engenheiros seniores de IA viraram recurso geopolítico. Vistos H-1B e green cards seletivos vão ditar quem constrói o quê em qual país.
Como dev, isso te afeta mesmo que você não esteja diretamente em IA. Se sua stack depende de uma cloud americana, de uma API americana, de um chip americano — você está exposto. Diversifique provedores, considere self-hosting com Ollama/vLLM pra workloads sensíveis.
FAQ — perguntas que devs realmente fazem
“Superinteligência” vai substituir o termo “IA” nos manuais técnicos?
Não. Em ciência da computação, “inteligência artificial” continua sendo o termo padrão. Papers, conferências (NeurIPS, ICML, AAAI), bibliotecas (PyTorch, TensorFlow, scikit-learn) seguem usando AI/ML. A mudança é governamental/burocrática, não acadêmica. Nenhum paper vai aparecer com “Superintelligence-Based Machine Learning”.
Devo me preocupar com regulação de IA no Brasil?
Sim, indiretamente. O PL 2338/2023 (Marco Legal da IA no Brasil) está em tramitação no Congresso. Mesmo que os EUA rejeite coordenação global, o Brasil pode seguir o EU AI Act como referência. Se você trabalha com produtos que vão pra Europa, estude o AI Act — ele vai entrar em vigor em fases até 2027.
Vale a pena mergulhar em “AI safety” ou “AI alignment”?
Se você é dev júnior/pleno focado em aplicar IA, não é prioridade agora. Se você quer trabalhar em labs de pesquisa (Anthropic, DeepMind, OpenAI) ou em policy tech, vale muito. Mas não é pré-requisito pra 95% dos trabalhos de IA aplicada em 2026.
Modelos open source vão morrer com essa corrida de SI?
Não vão morrer, mas vão se concentrar mais. Llama (Meta), Qwen (Alibaba), Mistral (UE) continuam fortes. O que muda é o funding gap entre open e closed aumenta. Se você roda local com Ollama/vLLLM, continue firme — a tendência é modelos pequenos ficarem cada vez mais capazes por dólar de compute.
Devo aprender a treinar modelos do zero ou só consumir API?
Depende do seu objetivo. Pra 90% dos devs, aprender a orquestrar APIs (LangChain, LlamaIndex, DSPy), fazer RAG decente, e fine-tuning com LoRA/QLoRA em modelos 7B-13B é o caminho de maior retorno. Treinar do zero exige cluster de GPUs que poucos têm acesso e não é skill mais demandada que saber usar modelos existentes com maestria.
Considerações finais
Trump pode chamar de superinteligência. Os engenheiros da NVIDIA, do Meta e do Mistral vão continuar chamando de AI/ML. Os papers vão continuar sendo aceitos em conferences de “Artificial Intelligence”. O termo é politique, não técnica.
O que importa pra você, dev, é focar no que resolve problema real: aprenda RAG bem feito, domine prompt engineering como se fosse código (porque é), entenda onde o sistema falha, e não acredite em hype que promete substituir seu cérebro por uma API.
“Superinteligência” vai existir um dia? Talvez. Mas não vai ser anunciada num discurso da ONU. Vai ser construída linha por linha, commit por commit, por gente que entende o que está fazendo — não por gente que troca rótulo pra ganhar narrativa geopolítica.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.