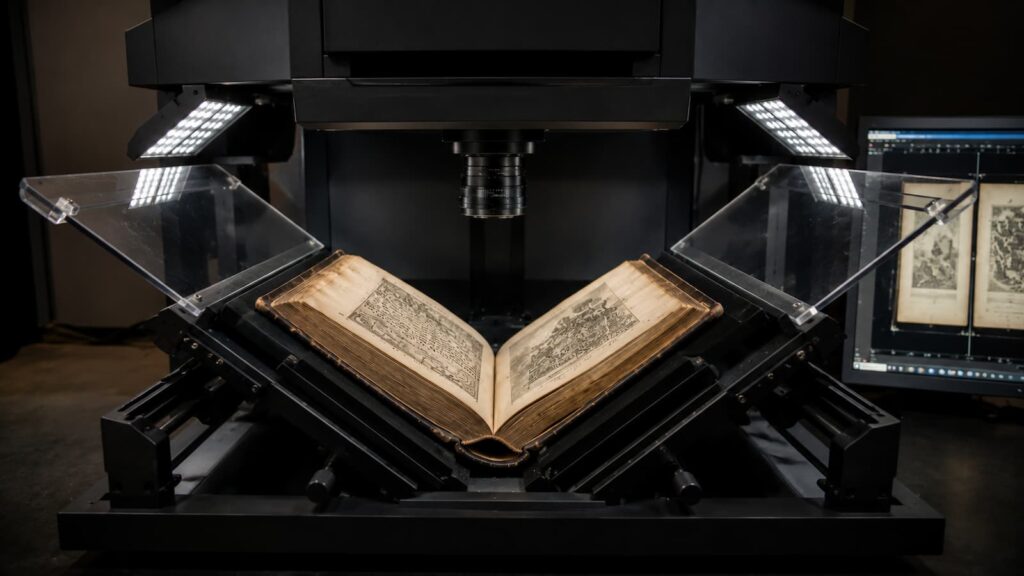
Estou acompanhando essa história desde que saiu a investigação da 404 Media, e preciso dizer: o movimento de empresas de IA comprarem livros físicos para destruir em seguida é, ao mesmo tempo, perturbador e tecnicamente revelador. Segundo o Sapo.pt, isso está acontecendo em escala industrial — e o motivo real não é o que parece à primeira vista. Vamos destrinchar o que está por trás, o que isso significa para quem trabalha com dados e modelos, e por que isso importa mesmo para quem só consome IA no dia a dia.
O problema real: estamos afundando em dados sintéticos
A corrida por dados de alta qualidade virou o gargalo número um do setor. Treinar um LLM em 2026 com o que está disponível publicamente na web é como tentar encher um copo já furado. A maior parte do conteúdo recente foi gerado por IA, e o ecossistema entrou em colapso de modelo — termo cunhado por pesquisadores da Universidade de Oxford para descrever o que acontece quando modelos são treinados em saídas de modelos anteriores.
Na minha experiência acompanhando papers e testando em produção, vejo o reflexo disso claramente: respostas cada vez mais genéricas, alucinações em cascata, perda de nuances estilísticas. Os livros representam um repositório de texto humano, editado, revisado, com coerência narrativa longa — exatamente o tipo de dado que falta nos datasets atuais.
Por que livros físicos e não PDFs disponíveis online?
A pergunta que todo dev faz: por que não piratear? Por que comprar o livro físico se já existem repositórios como LibGen, Z-Library, Anna’s Archive?
Tecnicamente, existem três razões principais:
- Risco legal menor em certas jurisdições: comprar um exemplar físico e digitalizar para uso interno ainda está numa zona cinzenta, mas é diferente de redistribuir o arquivo. Foi exatamente essa defesa que a Anthropic tentou no processo judicial citado — e o tribunal aceitou a tese de “fair use” para a digitalização, mas não para o download massivo.
- Qualidade do OCR: livros bem impressos, com tipografia profissional, dão resultados de OCR muito superiores a PDFs escaneados de baixa qualidade disponíveis online.
- Diversidade editorial: conseguir títulos raros, edições esgotadas, livros fora de catálogo. Mercados de segunda mão e intermediários permitem acesso a acervos que não estão digitalizados em nenhum lugar.
Como funciona a digitalização destrutiva na prática
O processo é brutal do ponto de vista material, mas engenhoso do ponto de vista industrial. A lombada é removida mecanicamente — basicamente uma lâmina corta o livro seccionando a cola — e cada página segue para um scanner industrial de alta velocidade, capaz de processar milhares de páginas por hora com qualidade óptica consistente.
Do lado de software, o pipeline típico envolve:
- Captura RGB de alta resolução (300-600 DPI)
- Pré-processamento: deskew, remoção de marcas d’água, binarização adaptativa
- OCR com modelos especializados (Tesseract, Kraken, ou serviços comerciais como o Google Document AI)
- Correção pós-OCR usando modelos de linguagem para reconstruir palavras mal reconhecidas
- Deduplicação e chunking para alimentar o treinamento
O exemplar físico vira lixo porque o investimento em manter warehouses com milhões de livros é proibitivo, e a informação útil já foi extraída. É a mesma lógica de uma mineradora que descarta o minério depois de extrair o metal — exceto que aqui o “minério” tem valor cultural intrínseco.
Na Prática: construindo seu próprio dataset a partir de livros
Se você quer entender na pele o que essas empresas fazem, dá para reproduzir um pipeline básico em casa. Evidentemente, use apenas livros que você possui legitimamente. O objetivo aqui é didático — entender a engenharia por trás do processo.
Setup mínimo em Python para um pipeline de OCR + limpeza:
import pytesseract
from PIL import Image, ImageEnhance, ImageFilter
import re
from pathlib import Path

def preprocess_image(img_path: str) -> Image.Image:
    """Pré-processa a página escaneada para melhorar OCR."""
    img = Image.open(img_path)

    # Conversão para grayscale
    img = img.convert('L')

    # Aumento de contraste
    enhancer = ImageEnhance.Contrast(img)
    img = enhancer.enhance(2.0)

    # Binarização adaptativa (threshold de Otsu simplificado)
    threshold = 180
    img = img.point(lambda p: 255 if p > threshold else 0)

    # Remoção de ruído
    img = img.filter(ImageFilter.MedianFilter(size=3))
    return img

def extract_text_with_confidence(img: Image.Image) -> tuple:
    """Extrai texto com score de confiança por bloco."""
    data = pytesseract.image_to_data(
        img,
        lang='por+eng',  # multilíngue
        output_type=pytesseract.Output.DICT
    )

    blocks = {}
    for i in range(len(data['text'])):
        word = data['text'][i].strip()
        conf = int(data['conf'][i])
        block_num = data['block_num'][i]

        if not word or conf < 60:
            continue

        blocks.setdefault(block_num, []).append((word, conf))

    full_text = ' '.join(
        word for block_words in blocks.values()
        for word, _ in block_words
    )

    avg_conf = sum(
        c for block in blocks.values() for _, c in block
    ) / max(sum(len(b) for b in blocks.values()), 1)

    return full_text, avg_conf

def pipeline(book_dir: str, output_path: str) -> None:
    """Pipeline completo: processa todas as páginas de um livro."""
    pages = sorted(Path(book_dir).glob('*.jpg'))
    full_book = []
    low_quality_pages = []

    for page_path in pages:
        img = preprocess_image(str(page_path))
        text, confidence = extract_text_with_confidence(img)

        if confidence < 75:
            low_quality_pages.append(page_path.name)

        # Limpeza básica: múltiplos espaços, hifens de quebra de linha
        text = re.sub(r'-\n', '', text)
        text = re.sub(r'\s+', ' ', text)
        full_book.append(text)

    Path(output_path).write_text('\n\n'.join(full_book), encoding='utf-8')

    if low_quality_pages:
        print(f"⚠️ {len(low_quality_pages)} páginas com baixa confiança:")
        print(low_quality_pages)

# Uso
if __name__ == "__main__":
    pipeline("./meu_livro/pages", "./output.txt")
Esse script é uma simplificação, mas cobre os pontos críticos: pré-processamento de imagem, OCR multilíngue, filtragem por confiança e limpeza textual. Em produção, você trocaria o Tesseract por algo mais robusto (Kraken para textos históricos, ou um modelo transformer fine-tuned para OCR) e adicionaria deduplicação via MinHash.
Erros Comuns que devs cometem ao construir datasets
Já vi muita gente tropeçar nas mesmas armadilhas. Anota aí:
- Não deduplicar antes de treinar: se seu dataset tem o mesmo parágrafo repetido 50 vezes, o modelo aprende a dar mais peso estatístico àquela formulação. MinHash ou SimHash são obrigatórios.
- Ignorar a qualidade do OCR silenciosamente: páginas com confiança menor que 70% geralmente introduzem ruído pior do que ausência de dados. Filtre agressivamente.
- Não balancear domínios: 80% de ficção científica gera um modelo viciado em prosa especulativa. Misture gêneros, épocas, idiomas.
- Esquecer do encoding: UTF-8 com BOM e Latin-1 vão te dar resultados completamente diferentes. Padronize antes de processar.
- Não versionar o dataset: se você não sabe exatamente o que estava no treinamento do modelo v1, não consegue reproduzir nada. Use DVC ou similar.
O que isso significa para o ecossistema de IA em 2026
Estamos entrando numa era estranha. O conteúdo sintético domina a web, os dados de qualidade escasseiam, e o único reservatório confiável de texto humano bem editado são livros físicos — um recurso finito. Isso explica por que empresas estão dispostas a destruir acervos para extrair informação.
As implicações para quem programa são diretas:
- Se você está construindo um produto baseado em LLM, a curadoria de dados virou diferencial competitivo — não dá para confiar em datasets genéricos pré-treinados.
- Ferramentas de data sourcing legítimo vão ganhar valor. Esperem surgir APIs especializadas em licenciamento de conteúdo para treino.
- A linha entre pirataria e mineração de dados está se redesenhando judicialmente. Quem trabalha com NLP precisa ficar atento a decisões como a do caso Anthropic.
Há um lado quase poético nisso: estamos destruindo livros para treinar máquinas a escrever como humanos. O meio desaparece para que o estilo sobreviva em forma estatística.
Comparação com alternativas de fonte de dados
Para fechar, vale situar o livro físico frente às outras opções:
| Fonte | Qualidade | Volume | Risco legal | Custo |
|---|---|---|---|---|
| Livros físicos (compra) | Alta | Médio | Médio | Alto |
| LibGen / Anna's Archive | Variável | Altíssimo | Altíssimo | Baixo |
| Common Crawl | Baixa-Média | Altíssimo | Baixo | Baixo |
| Wikipedia | Alta | Médio | Baixo | Baixo |
| arXiv / papers acadêmicos | Altíssima | Médio | Baixo | Baixo |
| Reddit / fóruns | Média | Altíssimo | Baixo | Baixo |
| Conteúdo sintético gerado | Decrescente | Ilimitado | Zero | Baixo |
Livros físicos vencem em qualidade, mas perdem em escala. É por isso que as empresas ainda complementam com Common Crawl e dados sintéticos — o livro é tempero caro, não prato principal.
Perguntas Frequentes
É ilegal comprar livros e digitalizá-los para treinar IA?
Depende da jurisdição. Nos EUA, o caso Anthropic versus autores estabeleceu que digitalizar para uso interno de treinamento tende a ser considerado fair use, mas a redistribuição do dataset não. Na UE, o cenário é mais restritivo sob o AI Act de 2024. Para uso pessoal em pesquisa, o risco é baixo. Para uso comercial em escala, consulte um advogado especializado em propriedade intelectual.
Por que não usam só OCR em PDFs já disponíveis?
PDFs disponíveis online frequentemente têm DRM, são escaneamentos de baixa qualidade, ou estão protegidos por paywall. Livros físicos dão controle total sobre qualidade da digitalização e acesso a títulos esgotados.
Dá para detectar se um modelo foi treinado com determinado livro?
Não de forma confiável. Existem técnicas de "membership inference attack" na pesquisa acadêmica, mas na prática é extremamente difícil comprovar. Modelos não memorizam texto palavra por palavra — eles aprendem padrões estatísticos.
Esse processo de destruição é novo?
Não. Google Books fez algo similar nos anos 2000. A diferença é que Google preservou os exemplais físicos em bibliotecas parceiras. A novidade agora é a destruição completa, motivada por escala e custo.
Vale a pena construir um dataset próprio a partir de livros para um projeto pessoal?
Se você tem um domínio muito específico — por exemplo, treinar um modelo em literatura jurídica brasileira — pode fazer sentido. Para uso geral, os modelos open-source já disponíveis cobrem 95% dos casos com menos dor de cabeça.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.