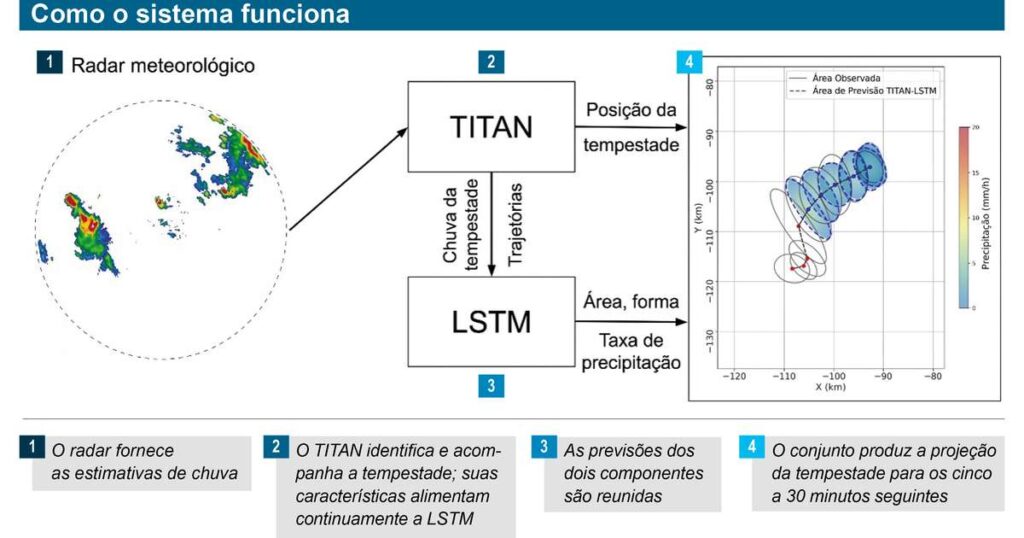
Prever a posição de uma tempestade não basta: ela pode acelerar, mudar de forma, ganhar intensidade ou se dissipar antes de chegar ao ponto indicado por uma extrapolação simples. É nesse intervalo entre rastrear o que já aconteceu e estimar o que vem a seguir que o TITAN-LSTM tenta ajudar: combina identificação de tempestades em imagens de radar com uma rede neural recorrente para atualizar previsões de curtíssimo prazo.
Segundo o Terra.com.br, que repercutiu informações da Agência FAPESP, o sistema foi desenvolvido na USP e atualiza a trajetória, a área e a intensidade da precipitação a cada cinco minutos, com horizonte de até 30 minutos. O ponto que me chama a atenção como desenvolvedor não é apenas o uso de IA: é a escolha de transformar imagens em uma sequência de características de tempestades. Essa decisão pode reduzir custo computacional e deixar o problema mais tratável.
Como o TITAN-LSTM combina radar meteorológico e inteligência artificial
O sistema une dois componentes com papéis diferentes. O TITAN — sigla em inglês para identificação, rastreamento, análise e previsão de curtíssimo prazo de tempestades — é um algoritmo clássico que identifica células de tempestade nos dados de radar e acompanha características como posição, área e intensidade ao longo do tempo.
A LSTM, por sua vez, é um tipo de rede neural recorrente projetado para aprender padrões em sequências. Ela recebe o histórico das características extraídas e estima como a tempestade pode evoluir. Em termos simples: o TITAN organiza o histórico; a LSTM aprende relações temporais dentro dele.
Essa separação importa porque uma tempestade não é um objeto rígido. Uma previsão baseada apenas na velocidade e na direção observadas pode projetar corretamente o deslocamento e ainda errar a intensidade ou a forma futura. A rede tenta aprender essas mudanças a partir da evolução anterior, em vez de assumir que a estrutura do fenômeno permanece igual.
Por que usar características da tempestade em vez de só imagens?
Uma alternativa é alimentar uma rede neural com uma sequência de imagens bidimensionais de radar. Essa abordagem mantém muitos detalhes espaciais, mas pode exigir grandes volumes de dados, preparação das imagens e mais capacidade de processamento. Também pode dificultar a interpretação do que o modelo aprendeu.
Ao trabalhar com objetos rastreados, o pipeline pode representar cada tempestade por uma sequência menor de variáveis: centro, área, intensidade e velocidade, por exemplo. Isso não significa que a representação por características seja sempre superior. Ela descarta detalhes da imagem e depende de uma boa identificação dos objetos. Se o rastreamento separar uma célula em duas ou fundir tempestades próximas, a sequência entregue à LSTM pode ficar inconsistente.
Na minha avaliação, o mérito técnico está em atacar um problema operacional com uma arquitetura relativamente enxuta. A própria fonte destaca o baixo custo computacional como uma vantagem para regiões que já têm cobertura de radar. Isso não quer dizer que o sistema dispense radares, dados confiáveis ou infraestrutura de execução: significa que a etapa de previsão pode ser menos onerosa do que algumas alternativas baseadas diretamente em imagens.
Nowcasting: previsão de curtíssimo prazo não é previsão climática
O horizonte de até 30 minutos coloca o TITAN-LSTM no campo do nowcasting, ou previsão imediata. A aplicação prática é estimar a evolução próxima da precipitação, não prever o clima de uma estação inteira nem substituir modelos meteorológicos de maior escala.
Essa diferença ajuda a definir o que medir. Para uma previsão de curtíssimo prazo, um erro de posição pode ser mais relevante para um alerta local do que um erro médio calculado sobre uma região inteira. Da mesma forma, acertar a área de chuva não garante que o modelo acertou o pico de intensidade. Uma avaliação séria precisa considerar mais de uma dimensão e comparar a previsão com observações posteriores.
Também é importante não confundir cadência de atualização com garantia de precisão. Atualizar a cada cinco minutos significa incorporar dados recentes nesse intervalo; não significa que toda previsão feita nesse ritmo estará correta. A qualidade depende dos dados do radar, da identificação das tempestades, do treinamento e das condições meteorológicas observadas.
Na Prática: como eu montaria um protótipo de previsão de trajetória
O código abaixo é um baseline didático em Python. Ele recebe posições observadas de uma tempestade em intervalos regulares, calcula a velocidade média recente e projeta o centro para os próximos passos. Não implementa TITAN, não usa LSTM e não prevê a intensidade da chuva. Serve para demonstrar uma referência simples que um modelo mais avançado deveria superar em avaliação.
Essa comparação é essencial: sem um baseline, não dá para saber se uma rede neural realmente acrescenta valor ou apenas reproduz uma extrapolação elementar. As posições estão em quilômetros em um plano local, e os registros são separados por cinco minutos.
from math import hypot

def prever_trajetoria(observacoes, intervalo_min=5, horizonte_min=30):
    """
    observacoes: lista de tuplas (x_km, y_km), da mais antiga à mais recente.
    Retorna posições projetadas usando velocidade média entre
    a primeira e a última observação.
    """
    if len(observacoes) < 2:
        raise ValueError("São necessárias pelo menos duas observações.")
    if intervalo_min <= 0 or horizonte_min <= 0:
        raise ValueError("Os intervalos devem ser positivos.")

    x0, y0 = observacoes[0]
    x1, y1 = observacoes[-1]
    minutos_observados = (len(observacoes) - 1) * intervalo_min

    vx = (x1 - x0) / minutos_observados
    vy = (y1 - y0) / minutos_observados

    previsoes = []
    for minuto in range(intervalo_min, horizonte_min + 1, intervalo_min):
        previsoes.append({
            "minuto": minuto,
            "x_km": x1 + vx * minuto,
            "y_km": y1 + vy * minuto,
            "velocidade_km_min": hypot(vx, vy),
        })

    return previsoes


historico = [(0.0, 0.0), (1.5, 0.8), (3.0, 1.6)]
for ponto in prever_trajetoria(historico):
    print(ponto)
Em um sistema real, eu não trataria latitude e longitude como coordenadas cartesianas sem conversão: distâncias e direções dependem da projeção espacial. Também precisaria definir o que fazer quando o rastreador perde uma célula, quando duas se fundem ou quando uma tempestade surge sem histórico suficiente.
- Validaria a entrada: checaria horários, unidades, falhas de radar e coordenadas fora da área monitorada.
- Construiria um baseline: compararia a previsão da rede com persistência e extrapolação de movimento.
- Separaria treino e teste por tempo: evitaria misturar observações de um mesmo evento entre os conjuntos.
- Avaliaria diferentes alvos: posição, área e intensidade devem ser analisadas separadamente.
- Exibiria incerteza: uma trajetória estimada não deve ser apresentada como certeza absoluta.
Erros comuns ao aplicar IA em previsão de chuva
- Usar divisão aleatória dos dados sem considerar o tempo. Imagens próximas do mesmo episódio podem acabar no treino e no teste, dando uma impressão exagerada de generalização. A validação deve respeitar a cronologia e, quando possível, separar eventos meteorológicos.
- Medir apenas erro médio. Uma métrica agregada pode esconder falhas importantes em tempestades intensas ou em regiões específicas. É melhor acompanhar desempenho por horizonte, intensidade e situação observada.
- Ignorar a qualidade do rastreamento. A LSTM aprende com as sequências que recebe. Se a etapa de identificação troca a identidade de uma tempestade, o modelo pode interpretar uma falha de dados como comportamento meteorológico.
- Confundir custo baixo com implantação simples. A rede é apenas uma parte do sistema. Ingestão do radar, limpeza, monitoramento, versionamento e distribuição dos alertas também precisam funcionar dentro do intervalo operacional.
- Tratar uma previsão como alerta definitivo. Para decisões que envolvem segurança, é necessário comunicar incerteza e combinar a saída do modelo com protocolos e avaliação meteorológica.
O que essa arquitetura significa para quem desenvolve sistemas de IA
O caso é útil para além da meteorologia. Ele mostra uma estratégia comum em sistemas de aprendizado de máquina: decompor um problema complexo em etapas especializadas. Primeiro, um componente extrai entidades e atributos; depois, outro aprende a evolução temporal. Essa organização pode facilitar depuração, comparação e manutenção, desde que as interfaces entre etapas sejam bem definidas.
Eu documentaria explicitamente as unidades, a frequência de amostragem, as regras de associação entre tempestades e o tratamento de dados ausentes. Também versionaria o pré-processamento junto com o modelo. Um modelo treinado com uma definição de intensidade não pode receber, em produção, valores calculados com outra convenção sem que isso seja detectado.
Outro ponto é observar o sistema depois da implantação. A distribuição dos dados pode mudar: equipamentos, cobertura, padrões de chuva e qualidade das medições não são necessariamente estáveis. Monitorar latência e falhas de entrada é importante, mas também é preciso acompanhar a qualidade das previsões conforme chegam observações posteriores. Sem esse ciclo, um modelo pode continuar funcionando tecnicamente enquanto perde utilidade na prática.
Perguntas frequentes sobre o TITAN-LSTM
O que o TITAN-LSTM prevê?
Segundo a descrição divulgada pela Agência FAPESP e reproduzida pelo Terra.com.br, ele estima a evolução de tempestades a curtíssimo prazo, acompanhando trajetória, área e intensidade da precipitação com atualizações a cada cinco minutos e horizonte de até 30 minutos.
O TITAN-LSTM substitui os radares meteorológicos?
Não. O sistema usa dados de radar. A proposta é processar essas informações com rastreamento e aprendizado de máquina, não substituir o equipamento que observa a precipitação.
Por que combinar TITAN com uma rede LSTM?
O TITAN identifica e acompanha tempestades; a LSTM modela padrões na sequência de características observadas. A combinação busca representar tanto o deslocamento quanto mudanças na evolução do fenômeno.
Uma LSTM é sempre melhor do que extrapolar o movimento?
Não. A LSTM pode aprender mudanças temporais, mas depende de dados e validação adequados. Um baseline simples pode ser mais confiável em certos cenários. A comparação precisa ser feita com dados independentes e métricas apropriadas.
Posso reproduzir o sistema com o código deste artigo?
Não. O exemplo é apenas uma extrapolação linear de posição para fins didáticos. Reproduzir o TITAN-LSTM exigiria os dados de radar, o algoritmo de identificação e rastreamento, o modelo treinado e detalhes metodológicos do estudo publicado.
O TITAN-LSTM é um exemplo interessante de IA aplicada com uma escolha arquitetural pragmática: extrair uma representação útil do radar e modelar sua evolução no tempo. Para quem desenvolve, a lição é testar contra baselines, cuidar da qualidade das sequências e não confundir uma saída do modelo com certeza operacional.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.