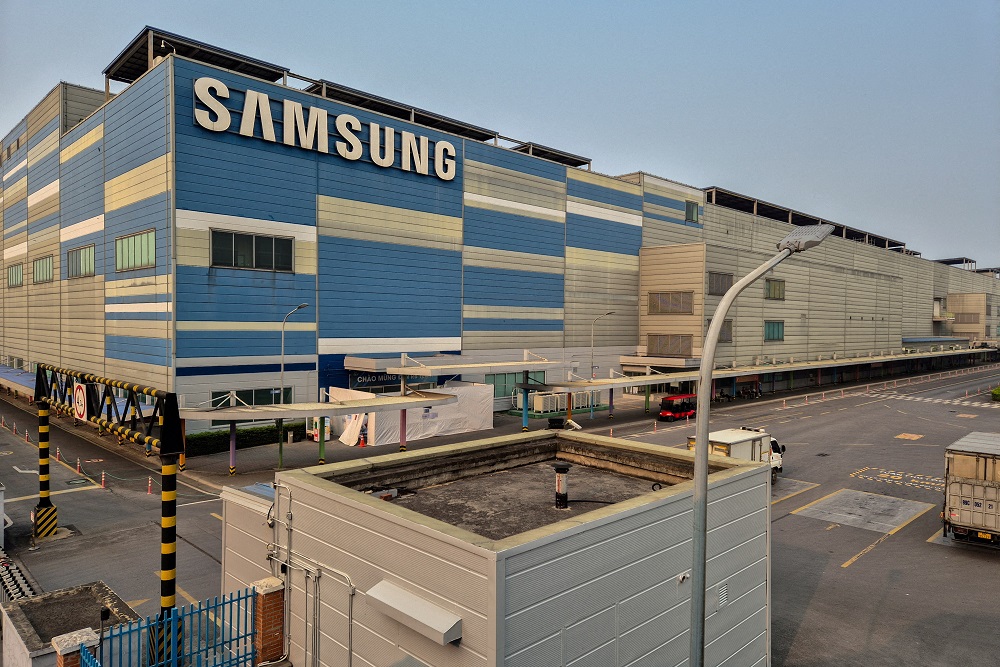
O gargalo da inteligência artificial não está apenas na quantidade de GPUs disponíveis. Está em conseguir ligar milhares delas a energia suficiente, refrigeração eficiente, redes de baixa latência e instalações prontas no prazo. É por isso que o investimento de US$ 1 bilhão da Samsung na Helix Digital Infrastructure importa: ele aponta para uma disputa por toda a infraestrutura que mantém os modelos de IA funcionando, não só pelos chips.
Segundo o InfoMoney, o aporte leva o capital já assegurado pela Helix a mais de US$ 11 bilhões. A empresa foi criada em junho por um consórcio liderado pela KKR e tem investidores-âncora como Nvidia, Kuwait Investment Authority e Vistra. O plano envolve data centers, geração de energia e transmissão — três peças que, na prática, precisam avançar juntas.
Por que um data center de IA exige mais do que GPUs
Um cluster de IA é um sistema integrado. As GPUs executam os cálculos, mas precisam trocar grandes volumes de dados entre si. Isso exige interconexões de alta velocidade, servidores, armazenamento, refrigeração e fornecimento elétrico estável. Se uma dessas camadas falha, o investimento nas demais perde valor.
Treinar um modelo distribuído, por exemplo, envolve sincronizar gradientes entre aceleradores. Se a rede não acompanha o ritmo, as GPUs passam parte do tempo esperando comunicação em vez de computar. Em inferência, o problema pode aparecer como latência alta, filas de requisições ou custo excessivo por token.
A energia também muda a escala do projeto. Uma instalação tradicional pode ter densidades de potência muito diferentes das exigidas por racks com aceleradores modernos. Não basta reservar um terreno e comprar servidores: é preciso dimensionar subestações, distribuição elétrica interna, sistemas de resfriamento e redundância para a carga prevista.
Energia, refrigeração e rede são decisões de arquitetura
Quando o consumo por rack aumenta, o resfriamento a ar pode deixar de ser suficiente ou eficiente para a configuração desejada. Soluções líquidas podem ajudar a remover calor de componentes de alta densidade, mas trazem requisitos próprios de projeto, manutenção e operação. O ponto não é escolher uma tecnologia da moda; é validar a solução para a carga térmica real e para o ambiente onde o data center será construído.
A rede merece o mesmo cuidado. Em treinamento distribuído, topologia, largura de banda e congestionamento influenciam diretamente o tempo de execução. Em serviços de inferência, a localização do data center pode afetar a latência percebida e o custo de transportar dados. Uma infraestrutura poderosa, mas distante dos usuários ou mal conectada, pode não atender ao caso de uso.
O que o investimento da Samsung sinaliza para o mercado
O aporte da Samsung é relevante como compromisso financeiro, mas não deve ser confundido com a entrega imediata de capacidade computacional. Capital assegurado não significa que os data centers já estejam construídos, energizados e operacionais. Entre financiamento e GPU disponível para uma equipe de desenvolvimento há licenciamento, obras, conexão à rede elétrica, aquisição de equipamentos e comissionamento.
A participação de investidores com competências distintas também chama atenção. A KKR traz experiência em investimentos em infraestrutura; a Nvidia está diretamente ligada ao ecossistema de aceleradores; e a Vistra atua em geração e varejo de eletricidade. Essa combinação pode facilitar a coordenação de partes do projeto, mas não elimina riscos de execução, atrasos ou mudanças na demanda.
O InfoMoney também destaca os gastos de capital de Microsoft, Amazon, Meta e Alphabet: US$ 410 bilhões no ano passado, quase o triplo do nível de 2022. O texto cita ainda uma estimativa de US$ 10,3 trilhões em investimentos em data centers e infraestrutura relacionada entre 2025 e 2032, publicada por Stijn van Nieuwerburgh na Brookings Institution. São números que ajudam a dimensionar a corrida, mas não garantem retorno para cada projeto individual.
Data center próprio, nuvem ou infraestrutura especializada?
Para quem desenvolve software, a expansão da infraestrutura pode aparecer como mais opções de GPU, novas regiões de nuvem e maior oferta de serviços gerenciados. Mas “mais capacidade” não significa automaticamente menor preço ou melhor disponibilidade. O custo depende do tipo de acelerador, da região, da demanda, do modelo de cobrança e do nível de utilização.
- Data center próprio: oferece controle sobre hardware, rede e dados, mas exige capital alto, equipe operacional e planejamento de capacidade. Faz sentido quando a demanda é previsível e grande o bastante para justificar a operação.
- Provedor de nuvem: reduz o investimento inicial e permite escalar por demanda. Em contrapartida, há custos recorrentes, possíveis limitações de disponibilidade e dependência de APIs e ferramentas do fornecedor.
- Provedor especializado em GPU: pode oferecer acesso mais direto a aceleradores e configurações específicas. É importante avaliar rede, suporte, localização dos dados, estabilidade do serviço e custo total, não apenas o preço anunciado por hora.
Na minha análise, a decisão correta começa pelo perfil da carga. Um serviço com tráfego imprevisível geralmente se beneficia de capacidade elástica. Um treinamento longo e recorrente pode justificar reservas ou contratos dedicados. Para workloads pequenos, otimizar o modelo e reduzir a quantidade de chamadas costuma dar mais resultado do que migrar entre provedores em busca de uma diferença marginal no preço da GPU.
Na Prática: estime o custo elétrico de uma carga de IA
Uma conta simples ajuda a evitar comparações incompletas entre infraestrutura própria e serviços alugados. O exemplo abaixo estima o consumo anual de energia da instalação a partir da carga de TI, da utilização média e do PUE. PUE é a razão entre a energia total consumida pelo data center e a energia usada pelos equipamentos de TI; quanto mais próximo de 1, melhor nesse indicador.
def estimar_energia_anual(
    carga_ti_kw: float,
    utilizacao_media: float,
    pue: float,
    preco_kwh: float,
    horas_ano: int = 8760,
) -> dict:
    if carga_ti_kw < 0:
        raise ValueError("A carga de TI não pode ser negativa.")
    if not 0 <= utilizacao_media <= 1:
        raise ValueError("A utilização média deve estar entre 0 e 1.")
    if pue < 1:
        raise ValueError("O PUE deve ser igual ou superior a 1.")
    if preco_kwh < 0:
        raise ValueError("O preço por kWh não pode ser negativo.")

    energia_kwh = carga_ti_kw * utilizacao_media * pue * horas_ano
    custo = energia_kwh * preco_kwh

    return {
        "energia_anual_kwh": round(energia_kwh, 2),
        "custo_anual": round(custo, 2),
    }


resultado = estimar_energia_anual(
    carga_ti_kw=500,
    utilizacao_media=0.70,
    pue=1.25,
    preco_kwh=0.12,
)

print(resultado)
Nesse exemplo, 500 kW representam a carga de TI instalada, não a potência total da instalação. A utilização média de 70% aproxima o consumo variável do uso efetivo; o PUE acrescenta energia associada a refrigeração e outras operações. O resultado é uma estimativa, não uma cotação de contrato.
Na vida real, ainda entram tarifas por demanda, impostos, redundância, perdas elétricas, custos de transmissão, períodos de baixa utilização e variação do preço da energia. Para comparar com uma oferta de nuvem, inclua também o custo da GPU, armazenamento, tráfego de rede, suporte e tempo ocioso. Energia barata, sozinha, não torna um serviço mais econômico.
Implicações para quem programa sistemas de IA
Quando a infraestrutura cresce, aumenta a tentação de resolver todo problema com mais aceleradores. Eu prefiro medir primeiro. Registre latência, throughput, utilização de GPU, tamanho de lote, taxa de erros e custo por requisição. Sem métricas, é fácil pagar por capacidade que fica parada ou confundir gargalo de rede com falta de computação.
Também vale desenhar serviços portáveis. Separe a lógica de negócio da camada que chama o modelo, centralize configurações e evite espalhar dependências de um provedor por toda a aplicação. Isso não significa abstrair tudo desde o primeiro dia: uma camada de compatibilidade mal projetada pode esconder diferenças importantes de contexto, limites de requisição e comportamento dos modelos.
Em cargas de inferência, experimente batching quando a latência permitir, quantização quando a qualidade continuar aceitável e cache para respostas repetidas ou dados estáveis. Em treinamento, acompanhe a eficiência de escalabilidade: dobrar o número de GPUs não garante reduzir o tempo pela metade. Comunicação entre nós, carregamento dos dados e sincronização podem limitar o ganho.
Erros comuns ao avaliar investimentos em data centers de IA
- Confundir capital anunciado com capacidade pronta: financiamento é uma etapa. Obras, energia, equipamentos e operação ainda precisam acontecer.
- Olhar apenas para o número de GPUs: sem largura de banda, armazenamento e refrigeração adequados, a capacidade nominal pode não se traduzir em desempenho útil.
- Ignorar utilização: uma GPU cara operando poucas horas ou com baixa ocupação pode elevar muito o custo por tarefa.
- Comparar preços sem normalizar: tipos diferentes de GPU, memória, rede, região e condições de contrato não são equivalentes.
- Assumir que toda demanda de IA será permanente: workloads, modelos e estratégias de otimização mudam. Projetos de infraestrutura precisam considerar cenários de demanda, não apenas previsões otimistas.
- Esquecer o custo de saída: mover dados entre regiões ou fornecedores pode gerar cobrança, atraso e trabalho de engenharia. Planeje a portabilidade antes de acumular dependências.
FAQ: data centers, GPUs e desenvolvimento de IA
O que a Helix Digital Infrastructure pretende construir?
Segundo o InfoMoney, a Helix pretende desenvolver uma nova geração de data centers, geração de energia e transmissão para atender à demanda de infraestrutura de IA. O investimento anunciado não significa que toda essa capacidade já esteja disponível.
O aporte de US$ 1 bilhão da Samsung reduz o preço de GPUs?
Não necessariamente. O aporte financia uma empresa de infraestrutura, mas o preço final de GPUs depende de oferta, demanda, energia, contratos e custos operacionais. Qualquer efeito sobre preços é indireto e não pode ser presumido a partir do anúncio.
Por que a energia é um gargalo para data centers de IA?
Clusters com muitos aceleradores consomem grandes volumes de eletricidade e geram calor. A infraestrutura precisa fornecer energia estável e remover esse calor, além de atender a requisitos de conexão e redundância. Construir servidores sem energia disponível não cria capacidade utilizável.
Como uma equipe pequena pode reduzir custos de IA?
Meça o custo por tarefa, escolha o modelo adequado, controle o tamanho das entradas, aplique cache quando fizer sentido e avalie batching ou quantização. Antes de contratar mais GPUs, identifique se o gargalo está em computação, rede, dados ou configuração do serviço.
O aporte da Samsung reforça uma mudança importante: a competição por IA também é uma competição por energia, instalações e conectividade. Para quem desenvolve, a consequência prática é tratar capacidade e custo como parte da arquitetura do software — medindo o uso real antes de escalar.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.