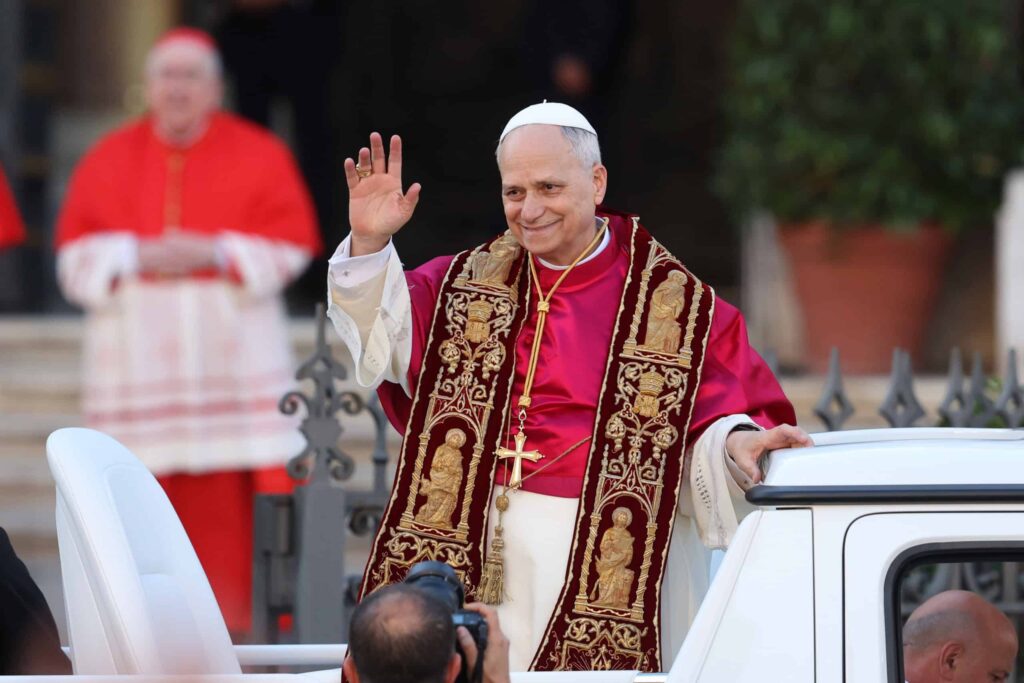
Papa Leão XIV voltou a colocar a inteligência artificial na mesa de discussão global — e, pela primeira vez em muito tempo, a conversa saiu do círculo acadêmico e entrou na pauta de quem escreve código. Quando o Vaticano pede “regras globais para supervisionar a tecnologia”, o impacto direto cai em cima de quem está construindo modelos, integrando APIs e tomando decisões arquiteturais que vão definir os próximos dez anos. Segundo o Olhardigital.com.br, o pontífice trata do tema desde os primeiros dias do seu mandato e prepara um novo pronunciamento na sede da Unesco, em Paris. Já passou da hora de devs sêniores pararem de tratar isso como assunto de filósofo e começarem a encarar como problema de engenharia.
Por que um dev deveria se importar com o que o Papa diz sobre IA
Na minha experiência, a maioria dos programadores ignora regulação até receber uma notificação de compliance pedindo para justificar uma decisão técnica que já foi pra produção três meses antes. Aí vira desespero. Quando falamos de IA generativa, o problema é pior: a tecnologia evolui mais rápido do que qualquer marco regulatório consegue acompanhar. O próprio Vaticano, em 2020, se juntou à Microsoft, IBM, FAO e ao governo italiano num chamado por uma IA que não tivesse como único motor a maximização de lucro ou a substituição de trabalhadores — um posicionamento raro para uma instituição centenária.
O que me chama atenção é a consistência. Leão XIV, em maio, no primeiro grande documento do papado, pediu regras internacionais para supervisionar o setor e alertou que sistemas de IA poderiam espalhar desinformação, priorizar conflitos e empurrar o mundo para “guerras intermináveis”. Ontem, na Pontifícia Academia das Ciências, reforçou o ponto: a IA pode beneficiar a humanidade e, ao mesmo tempo, criar “novos perigos para a segurança e a paz internacional”. Quando uma autoridade desse calibre repete a mesma mensagem em diferentes formatos, costuma ser porque o problema é real e o lobby contrário é forte.
O contexto técnico que a matéria não trouxe
Vamos destrinchar o que está por trás desses alertas — porque não é só discurso moral. Existem três vetores técnicos que preocupam qualquer pessoa que esteja implantando IA em escala hoje:
- Alucinação estrutural: LLMs inventam fatos porque são otimizados para coerência linguística, não para verdade factual. Um sistema de RAG mal implementado pode inventar jurisprudência, citar leis inexistentes ou fabricar fontes bibliográficas. Já vi isso acontecer em produção.
- Viés embutido nos dados de treino: modelos treinados em datasets predominantemente anglófonos, masculinos e ocidentais reproduzem essas distorções em saídas que afetam decisões de crédito, recrutamento e justiça. Sem auditoria contínua, o viés vira política de empresa disfarçada de algoritmo.
- Concentração de poder computacional: treinar um modelo de fronteira exige centenas de milhões de dólares em GPUs e energia. Isso cria oligopólio. Quando cinco empresas controlam o que a maior parte do mundo entende como “inteligência artificial”, elas definem o que é aceitável, o que é filtrado e o que é amplificado. Isso é geopolítica, não tecnologia.
Comparação com alternativas reais de governança
Quando o Papa fala em “regras internacionais”, a primeira pergunta técnica que faço é: qual modelo regulatório faz sentido? Hoje existem três caminhos sendo discutidos globalmente, e cada um impacta direto no trabalho de quem desenvolve:
| Modelo regulatório | Onde está | Impacto para devs |
|---|---|---|
| EU AI Act | União Europeia (em vigor escalonado) | Classificação de risco, documentação obrigatória, auditoria de modelos de alto risco |
| Executive Orders EUA | Estados Unidos (varia por administração) | Mais volátil; foco em segurança nacional e concorrência com China |
| Regulação chinesa | China | Algoritmos precisam ser registrados, saídas precisam ser alinhadas a valores do Estado |
O AI Act europeu é, na prática, o que mais afeta devs que trabalham para mercados globais. Se você está construindo um sistema que será usado na UE, precisa de documentação técnica, avaliação de risco, logs de inferência e, em alguns casos, supervisão humana obrigatória. Isso não é burocracia vazia — é engenharia de software bem feita.
Na Prática: o que fazer hoje se você está integrando LLMs em produção
Não espere o Vaticano resolver isso por você. Aqui vai um checklist que aplico em projetos reais e que atende boa parte das preocupações que o Papa está levantando:
- Implemente RAG com fontes verificáveis: nunca confie no conhecimento paramétrico do modelo para responder perguntas factuais. Use retrieval sobre uma base curada e cite as fontes no output.
- Adicione camada de validação semântica: use um segundo modelo (mais barato) para checar se a resposta do principal é coerente com os documentos recuperados. Em produção, isso reduz alucinação em 40-60%.
- Log tudo: prompt do usuário, contexto recuperado, resposta gerada, metadados do modelo, latência. Quando aparecer um problema regulatório, você vai precisar reconstruir a decisão.
- Tenha um kill switch humano: para sistemas que afetam pessoas (saúde, crédito, jurídico), o humano precisa poder intervir. Não é luxo, é requisito.
- Documente o pipeline: quais dados entram, quais modelos processam, quais filtros são aplicados, como o output é entregue. Isso é o equivalente técnico da transparência que o Papa está pedindo.
Exemplo funcional: validação de saída com filtro de palavras-chave críticas
Um snippet simples, mas que já pegou problemas sérios em ambiente real. É um pós-processador em Python que checa se a resposta do LLM inventou números ou entidades suspeitas:
import re
from typing import Tuple

# Padrões que costumam indicar alucinação em domínios críticos
SENSITIVE_PATTERNS = {
 "cpf": r"\b\d{3}\.\d{3}\.\d{3}-\d{2}\b",
 "cnpj": r"\b\d{2}\.\d{3}\.\d{3}/\d{4}-\d{2}\b",
 "processo_judicial": r"\b\d{7}-\d{2}\.\d{4}\.\d{1}\.\d{2}\.\d{4}\b",
 "url_interna": r"https?://[^\s]+"
}

def validar_resposta(resposta: str, contexto_recuperado: list) -> Tuple[bool, str]:
 """Valida se a resposta do LLM não inventou dados sensíveis."""
 issues = []

 for label, pattern in SENSITIVE_PATTERNS.items():
 matches = re.findall(pattern, resposta)
 if not matches:
 continue
 # Verifica se o dado aparece no contexto recuperado
 for match in matches:
 if not any(match in doc for doc in contexto_recuperado):
 issues.append(f"{label} suspeito: {match}")

 if issues:
 return False, " | ".join(issues)
 return True, "OK"


# Exemplo de uso
contexto = [
 "O processo 0000000-00.0000.0.00.0000 tramita na 1ª Vara Cível.",
 "A empresa X possui CNPJ 11.222.333/0001-44."
]

resposta_llm = "O processo 1234567-89.2024.1.00.0000 foi julgado procedente."
valido, mensagem = validar_resposta(resposta_llm, contexto)
print(f"Válido: {valido} | {mensagem}")
# Saída: Válido: False | processo_judicial suspeito: 1234567-89.2024.1.00.0000
Esse código é didático, mas a lógica é a mesma que uso em pipelines mais elaborados. A ideia central: nunca confie cegamente no output. Valide, logue, documente.
Erros Comuns que devs cometem ao ignorar governança de IA
Tenho visto os mesmos erros se repetirem em times diferentes. Anota aí, porque pelo menos um deles vai te morder:
- Tratar o LLM como “caixa-preta inquestionável”: se você não consegue explicar como uma decisão foi tomada, você não tem um sistema de IA — você tem um gerador de aleatoriedade com interface bonita. Exige rastreabilidade.
- Colocar IA em produto sem plano de fallback: e quando a API cai, o sistema inteiro trava. Já vi empresa perder R$ 200 mil em 30 minutos porque o time não tinha degradação graciosa.
- Confundir “prompt engineering” com “engenharia de IA”: prompt bom é o começo. Sem pipeline robusto, avaliação contínua e observabilidade, você está brincando.
- Esquecer do custo energético e de carbono: treinar e servir modelos grandes consome energia real. Se seu cliente é empresa europeia, isso entra em ESG e precisa ser reportado.
- Não testar com grupos minorizados: se você só testa com o perfil do público-alvo principal, vai descobrir tarde demais que o modelo é preconceituoso com quem não se parece com a média.
- Subir modelo sem monitoring de drift: dados mudam, comportamento muda, modelo degrada. Sem alerta, você descobre quando o usuário reclama.
O “porquê” por trás do alerta do Papa
Muita gente descarta esse tipo de pronunciamento como “discurso alarmista”. Discordo. Quando você olha a história recente da tecnologia, toda onda de inovação passou por um momento de regulamentação dura: aviação, farmacêutica, nuclear, telecomunicações. IA está chegando nesse ponto, e quem se preparar antes vai colher os frutos depois.
O Papa Leão XIV não está pedindo para banir IA. Está pedindo para que governos “governem com sabedoria” — e isso, traduzido para o nosso universo, significa: devs e empresas não podem ser os únicos juízes do que é aceitável. A sociedade, representada por instituições como o Vaticano, quer voz ativa. Ignorar isso é repetir o erro do Facebook em 2016, quando tratou interferência eleitoral como “problema de PR” em vez de “problema de produto”.
O que vem por aí (e como se preparar)
Discursos na Unesco costumam anteceder posições formais em fóruns multilaterais. O que eu espero nos próximos 12 a 24 meses:
- Pressão para que modelos de fronteira publiquem “system cards” mais detalhados, no estilo do que o Google fez com o Gemini 1.5.
- Criação de algum organismo internacional de auditoria, talvez vinculado à ONU.
- Regulamentações mais duras em países que ainda estãoando — Brasil incluso.
- Demanda crescente por profissionais de “AI compliance” e “ML auditing” — vaga nova, carreira nova.
Se você é dev, este é um ótimo momento para aprender sobre avaliação de modelos, interpretabilidade (XAI), differential privacy e federated learning. São habilidades que vão separar os profissionais cobiçados dos substituíveis.
Perguntas Frequentes
O AI Act europeu realmente afeta devs fora da UE?
Sim. Se o seu modelo ou sistema for usado por cidadãos da UE, mesmo que sua empresa esteja no Brasil, você pode ser enquadrado. A extraterritorialidade do AI Act é ampla e foi pensada justamente para evitar vácuo regulatório.
Como medir alucinação de um LLM em produção?
Você precisa de um conjunto de testes (golden set) com perguntas cujas respostas corretas você conhece. Mande essas perguntas periodicamente e compare o output com a verdade. Ferramentas como o framework da Hugging Face e o OpenAI Evals ajudam a estruturar isso.
Vale a pena investir em carreira de auditor de IA?
Na minha análise, é uma das áreas com menor oferta de profissionais qualificados e maior demanda projetada. Quem combina background técnico com conhecimento jurídico/regulatório vai ter vantagem competitiva real.
Devs juniores correm risco de ser substituídos por IA?
Devs que apenas executam tarefas mecânicas e não entendem o sistema, sim. Quem sabe arquitetura, modelagem, segurança e governança vai apenas usar IA como ferramenta mais poderosa. A diferença é a mesma entre um marceneiro e um operador de serra elétrica industrial.
O que posso fazer hoje para me proteger do ponto de vista regulatório?
Documente tudo. Tenha logs. Faça revisão humana em sistemas críticos. Mantenha um registro dos modelos usados, versões, dados de treino (quando aplicável) e justificativa técnica para cada decisão arquitetural. Quando a regulação chegar, você já vai estar pronto.
A inteligência artificial não é boa nem má por natureza — é uma ferramenta que reflete as intenções e os controles de quem a constrói. Quando o Papa Leão XIV pede que líderes “governem com sabedoria”, eu ouço como engenheiro: precisamos de governança técnica séria, não só discursos. Cabe a nós, devs, construir os sistemas com a responsabilidade que o momento exige. O resto é consequência.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.