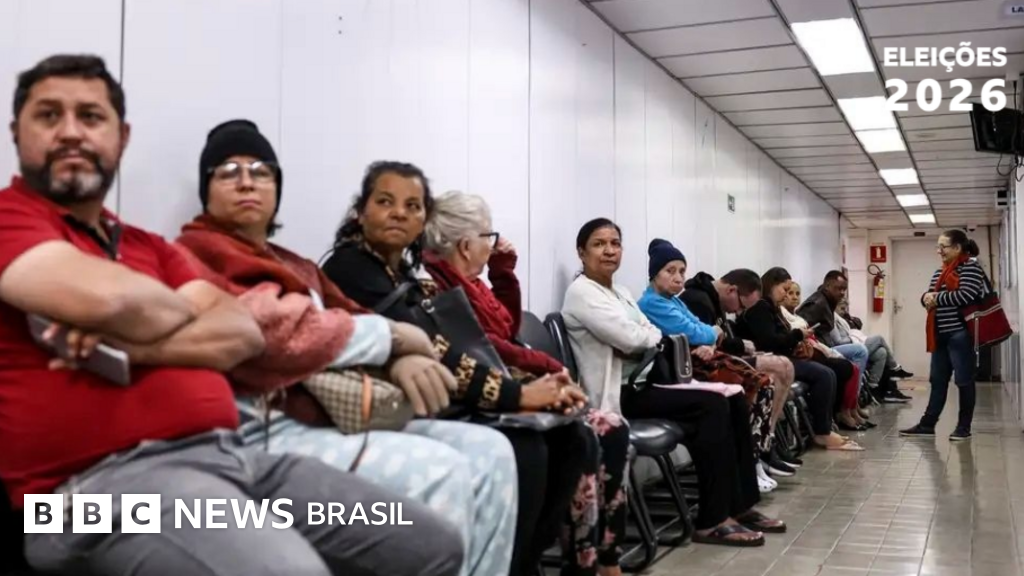
Acabei de ler a matéria da BBC News sobre as propostas dos candidatos à presidência em 2026 envolvendo IA no SUS — e, como dev, fiquei ao mesmo tempo animado e preocupado. Animado porque triagem inteligente é um problema clássico de dados que eu adoraria ver bem resolvido. Preocupado porque já vi enough sistemas “de IA” desastrosos para saber que, na saúde pública, margem de erro é sangue, não lucro perdido.
A ideia central é simples: trocar a fila por ordem de chegada — que é essencialmente um FIFO cego — por uma fila priorizada por gravidade e risco de progressão da doença. Tanto o plano do Lula quanto o do Flávio Bolsonaro mencionam isso. Mas o diabo mora no como, e é isso que nenhum plano de governo detalha. Vou descer fundo nesse “como” aqui, na visão de quem constrói esses sistemas.
Por que triagem por IA não é “só rodar um modelo”
Na minha experiência, quem chega com a ideia de “colocar IA no SUS” geralmente pensa em três etapas: pegar dados, treinar um classificador, jogar em produção. Quem já colocou modelo em produção sabe que a realidade é mais feia — especialmente quando o domínio é saúde.
O problema fundamental da triagem é que você não está só prevendo uma classe. Você está ranqueando pacientes por risco em janelas de tempo diferentes. Um paciente com dor torácica que vai infartar em 6 horas é mais urgente do que um com dor crônica que vai piorar em 6 meses. Como você codifica essa “urgência temporal” num rótulo de treino? Resposta curta: você precisa de especialistas clínicos definindo a função de custo, e isso custa dinheiro, tempo e reuniões intermináveis com o Ministério da Saúde.
O stack técnico realista para triagem no SUS
Esqueça o hype de LLM fazendo diagnóstico. Para triagem em larga escala, o caminho mais maduro combina modelos preditivos clássicos com algumas camadas de IA generativa para a interface. Vou destrinchar.
Camada 1: dados clínicos estruturados
Aqui mora o primeiro gargalo real. O SUS tem décadas de dados, mas espalhados em sistemas como o SUS Digital, e-SUS AB e DATASUS, muitos ainda em formulários parcialmente preenchidos ou em PDFs escaneados. Antes de qualquer modelo, você precisa de um pipeline de ETL robusto.
Na prática, em produção, isso vira algo assim:
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.impute import SimpleImputer

def preprocess_sus_records(df: pd.DataFrame) -> pd.DataFrame:
    """
    Normaliza registros ambulatoriais do SUS para triagem preditiva.
    Cuidado: nunca descartar NaNs sem regra clínica. Em triagem,
    ausência de dado pode ser sinal (ex.: paciente não fez exame
    porque não voltou ao posto).
    """
    # Colunas críticas para triagem
    critical_cols = [
        'idade', 'sexo', 'pressao_sistolica', 'pressao_diastolica',
        'frequencia_cardiaca', 'saturacao_o2', 'temperatura',
        'queixa_principal', 'comorbidades', 'tempo_sintomas_h'
    ]

    # Imputação por mediana para vitais
    imputer = SimpleImputer(strategy='median')
    df[['idade', 'pressao_sistolica', 'frequencia_cardiaca']] = imputer.fit_transform(
        df[['idade', 'pressao_sistolica', 'frequencia_cardiaca']]
    )

    # Feature de risco temporal — crucial para triagem
    df['risco_score_base'] = (
        (df['idade'] / 80) * 0.20 +
        (df['pressao_sistolica'] / 200) * 0.15 +
        (df['tempo_sintomas_h'] / 168) * -0.10  # quanto mais tempo, mais arriscado
    )

    return df[critical_cols + ['risco_score_base']]
Perceba o detalhe: risco_score_base considera que tempo desde o início dos sintomas aumenta o risco. Isso é uma regra clínica, não algo que o modelo descobre sozinho. Quem delega isso 100% para o algoritmo costuma errar feio.
Camada 2: modelo de priorização
Aqui é onde aparece o equívoco mais comum. Muita gente acha que precisa de uma rede neural complexa. Não precisa. Para triagem, gradient boosting (XGBoost, LightGBM) ainda é rei — e por bons motivos:
- Explicabilidade: você consegue extrair feature importance e mostrar para o médico por que aquele paciente foi priorizado. Em saúde, isso é obrigatório, não opcional.
- Velocidade de inferência: poucos milissegundos por consulta, mesmo em hardware modesto. Importante quando você atende 150 milhões de pessoas.
- Menos dado para treinar: comparado a deep learning, converge com datasets menores — o que é realista para o SUS.
Camada 3: LLM apenas para interface e NLP clínico
Aqui entra o uso legítimo de IA generativa: processar a queixa principal que veio como texto livre (“dor no peito que piora ao respirar há 3 dias”). Um modelo como o BioBERT ou um LLM local fine-tunable transforma isso em features estruturadas. Mas nunca para gerar diagnóstico final.
Na Prática: como eu implementaria um MVP de triagem
Vamos supor que você ganhou a licitação para o piloto em uma UPA de médio porte. Veja o passo a passo realista:
- Semana 1–2: mapear o fluxo atual com enfermeiros. Onde está o gargalo? Quais decisões são realmente clínicas vs. operacionais?
- Semana 3–4: extrair 12 meses de históricos da unidade (com anonimização rigorosa via LGPD).
- Semana 5–8: treinar baseline de XGBoost com labels definidos por protocolos como Manchester Triage ou NEWS2. Esses protocolos já são validados — use-os como ground truth inicial.
- Semana 9–10: rodar em shadow mode: o modelo ranqueia, mas a fila segue como antes. Você compara a ordem sugerida com a ordem real e mede concordância.
- Semana 11+: A/B test com supervisão médica obrigatória. Nenhum paciente vai ser “decidido por IA” sem enfermeiro validando.
O shadow mode é o que 90% das propostas de IA em saúde ignoram. Sem essa fase, você não tem ideia se o modelo está piorando a triagem ou melhorando.
Erros Comuns que eu já vi (e você vai cometer se não ler isso)
1. Treinar com dados de pacientes que já chegaram ao pronto-socorro
Viés de seleção brutal. Quem chega ao PS já passou por algum filtro — ônibus, distância, gravidade percebida. O modelo vai aprender a triar dentro desse subconjunto, não a triar a população que precisa. Isso é o clássico selection bias e mata qualquer sistema preditivo em saúde.
2. Confundir “acurácia” com “boa triagem”
Um modelo com 95% de acurácia pode estar errando justamente os 5% mais críticos — e ninguém percebe até o incidente virar manchete. Em triagem, as métricas que importam são sensibilidade no top-k e NDCG, não accuracy. Você quer garantir que os 10 pacientes mais urgentes do dia caiam no topo da fila, mesmo que o modelo erre casos intermediários.
3. Ignorar o “ruído” dos dados do SUS
Dados do SUS são ruidosos de verdade: profissionais sobrecarregados, abreviações, campos opcionais. Antes de qualquer modelo, você precisa de regras de qualidade de dados. Eu sempre implemento um validador assim:
def validate_vitals(row):
    """Retorna lista de flags de inconsistência."""
    flags = []
    if not (30 <= row['pressao_sistolica'] <= 300):
        flags.append('PA_SISTOLICA_IMPOSSIVEL')
    if row['frequencia_cardiaca'] > 250 or row['frequencia_cardiaca'] < 20:
        flags.append('FC_IMPOSSIVEL')
    if row['saturacao_o2'] > 100 or row['saturacao_o2'] < 50:
        flags.append('SPO2_IMPOSSIVEL')
    return flags

# Aplicar ANTES de qualquer feature engineering
df['data_quality_flags'] = df.apply(validate_vitals, axis=1)
df_clean = df[df['data_quality_flags'] == []]
4. Não ter plano de rollback
Se o sistema de triagem cair às 3h da manhã, o que acontece? Você precisa de fallback para a triagem manual em menos de 30 segundos. Parece óbvio, mas a maioria dos planos de IA em saúde que vi não menciona isso — e em produção, isso vai te derrubar.
5. Subestimar o custo de integração
O SUS roda em sistemas legados, alguns em Delphi, outros em mainframe. Integrar um modelo Python moderno com tudo isso é 60% do trabalho. Se a proposta de IA não fala em MVP de integração e em padrões como HL7 FHIR, é só slide de PowerPoint.
O que a proposta do Flávio Bolsonaro acerta (e onde vacila)
Na proposta citada pela BBC, o ponto forte é a ideia de "identificar quem corre maior risco de adoecer e chamar essa pessoa para se cuidar a tempo". Isso é razoável e tem nome técnico: preventive risk stratification. Modelos desse tipo já rodam no Reino Unido (NHS) e nos EUA, com resultados modestos mas reais em diabetes e hipertensão.
Onde a proposta vacila — e onde todas vacilam, na verdade — é em não mencionar quem audita o modelo. Quem garante que ele não está priorizando pacientes de bairros ricos porque os dados deles são mais completos? Sem comitê clínico permanente revisando viés e deriva, o sistema vira uma máquina de amplificar desigualdade. E adivinha? O SUS, que tem obrigação constitucional de equidade, não pode se dar a esse luxo.
Comparando com o que já existe fora do Brasil
Olha, antes de inventar do zero, vale olhar:
- NHS UK — NHS AI Lab: testou modelos de triagem em A&E (accident & emergency) com shadow mode por 12 meses antes de qualquer decisão clínica. É o padrão-ouro.
- Babylon Health (ruim exemplo): tentou chatbot diagnóstico direto ao paciente. Resultado? Investigação regulatória e reputação destruída. Mostra o que não fazer: IA generativa sem supervisão clínica.
- Estônia — e-Health: 99% dos registros digitalizados e um sistema nacional de triagem digital. Modelo viável para país pequeno; escala para o Brasil é outro jogo.
O Brasil tem escala continental e complexidade que nenhum desses países tem. Copiar um modelo pronto sem adaptação é receita para desastre.
O que eu faria se estivesse escrevendo o plano
Se eu fosse assessor técnico de um candidato nessa pauta, meu plano teria:
- Piloto em 5 UPAs com perfil demográfico distinto (capital, interior, periferia, Norte, Sul).
- Stack aberto (Python + XGBoost + FastAPI), código publicado para auditoria.
- Comitê clínico independente com poder de veto sobre mudanças no modelo.
- Open data anonimizado dos resultados para a comunidade acadêmica brasileira — que é forte em IA e saúde.
- Investimento pesado em infraestrutura de dados antes de modelo. Dados ruins + bom modelo = más decisões em escala.
FAQ — Perguntas que devs de verdade fariam
IA pode realmente substituir a triagem humana no SUS?
Não no curto prazo. O que é viável — e desejável — é aumentar o profissional de saúde com um sistema que sugere prioridade. A decisão final tem que ser humana, especialmente em casos ambíguos. Segundo a BBC News, as próprias propostas mencionam "auxílio" e "apoio", e é exatamente isso que a tecnologia permite hoje.
Qual o melhor algoritmo para triagem hospitalar?
Gradient boosting (XGBoost/LightGBM) pela explicabilidade e velocidade. Deep learning só justifica em imagens médicas (raio-X, retinografia). Para triagem baseada em sinais vitais e queixas, modelos mais simples ganham.
Como lidar com viés em dados médicos brasileiros?
Auditoria contínua de fairness metrics por subgrupo (raça, região, sexo). O dataset público SIM e SIH do DATASUS permite análise demográfica. Sem isso, você perpetua desigualdades históricas do sistema.
Quanto custa rodar um MVP de triagem por IA?
Para 1 UPA com 500 atendimentos/dia: estimativa realista de R$ 80–150 mil iniciais (infra, integração, 3 meses de calibração) + R$ 5–10 mil/mês de operação. É menos do que custa uma ressonância. O gargalo não é dinheiro — é governança de dados.
Quais protocolos clínicos posso usar como ground truth inicial?
Manchester Triage System, NEWS2 (para adultos), e PEWS (para pediatria). Todos validados internacionalmente e com implementação aberta. Não reinvente a roda.
Conclusão (sem enrolação)
IA no SUS é viável e potencialmente transformador — mas não é mágica, não é barato quando bem feito, e não substitui médico. As propostas que pipocaram nos planos de governo tratam isso como detalhe técnico, e é justamente o detalhe técnico que define se vira saúde pública melhor ou mais um sistema fracassado de TI.
Na minha experiência, o sucesso aqui depende menos do algoritmo e mais de três coisas chatas: governança de dados, integração com sistemas legados, e um comitê clínico com poder real. Sem isso, qualquer "IA no SUS" é só propaganda eleitoral com jargão técnico.
Se você é dev e quer se aprofundar nisso, vale olhar o repositório do NHSX AI Lab e os papers de Zerveas et al. sobre fair ML em saúde. Tem muito conteúdo aberto e aplicável ao contexto brasileiro.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto — principalmente se você trabalha com dados de saúde no Brasil.