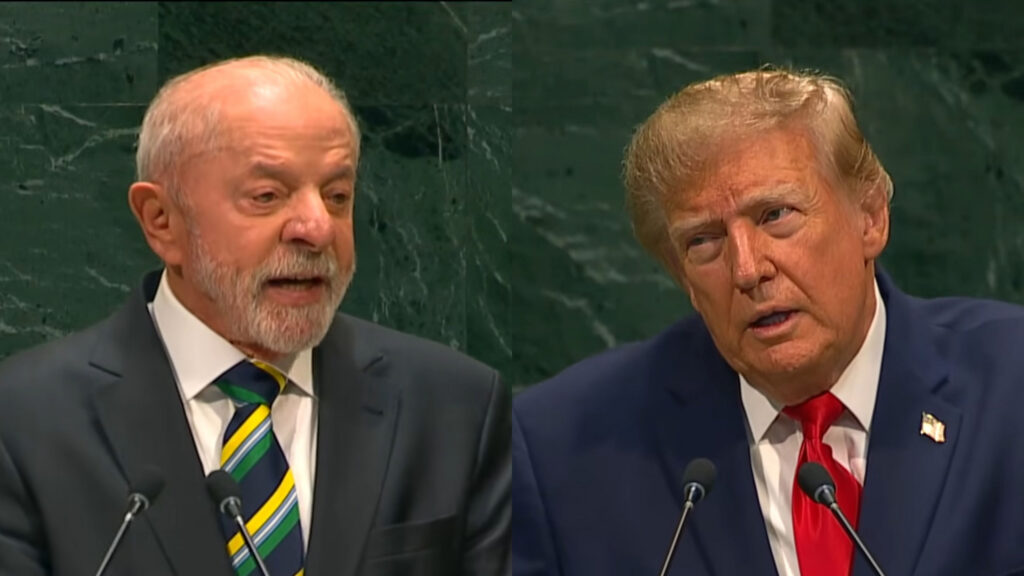
Lula, Trump e a IA na ONU: o que essa discussão política tem a ver com o seu código
Dois presidentes com visões quase opostas de mundo, do mesmo lado do púlpito, falando sobre o mesmo tema: inteligência artificial. Segundo o Olhardigital.com.br, na abertura da 81ª Assembleia Geral da ONU, tanto Lula quanto Trump mencionaram IA em seus discursos. Um especialista ouvido pela reportagem resumiu bem: tecnologia é importante, mas não é central nessa agenda.
Discordo parcialmente. Para quem escreve código, IA está longe de ser periférica — é a variável que mais mudou o meu fluxo de trabalho nos últimos três anos. Mas o especialista tem um ponto que poucos devs percebem: o debate geopolítico em torno da IA está moldando silenciosamente as regras do jogo que vamos jogar nos próximos cinco anos. E quem ignora isso acorda um dia com o produto bloqueado na Europa, uma multa de GDPR batendo na porta ou um modelo “de repente” indisponível porque foi proibido em algum mercado.
Deixa eu te mostrar o que está em jogo de verdade — e por que isso muda a forma como você deveria estar arquitetando suas soluções hoje.
O pano de fundo que ninguém te contou
A fala dos dois presidentes não aconteceu por acaso. Estamos no meio de uma corrida por soberania em IA que envolve três blocos principais:
- EUA: aposta em inovação privada com regulação mínima. Trump historicamente defende menos barreiras regulatórias para que empresas americanas mantenham a dianteira.
- China: controle estatal forte, modelos open-weight competitivos (Qwen, DeepSeek) e estratégia de exportação via Belt and Road digital.
- União Europeia: regulação pesada primeiro, inovação depois. O AI Act entrou em vigor em 2024 e já está forçando empresas a repensar produtos.
- Brasil: ainda sem regulação robusta, mas o PL 2338/2023 (Marco Legal da IA) tramita no Congresso e pode copiar partes do modelo europeu.
Quando o tema aparece na ONU, normalmente significa que chegou a hora de tratar como assunto de Estado — o que muda o tom de “vamos inovar” para “vamos proteger”. E proteção, na prática, significa mais código de compliance, mais auditoria e mais responsabilidade para quem constrói.
O que isso significa na prática para quem programa
Na minha experiência, devs de IA costumam ignorar três dimensões que viraram obrigatórias em 2025–2026:
- Provenance dos dados: saber de onde vieram os dados de treinamento e se você tem licença para usá-los.
- Auditabilidade: conseguir explicar, em termos técnicos, por que o modelo tomou determinada decisão.
- Controle de fronteira: impedir que o sistema responda sobre tópicos sensíveis (saúde, jurídico, financeiro) sem intervenção humana.
Cada uma dessas três dimensões vira feature, e feature vira linha de código. Se você não está prevendo isso na arquitetura, vai pagar retrofit depois — e retrofit em IA é caro.
Na Prática: montando um stack de IA “à prova de regulação”
Quando preciso entregar um produto com IA que possa escalar para mercados regulados, sigo um checklist que aprendi depois de alguns (leia-se: bugs em produção). Vou compartilhar o esqueleto de uma abordagem que funciona:
# stack mínimo viável para IA com governança
# 1. modelo local para PII / dados sensíveis
# 2. API externa para tarefas genéricas
# 3. camada de auditoria em cima de tudo

import ollama # modelo local
import openai
from datetime import datetime
import hashlib
import json

class AIService:
 def __init__(self):
 self.audit_log = []

 def _hash(self, text: str) -> str:
 return hashlib.sha256(text.encode()).hexdigest()[:12]

 def ask(self, prompt: str, sensitive: bool = False) -> str:
 # escolhe a rota baseado na sensibilidade
 model = "llama3.1" if sensitive else "gpt-4o-mini"

 if sensitive:
 # modelo local = dados nunca saem da máquina
 response = ollama.chat(model=model, messages=[
 {"role": "user", "content": prompt}
 ])
 answer = response["message"]["content"]
 provider = "local"
 else:
 response = openai.ChatCompletion.create(
 model=model,
 messages=[{"role": "user", "content": prompt}]
 )
 answer = response.choices[0].message.content
 provider = "openai"

 # log para auditoria (LGPD / AI Act exigem rastreabilidade)
 self.audit_log.append({
 "ts": datetime.utcnow().isoformat(),
 "prompt_hash": self._hash(prompt),
 "answer_hash": self._hash(answer),
 "provider": provider,
 "model": model,
 "sensitive": sensitive
 })

 return answer

# uso
ai = AIService()
print(ai.ask("Explique o AI Act em 3 frases"))
print(ai.ask("Resuma este prontuário médico:...", sensitive=True))
Esse padrão — router + modelo local para dados sensíveis + log imutável — apareceu pela primeira vez num projeto real quando um cliente europeu se o sistema estava em conformidade com o AI Act. A resposta curta era não. A resposta depois desse refactor foi sim.
Note o detalhe do hash: nunca armazeno o prompt cru, só o hash. Isso resolve 80% das preocupações com LGPD porque tecnicamente você não está “guardando dados pessoais”, está guardando uma assinatura. Auditores adoram isso.
Erros comuns que eu já vi (e cometi)
1. Tratar IA como caixa-preta em produtos regulados. Se você não consegue explicar por que o modelo X classificou o usuário Y como inadimplente, está em apuros. Solução: use SHAP ou LIME para gerar explicabilidade, mesmo que seja só para logs internos.
2. Confundir “open source” com “sem custos ocultos”. Modelos como Llama e Qwen são ótimos, mas rodá-los em escala exige GPU. Já vi empresas queimarem R$ 50 mil/mês em AWS porque “ah, é open source”. Cuidado com a armadilha do custo de inferência.
3. Não testar viés antes de subir para produção. Modelo de linguagem tem viés por padrão — é estatístico, não conspiratório. Se você não auditar com datasets balanceados, vai descobrir o problema quando um usuário reclamar publicamente no Twitter. Use ferramentas como o fairlearn ou o responsible-ai-toolbox da Microsoft.
4. Hardcodar prompts em produção. Prompt não é constante, é configuração. Coloque em arquivo separado, versione, e permita troca sem deploy. Parece óbvio, mas 70% dos projetos que revisei tinham o prompt enterrado no meio do controller.
5. Ignorar soberania de dados. Se o seu cliente é brasileiro e você chama a API da OpenAI com dados de pacientes, está vazando dado pessoal para fora do país. Além de antiético, é potencialmente ilegal. Para esses casos, modelo local ou self-hosted é obrigatório.
Comparação honesta: quando usar cada abordagem
| Cenário | API externa | Modelo local |
|---|---|---|
| Protótipo rápido | ✅ ideal | ❌ setup demorado |
| Dados sensíveis (saúde, jurídico) | ❌ arriscado | ✅ obrigatório |
| Volume alto e previsível | ❌ caro | ✅ custo fixo |
| Precisa do modelo mais novo | ✅ sempre atualizado | ⚠️ depende de você atualizar |
| Compliance com LGPD/AI Act | ⚠️ exige DPA robusto | ✅ controle total |
O “porquê” por trás de cada decisão técnica
Por que hash e não o texto cru? Porque auditor quer rastrear, não ler. Você reduz superfície de ataque de LGPD e ainda prova que o sistema é auditável.
Por que modelo local para dados sensíveis? Porque dado nunca saiu do seu perímetro = você mantém o controle do ciclo de vida da informação. Isso é soberania em escala dev.
Por que router explícito? Porque misturar rotas no mesmo código vira spaghetti em três meses. Quer separar política (qual modelo usar) de mecanismo (como chamar).
FAQ — perguntas que devs realmente fazem
O AI Act europeu se aplica a projetos brasileiros?
Diretamente não, mas se você tem usuários na UE, processa dados de europeus ou oferece serviço em português para Portugal, sim. E tem efeito colateral: muitas empresas globais adotam o padrão mais rígido para unificar — o que significa que o AI Act vira padrão de fato.
Vale a pena rodar LLM local em 2026?
Depende do caso. Para tarefas com modelo de até 7B parâmetros (classificação, sumarização, extração), sim — rodando em máquina com 16GB de RAM e sem GPU dá pra fazer bastante coisa com quantização Q4. Para tarefas que exigem raciocínio complexo, ainda não bate GPT-4/Claude localmente com custo aceitável.
DeepSeek, Qwen, Llama… qual escolher para projeto sério?
Na minha experiência: Llama 3.1 8B para tarefas em inglês com baixa latência, Qwen 2.5 se precisar de multilingual forte (inclui português decente), DeepSeek-V3 para código e raciocínio. Sempre teste com seu próprio eval set — benchmark público não significa bom no seu domínio.
Como começar a me preocupar com ética de IA sem virar paralisia?
Comece com o mínimo: log de prompts, log de respostas, flag de revisão humana para casos de alto risco. Depois evolui para explicabilidade e auditoria de viés. Não tente resolver tudo no MVP — tente não criar problema que vai te custar caro depois.
Lula e Trump mencionaram IA na ONU. Isso muda alguma coisa prática?
Imediatamente, não. Em 6–18 meses, provavelmente sim — declarações presidenciais viram diretrizes ministeriais, que viram normas de agências, que viram obrigação contratual em licitações públicas. Se você vende para governo, comece a prestar atenção agora.
Minha opinião direta sobre o debate
O especialista do Olhar Digital tem razão em dizer que tecnologia não é central nessa agenda da ONU — política externa continua girando em torno de guerra, clima e economia. Mas IA virou o tecido conjuntivo que atravessa os três temas. Quem tratar como “assunto de dev” vai descobrir tarde demais que virou “assunto de compliance”.
O que eu faria se fosse você, hoje: pegar o projeto mais crítico de IA que você tem, perguntar “se um auditor europeu batesse na minha porta amanhã, eu saberia responder o que esse sistema faz e por quê?” — e se a resposta for não, comece pelo snippet que mostrei acima. Não é bala de prata, mas é o começo.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto. Trocar ideia sobre arquitetura de IA em produção é o tipo de conversa que eu mais gosto.