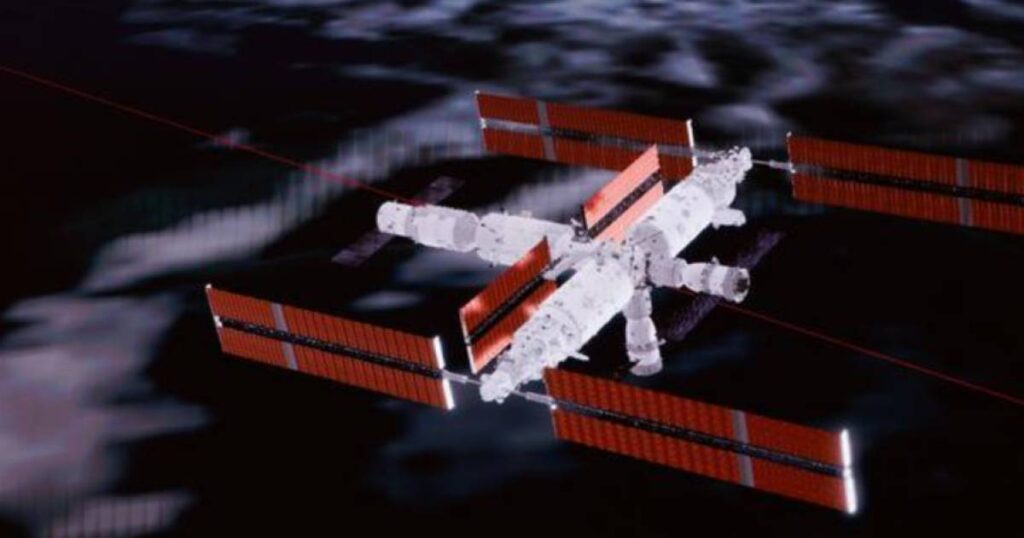
Li a matéria do Abril.com.br sobre a expansão da horta da estação espacial chinesa Tiangong e fiquei pensando em algo que pouca gente comenta: cultivar alface e tomate-cereja em órbita é, antes de tudo, um problema de engenharia de sistemas. E aqui me devo conhece bem esse tipo de stack — porque monitorar plantas em orbita guarda similaridades incômodas com manter serviços em produção: variáveis críticas, latência, redundância, telemetria e a eterna pergunta de como fechar o loop quando o “fornecedor” está a 400 km de distância.
O que a Tiangong já cultivou — e por que isso importa para quem programa
Segundo o Abril.com.br, a estação chinesa já passou mais de 20 tipos de plantas de 14 espécies pelo seu jardim orbital. Alface, cenoura, batata, trigo e até girassol. O astronauta Zhang Hongzhang, da missão Shenzhou-21, apresentou fotos e vídeos dos cultivos em uma conferência em Tianjin.
O dado mais relevante para mim não é a variedade. É o trigo completando um ciclo em órbita, com as sementes da primeira colheita sendo usadas numa segunda rodada. Isso é propagação multi-geração. Em outras palavras, isso é versionamento de “bancos vivos” — e quem já trabalhou com dados entende o peso disso: significa que o sistema está mantendo estabilidade ao longo do tempo, sem precisar de “rollback para a Terra”.
O paralelo que ninguém faz (mas devia)
Quem mantém um sistema em produção sabe o que significa não poder “rebootar do zero”. Quando você roda um cluster Kubernetes em órbita, ou um data center em um lugar remoto, a regra é clara: o que está lá precisa se manter sozinho. A Tiangong está essencialmente testando a versão orgânica desse mesmo problema.
Substrato vs aeroponia: a decisão de arquitetura
A estação usa dois tipos de equipamento. Um com substrato para as raízes, outro com aeroponia — água e nutrientes sem solo. Em maio, a agência espacial chinesa informou que a Shenzhou-21 testou cultivo aeropônico de trigo e tomate-cereja.
Na minha experiência, sempre que aparece “duas abordagens para o mesmo problema”, a pergunta certa é: qual é a mais barata de operar, qual é a mais resiliente e qual é a mais fácil de instrumentar. Aeroponia vence em quase todos esses quesitos para um ambiente espacial:
- Peso: sem substrato, menos massa para lançar. Massa é o custo mais caro em missões.
- Observabilidade: você consegue medir com sensores tudo o que entra e sai da raiz.
- Controle fino: dá para dosar nutrientes por planta, não por canteiro.
Substrato ainda tem seu lugar — quando você precisa de redundância biológica, microrganismos que auxiliam no ciclo de nutrientes. Mas se eu tivesse que escolher a stack principal para uma estação lunar, seria aeroponia com fallback para substrato. É a mesma lógica de microservices com fallback para monolith em caso de desastre.
O verdadeiro objetivo: fechar o loop de vida no espaço
Bian Qiang, do Centro de Astronautas, foi direto: o objetivo é diminuir a dependência de suprimentos da Terra. A horta ainda é complementar, mas o roadmap é claro — sistemas que reaproveitam água, ar e produzem parte da comida.
Isso é um closed-loop life support system. Traduzindo para a linguagem de quem programa: é um sistema autônomo de sem gerência externa. Você precisa de:
- Reciclagem de água (análogo a memory pooling).
- Reciclagem de ar (análogo a CO2 scrubbing, igualzinho aos filtros do seu ar-condicionado, mas com química mais agressiva).
- Produção local de comida (análogo a um build local em vez de pull do registry remoto).
A Shenzhou-23, aliás, vai testar uma estadia de um ano para um astronauta. Na minha leitura, é o equivalente a um teste de carga de longa duração — ver onde o sistema quebra quando você não pode fazer deploy de um patch.
Na Prática: como eu modelaria o monitoramento da horta orbital
Se eu tivesse que construir o sistema de telemetria de uma estufa na Tiangong, faria com Python + uma fila de eventos. Algo nessa linha:
import time
import json
from dataclasses import dataclass, asdict
from datetime import datetime, timezone

@dataclass
class TelemetryReading:
    plant_id: str
    substrate_moisture: float  # 0.0 a 1.0
    root_temp_c: float
    humidity_pct: float
    co2_ppm: int
    light_ppfd: int           # densidade de fluxo de fótons fotossintéticos
    nutrient_ph: float
    timestamp: str = ""

    def __post_init__(self):
        if not self.timestamp:
            self.timestamp = datetime.now(timezone.utc).isoformat()

# Limites calibrados para cultivo aeropônico orbital
LIMITS = {
    "substrate_moisture": (0.35, 0.65),
    "root_temp_c":       (18.0, 26.0),
    "humidity_pct":       (55.0, 80.0),
    "co2_ppm":            (800, 1500),
    "light_ppfd":         (200, 600),
    "nutrient_ph":        (5.5, 6.5),
}

def check_alert(reading: TelemetryReading) -> list[str]:
    alerts = []
    for key, (lo, hi) in LIMITS.items():
        value = getattr(reading, key)
        if value < lo or value > hi:
            alerts.append(f"{key}={value} fora de [{lo}, {hi}]")
    return alerts

def emit(reading: TelemetryReading, sink) -> None:
    payload = asdict(reading)
    alerts = check_alert(reading)
    if alerts:
        payload["alerts"] = alerts
        # Em produção: alerta via canal prioritário para o painel da estação
    sink(payload)

# Exemplo de leitura vinda dos sensores da estufa
if __name__ == "__main__":
    reading = TelemetryReading(
        plant_id="wheat-A03",
        substrate_moisture=0.72,   # alto demais — possível entupimento do gotejador
        root_temp_c=24.3,
        humidity_pct=68.0,
        co2_ppm=1200,
        light_ppfd=420,
        nutrient_ph=5.9,
    )
    emit(reading, lambda d: print(json.dumps(d, indent=2)))
O script acima é esquemático, mas mostra o essencial: cada leitura vira um evento com timestamp em UTC, passa por um validador que compara com limites operacionais e dispara alertas quando algo sai da faixa. Em órbita, sem alguém para “olhar”, esse é o único caminho viável. É exatamente a mesma lógica de um sistema de alertas no Prometheus ou no Datadog — só que o que está em risco não é uma conversão de checkout, é a colheita.
O próximo passo: modelagem preditiva
Com histórico suficiente, dá para treinar um modelo simples para antecipar desvios. Na minha experiência, um regressor leve (XGBoost ou até uma rede neural rasa) já resolve quando você tem leituras estáveis. O ponto é nunca colocar um modelo “caixa-preta” em cadeia crítica de missão — sempre com fallback para regras duras. Igual em deploys: Canary + rollback automático.
Erros que eu evitaria se estivesse projetando isso
Baseado em anos vendo sistemas darem errado, lista do que costuma derrubar projetos parecidos:
- Centralizar controle demais. Se todo cultivo depende de um único controlador, você tem um single point of failure. Em órbita não tem como pedir suporte.
- Ignorar o ciclo de luz. LED com espectro errado mata produtividade. Já vi gente otimizar tudo e esquecer a fotossíntese — em software é a mesma coisa: você ajusta backend, banco, cache, e o gargalo é o DNS.
- Subestimar dimensionar a água. Sistemas aeropônicos entopem. Em gravidade zero, o comportamento da água é outro — ela forma gotas esféricas. O filtro tem que ser pensado para isso.
- Coletar dados sem plano de uso. Telemetria sem alertas e sem modelo é só conta de storage. Quem já pagou fatura de S3 sabe.
- Esquecer a parte humana. O astronauta precisa entender o sistema sem ser botânico. UI ruim em órbita é bug em produção com P0 às 3h da manhã.
FAQ — o que um dev provavelmente perguntaria
Por que cultivar plantas no espaço se dá para levar comida pronta?
Porque massa e reabastecimento custam caro. Cada kg lançado em órbita tem um custo absurdo, e missões longas para a Lua ou Marte não têm logística de ida-e-volta. É a mesma em, em que ninguém quer ser refém de fornecedor único que pode cair.
O que a aeroponia tem de especial para o espaço?
Ela remove o substrato, o que reduz massa e permite controle fino da nutrição por sensor. Também elimina o risco de microrganismos indesejados no solo — em ambiente fechado isso é crítico.
Como o trigo completar um ciclo em órbita muda alguma coisa?
Significa que a planta consegue se reproduzir fora da Terra sem degenerar. É a prova de conceito de que dá para pensar em colheitas sucessivas, não só em “plantar e comer”. Em software, é a diferença entre um hotfix e um pipeline que se sustenta sozinho.
Tem código aberto ou API oficial desses experimentos?
Não vi nada público até agora. O lado bom é que NASA, ESA e agora a China publicam papers com dados suficientes para quem quiser simular. Quem quiser brincar pode começar modelando em Python como o anterior, com dados sintéticos baseados em faixas operacionais publicadas.
O que isso tem a ver com desenvolvimento web e IA?
Tudo. Sistemas fechados como esses são compostos por telemetria, controle, dashboards, modelos de machine learning e, cada vez mais, agentes autônomos otimizando recursos. É um caso de uso riquíssimo para estudar arquitetura resiliente, edge computing e IA embarcada em hardware limitado.
Na minha leitura, o que a China está testando na Tiangong não é só biologia — é a operacionalidade de uma colônia fora da Terra. E isso, no fim das contas, é um problema de software tanto quanto de agronomia.
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.